from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
## 1.0 Introduction
Les bibliothèques modernes ont rationalisé la création de PDF. Lors du choix d'une bibliothèque pour des projets PDF, considérez les capacités de construction, de lecture et de conversion pour une intégration et des performances optimales. Python offre des outils comme IronPDF qui peuvent analyser efficacement les PDF existants.
## 2.0 IronPDF
Python est un langage de programmation qui permet aux développeurs de créer rapidement et facilement des interfaces graphiques. Il offre un plus grand dynamisme aux programmeurs par rapport à d'autres langages. Par conséquent, intégrer la bibliothèque IronPDF avec Python est un processus simple.
Pour créer rapidement et en toute sécurité une interface graphique pleinement fonctionnelle, les développeurs peuvent utiliser plusieurs outils préinstallés, y compris PyQt, wxWidgets, Kivy, et de nombreux autres packages et bibliothèques. Il convient de noter qu'IronPDF n'est pas une bibliothèque PDF Python pur; au lieu de cela, il permet l'inclusion de diverses fonctionnalités d'autres frameworks comme .NET Core.
IronPDF simplifie la conception et le développement web Python, en particulier grâce à la popularité des paradigmes de développement Python tels que Django, Flask et Pyramid. Des sites web et services en ligne notables, y compris Reddit, Mozilla et Spotify, ont utilisé ces frameworks. Vous pouvez en apprendre davantage sur Python dans IronPDF sur le [site IronPDF for Python](/python/).
### 2.1 Fonctionnalités d'IronPDF
* IronPDF est capable de [générer des fichiers PDF](/python/how-to/python-create-pdf/) à partir de diverses sources, y compris HTML, HTML5, ASPX, et Razor/MVC View. Il offre des fonctionnalités pour créer des PDF à partir de pages HTML et d'images.
* L'outil IronPDF propose une gamme d'outils pour des tâches telles que la création de PDF interactifs, [le remplissage et la soumission de formulaires interactifs](/python/examples/form-data/), [la division](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial/) et la [fusion](/python/how-to/python-merge-pdf/) de fichiers PDF, [l'extraction de texte et d'images](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial/) des fichiers PDF, la recherche de certains mots dans un fichier PDF, [rasteriser les pages PDF en images](/python/examples/rasterize-a-pdf-to-images/), convertir le PDF en HTML.
* Avec le support pour les user-agents, les proxies, les cookies, les headers HTTP, et les variables de forme, IronPDF permet la validation de formulaires de connexion HTML.
* [L'accès aux documents protégés](/python/examples/security-and-metadata/) dans IronPDF est accordé par l'utilisation de noms d'utilisateur et de mots de passe.
* IronPDF aide à générer des fichiers PDF et à [imprimer](/python/how-to/python-print-pdf/) avec juste quelques lignes de code à partir de diverses sources comme des chaînes de caractères, des flux, des URLs, etc.
## 3.0 Configuration de Python
### 3.1 Configuration de l'environnement
Assurez-vous que Python est installé sur votre PC. Visitez le [site officiel de Python](https://www.python.org/downloads/) pour télécharger et installer la dernière version de Python adaptée à votre système d'exploitation. Une fois Python installé, configurez un environnement virtuel pour isoler les dépendances de votre projet. Utilisez le module "venv" pour créer et gérer des environnements virtuels, offrant à votre projet de conversion un espace de travail propre et indépendant.
### 3.2 Nouveau projet dans PyCharm
Nous allons utiliser PyCharm, un IDE pour écrire du code Python, pour cette démonstration.
Cliquez sur "New Project" après le lancement de PyCharm.
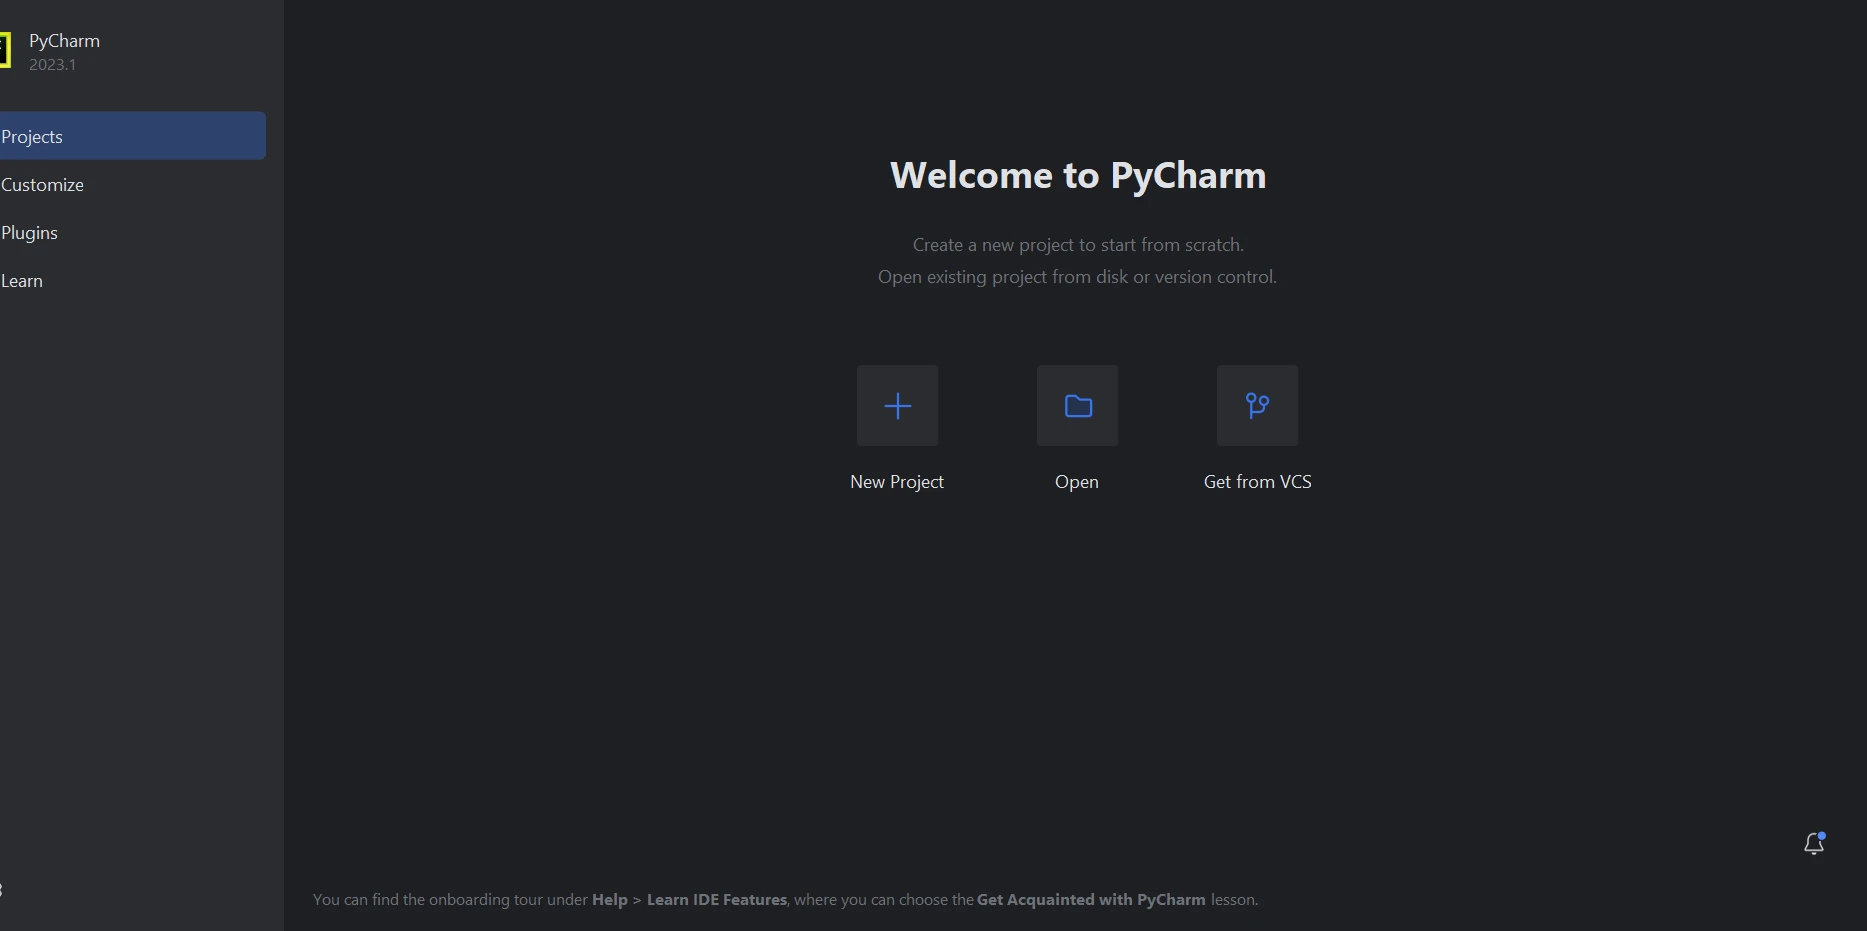
**L'écran d'accueil de PyCharm**
Lorsque vous sélectionnez "New Project", une nouvelle fenêtre apparaîtra, vous permettant de spécifier l'emplacement du projet et son environnement. Cette nouvelle fenêtre peut être vue dans la capture d'écran ci-dessous.
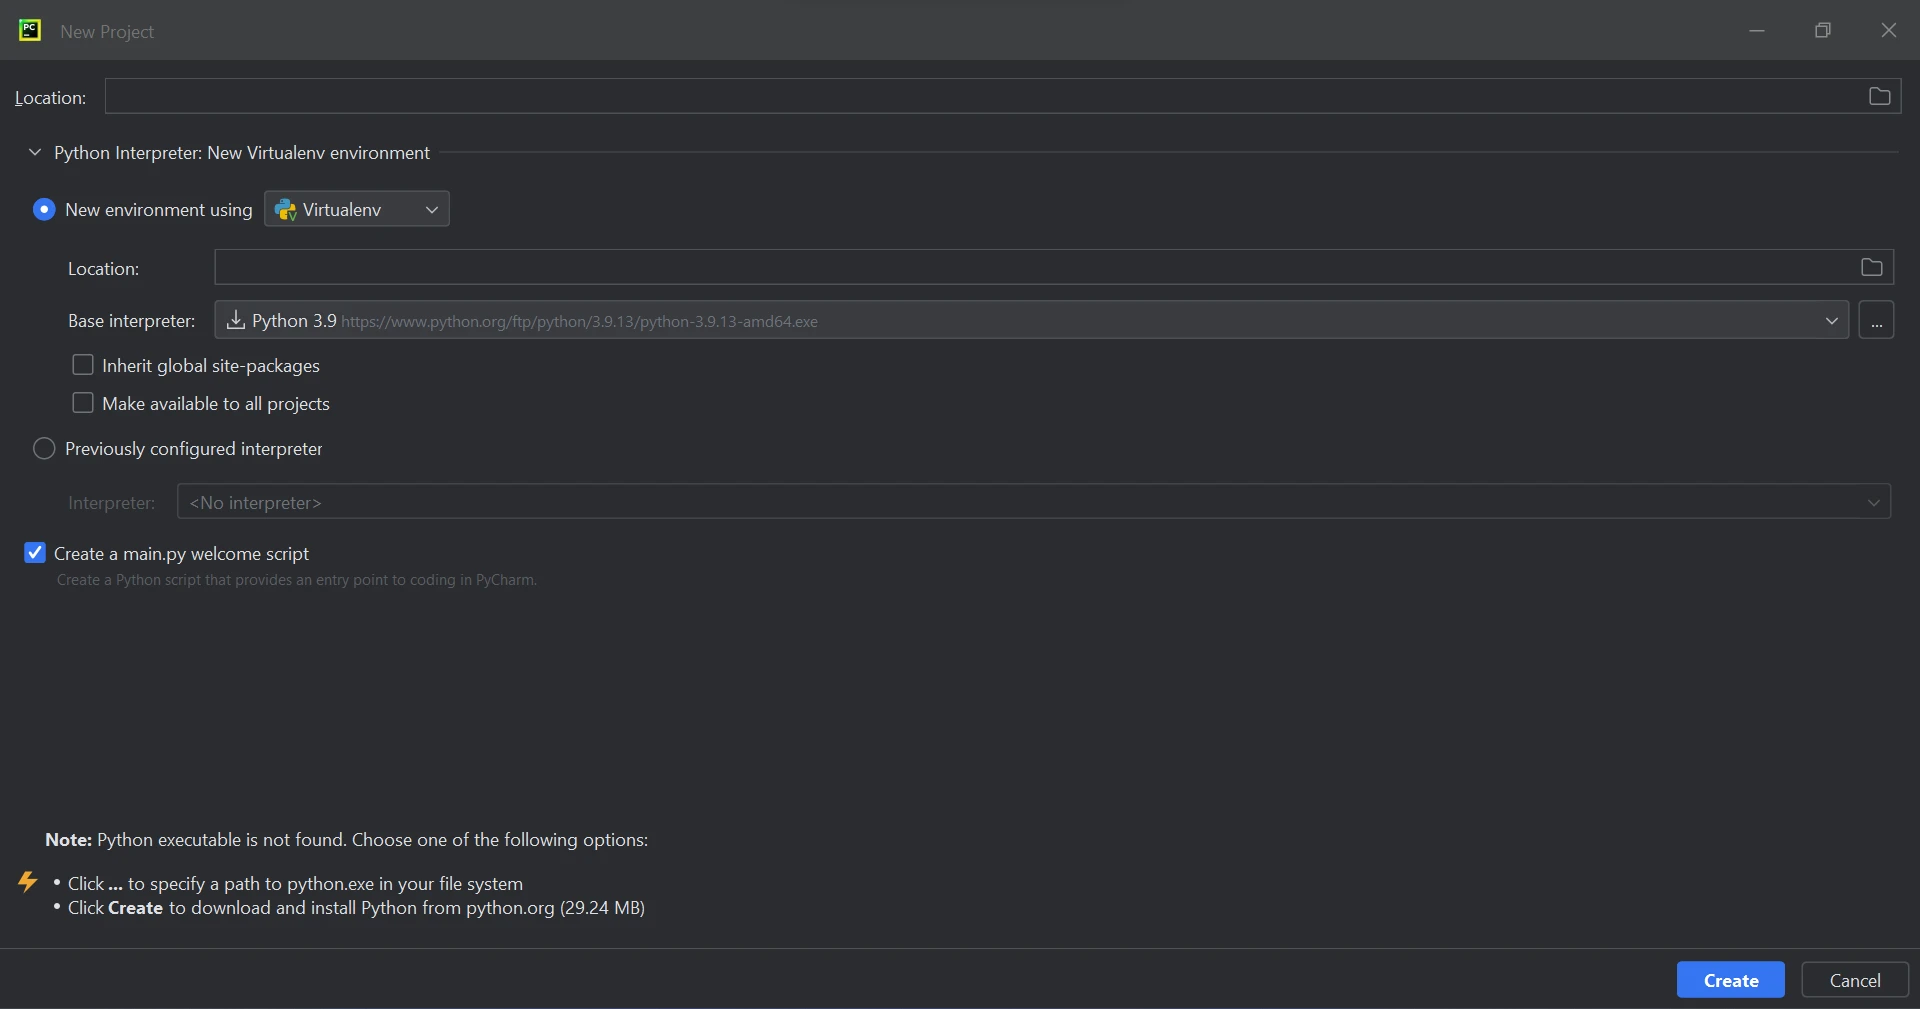
**L'écran du nouveau projet dans PyCharm**
Cliquez sur le bouton **Create** pour commencer un nouveau projet, après avoir défini l'emplacement du projet et le chemin de l'environnement. Cela ouvrira une nouvelle fenêtre où le programme pourra être développé. Ce tutoriel recommande Python 3.9.
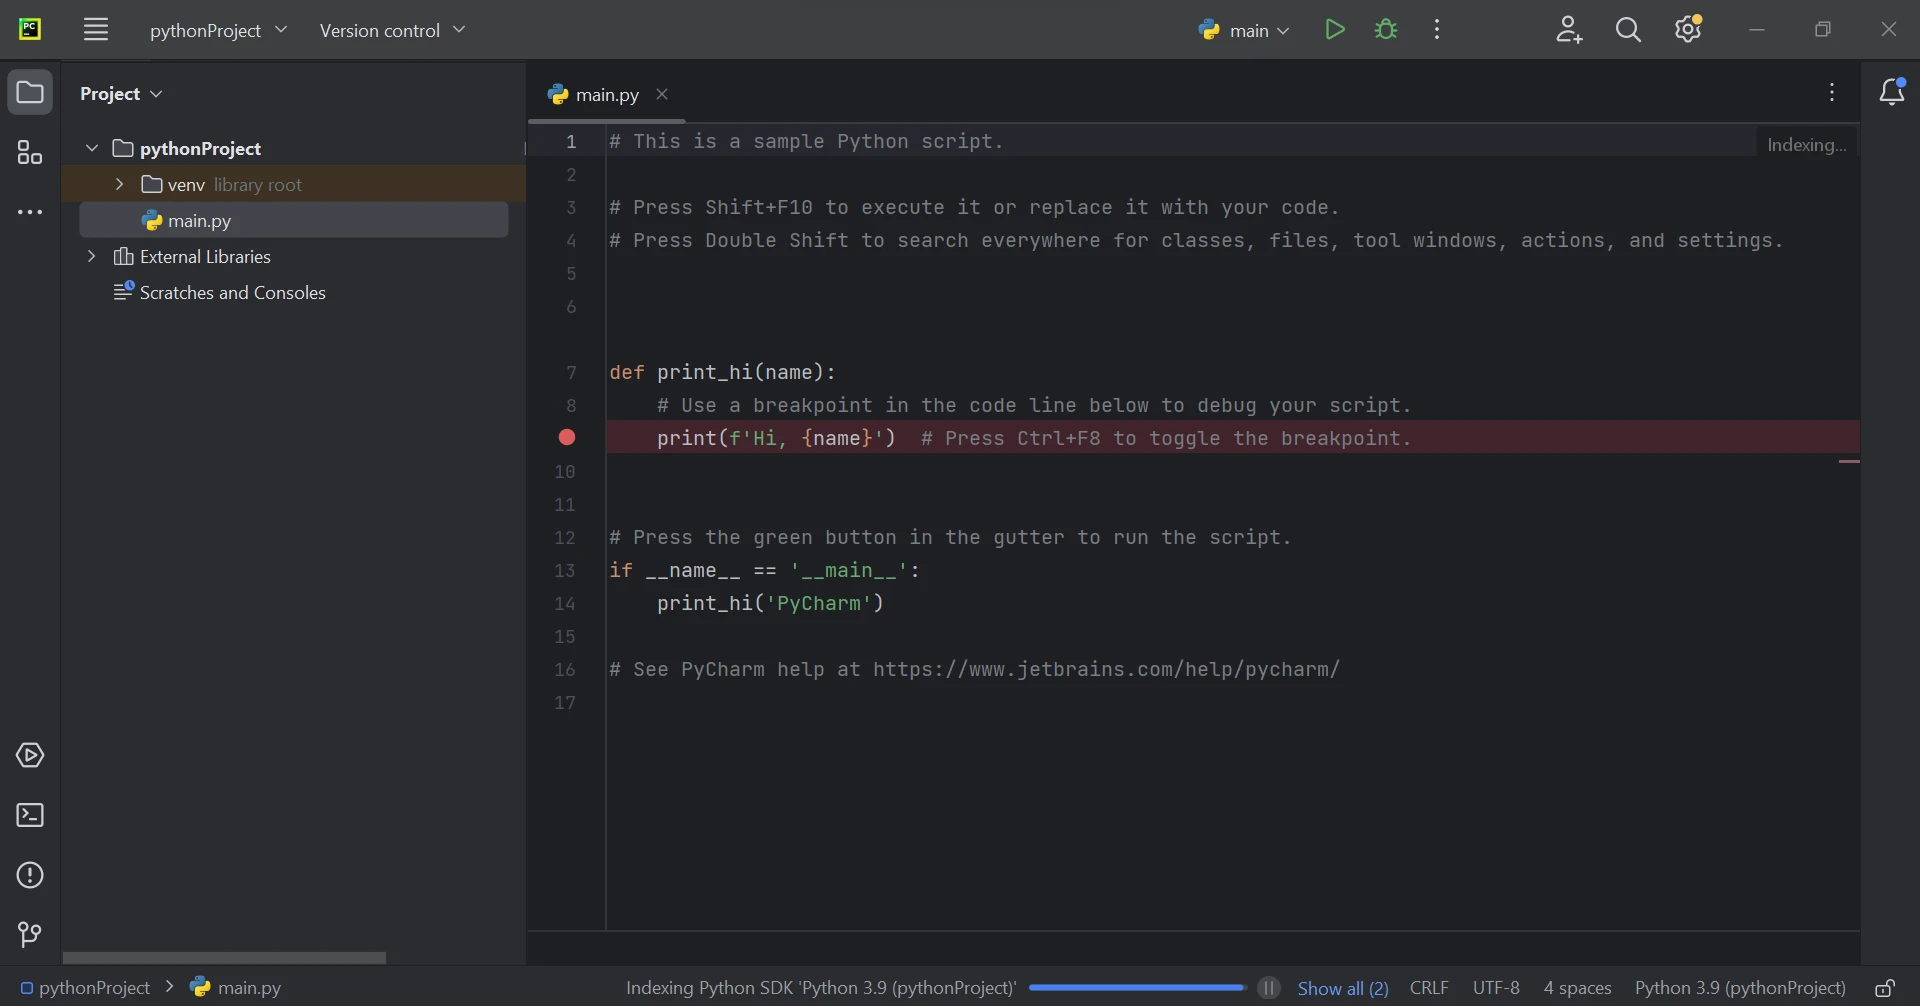
**Un fichier principal ouvert dans PyCharm**
### 3.3 Exigence de la bibliothèque IronPDF
IronPDF, une bibliothèque Python, repose principalement sur .NET 6.0. Par conséquent, pour utiliser IronPDF for Python, votre PC doit avoir le runtime .NET 6.0 installé. Avant que les utilisateurs Linux et Mac puissent utiliser ce module Python, .NET pourrait avoir besoin d'être installé. Vous pouvez obtenir l'environnement runtime requis sur le [site .NET](https://dotnet.microsoft.com/en-us/download/dotnet/6.0).
### 3.4 Configuration de la bibliothèque IronPDF
Le package "IronPDF" doit être installé pour créer, modifier et ouvrir des fichiers avec l'extension ".pdf". Pour installer le package dans PyCharm, ouvrez une fenêtre de terminal et tapez la commande suivante :
```bash
:ProductInstall
```
La capture d'écran ci-dessous montre la configuration du package 'IronPDF'.
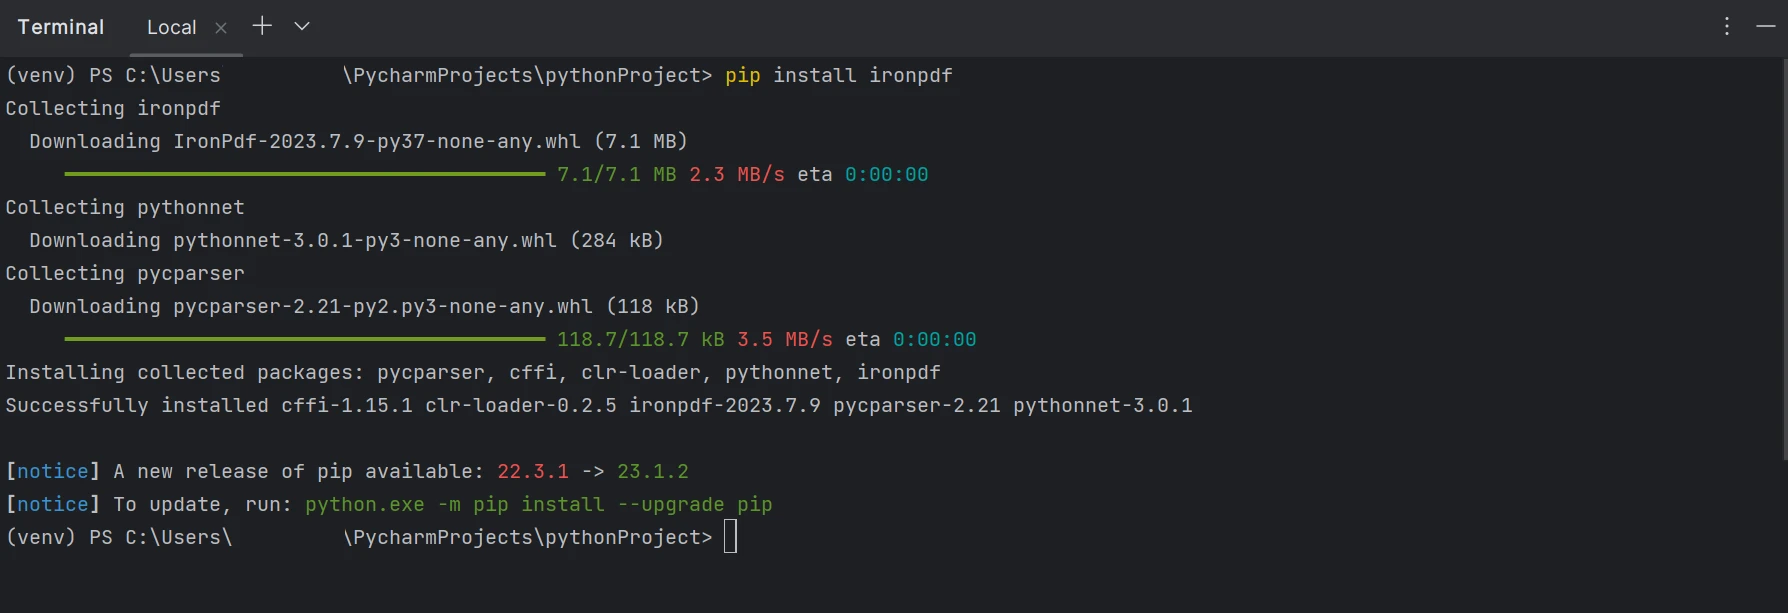
**Un terminal montrant l'installation d'IronPDF à l'aide de pip**
### 4.0 Analyse du PDF avec IronPDF
Grâce aux bibliothèques IronPDF, il est possible d'extraire du texte des fichiers PDF. IronPDF fournit diverses techniques pour l'extraction de texte. La première approche consiste à récupérer tout le contenu de la page comme une seule chaîne de caractères. La deuxième approche consiste à lire le contenu page par page, à partir de la première page. L'exemple de code suivant montre un schéma pour inspecter les fichiers PDF actuels avec IronPDF.
Il existe deux méthodes disponibles pour extraire des données d'un PDF :
1. Extraire à partir du PDF par page.
2. Extraire le PDF entier sous forme de texte.
Ci-dessous se trouve le fichier PDF que nous allons utiliser pour cet article. Il a deux pages.
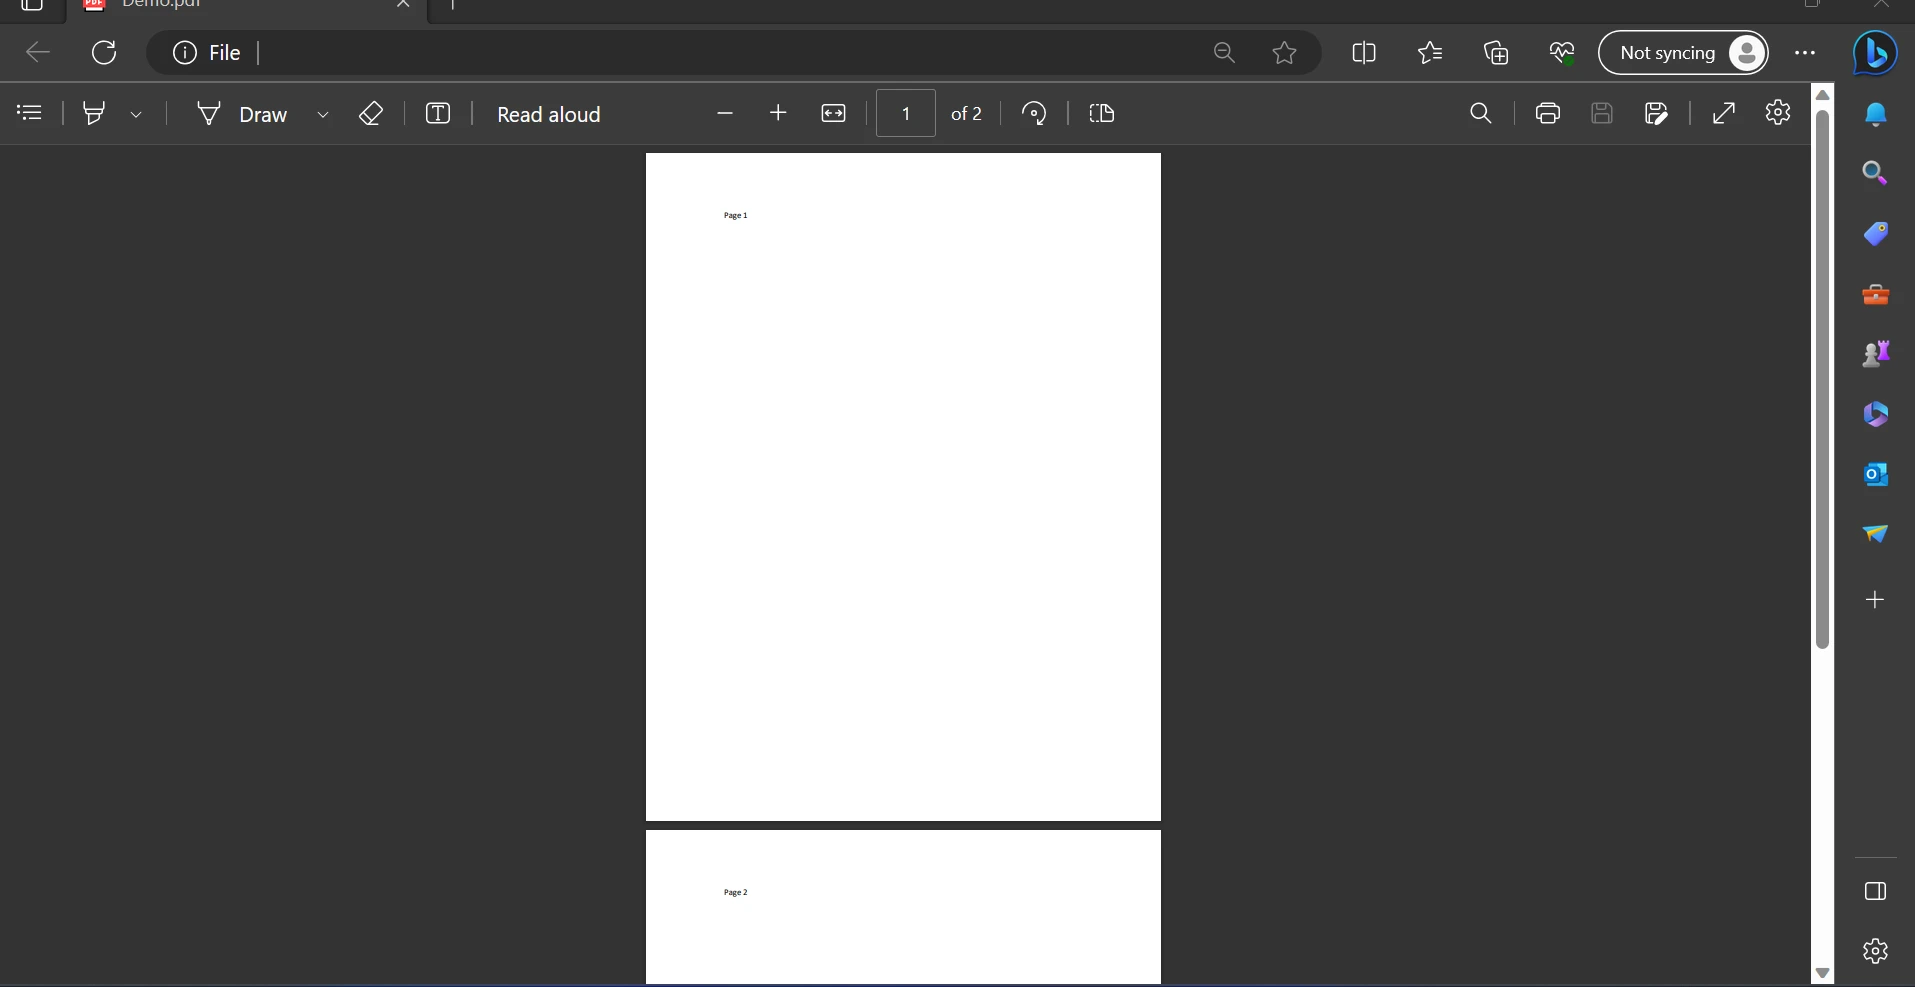
**Un PDF avec le numéro de page en haut de chaque page**
#### 4.0.1 EXTRACTION DE TEXTE PAR PAGES
Le code d'exemple fourni ci-dessous montre comment utiliser le numéro de page pour récupérer des données d'un fichier PDF.
```python
from ironpdf import PdfDocument

# Open a PDF file and create a PDF document object
pdfDocument = PdfDocument.FromFile("F:\\PDF\\1.pdf")

# Extract text from the first page (index 0)
AllText = pdfDocument.ExtractTextFromPage(0)

# Print the extracted text from the first page
print(AllText)
```
L'extrait de code montre l'utilisation de la fonction `FromFile` pour lire un fichier PDF et créer un objet document PDF. Cet objet permet d'accéder aux textes et aux images présents dans le PDF. Pour extraire le texte d'une page particulière, la méthode `ExtractTextFromPage` peut être utilisée en fournissant le numéro de la page en tant que paramètre. Cette méthode renverra une chaîne contenant tous les mots de la page spécifiée. Le résultat s'affichera comme suit.
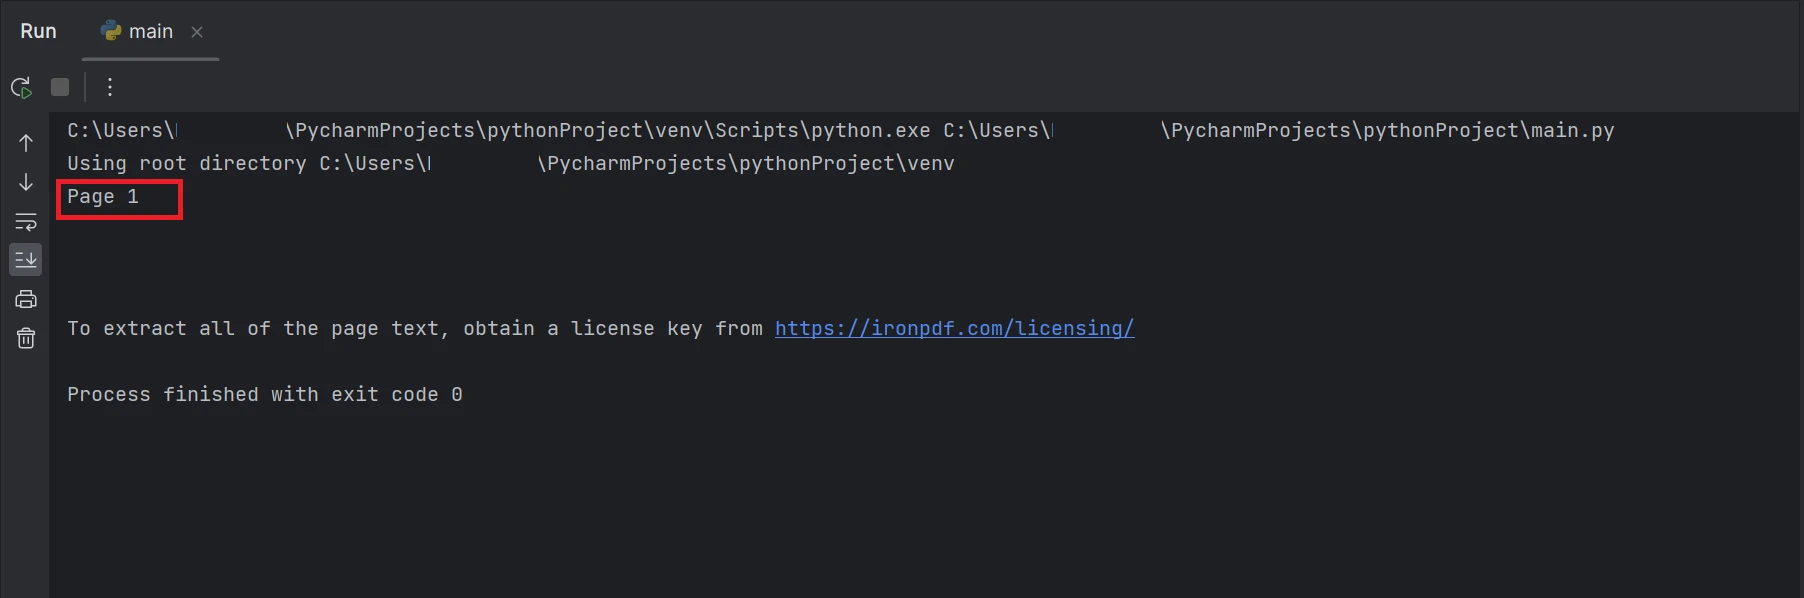
**Une capture d'écran du terminal avec le texte de sortie "Page 1"**
La boîte rectangulaire qui est mise en évidence dans le résultat est le texte extrait du fichier PDF de la page numéro 1, qui a l'index 0.
#### 4.0.2 EXTRAIRE DE TOUTES LES PAGES
La première approche pour obtenir rapidement et facilement tout le contenu du PDF sous forme de chaîne est montrée dans l'exemple de code qui suit.
```python
from ironpdf import PdfDocument
# Create a PDF file object from the file path
pdf = PdfDocument.FromFile('F:\\PDF\\1.pdf')
# Extract all text from the entire PDF
all_text = pdf.ExtractAllText()
# Print the extracted text from the entire PDF
print(all_text)
```
Le code exemple montré ci-dessus explique comment lire un PDF à partir d'un chemin de fichier existant et le transformer en un objet fichier PDF en utilisant la fonction `FromFile`. Le texte brut du PDF sera extrait et converti en chaîne à l'aide de la fonction `ExtractAllText` de l'objet, et le texte extrait sera affiché sur le terminal. Le résultat sera présenté comme suit.
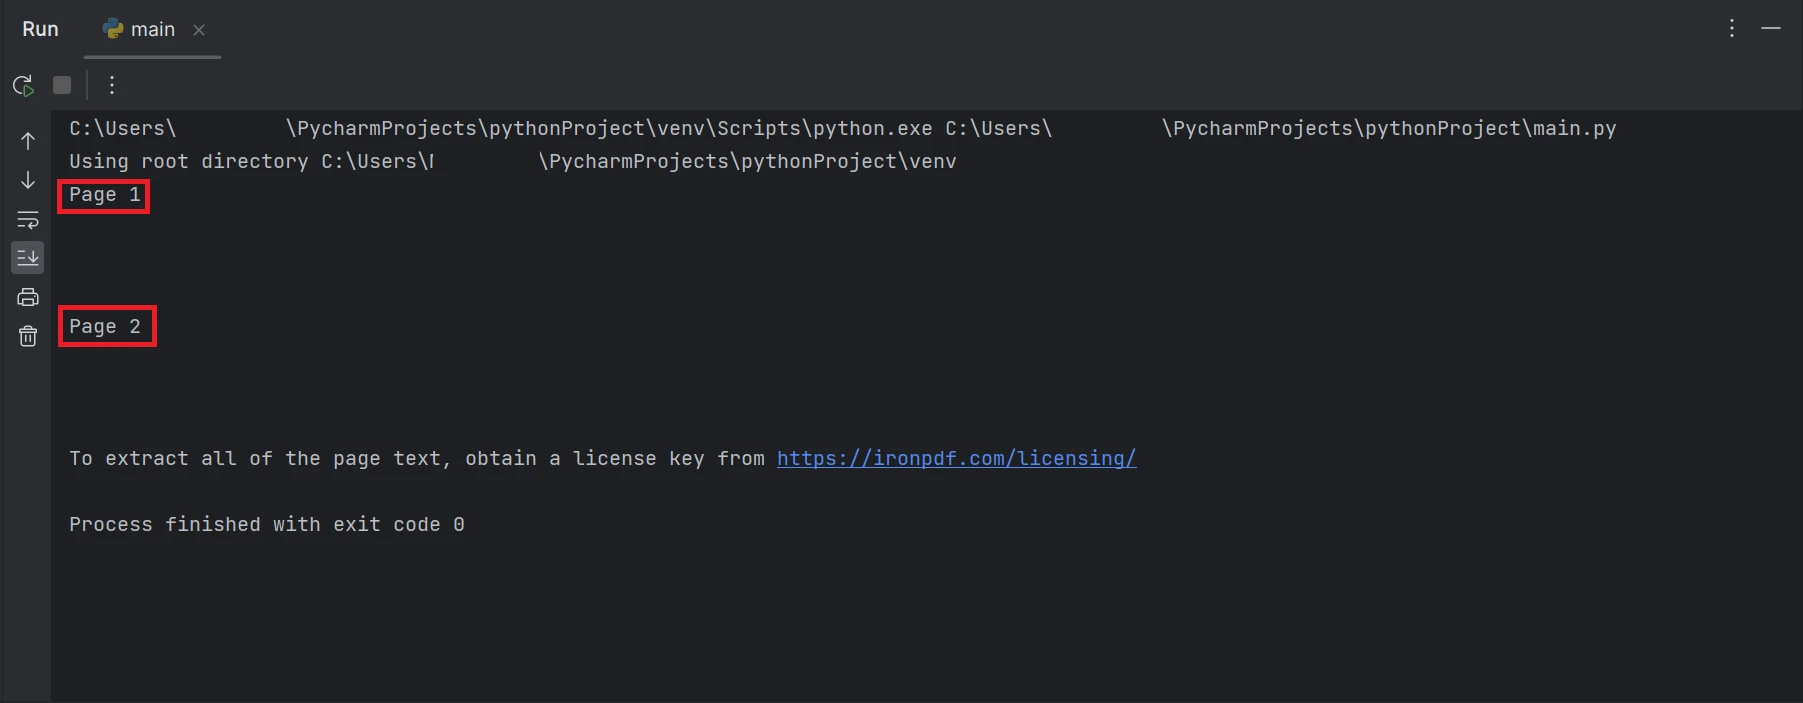
**Une capture d'écran du terminal avec le texte de sortie "Page 1" et "Page 2"**
Les boîtes rectangulaires mises en évidence dans le résultat contiennent le texte de données extrait de toutes les pages du fichier PDF.
Nous sommes capables de créer des PDF en utilisant C# avec l'aide d'IronPDF. Pour en savoir plus sur IronPDF, visitez le [site IronPDF](/how-to/csharp-parse-pdf/).
## 5.0 Conclusion
Pour minimiser les risques et assurer la protection des données, la bibliothèque IronPDF fournit des mesures de sécurité fortes. Il est compatible avec tous les navigateurs couramment utilisés et n'est pas limité à un seul. IronPDF permet aux programmeurs de créer et lire facilement des fichiers PDF avec juste quelques lignes de code. Pour répondre aux divers besoins des développeurs, la bibliothèque IronPDF propose diverses options de licence, y compris une licence développeur gratuite et des licences de développement supplémentaires qui peuvent être achetées.
Le package `$liteLicense` Lite est fourni avec une licence perpétuelle, une garantie de remboursement de 30 jours, un an de support logiciel et des possibilités de mise à jour. Au-delà du premier achat, il n'y a pas de frais supplémentaires. Les environnements de production, de test et de développement utilisent tous ces licences. IronPDF offre également des licences gratuites avec quelques limitations temporelles et de redistribution. Pendant la période d'essai gratuite, les utilisateurs peuvent tester le produit en utilisation réelle sans filigrane. Pour plus de détails sur le coût et la licence de la version d'essai d'IronPDF, veuillez visiter la [page de licence d'IronPDF](licensing).
Les bibliothèques modernes ont rationalisé la création de PDF. Lors du choix d'une bibliothèque pour des projets PDF, considérez les capacités de construction, de lecture et de conversion pour une intégration et des performances optimales. Python offre des outils comme IronPDF qui peuvent analyser efficacement les PDF existants.
2.0 IronPDF
Python est un langage de programmation qui permet aux développeurs de créer rapidement et facilement des interfaces graphiques. Il offre un plus grand dynamisme aux programmeurs par rapport à d'autres langages. Par conséquent, intégrer la bibliothèque IronPDF avec Python est un processus simple.
Pour créer rapidement et en toute sécurité une interface graphique pleinement fonctionnelle, les développeurs peuvent utiliser plusieurs outils préinstallés, y compris PyQt, wxWidgets, Kivy, et de nombreux autres packages et bibliothèques. Il convient de noter qu'IronPDF n'est pas une bibliothèque PDF Python pur; au lieu de cela, il permet l'inclusion de diverses fonctionnalités d'autres frameworks comme .NET Core.
IronPDF simplifie la conception et le développement web Python, en particulier grâce à la popularité des paradigmes de développement Python tels que Django, Flask et Pyramid. Des sites web et services en ligne notables, y compris Reddit, Mozilla et Spotify, ont utilisé ces frameworks. Vous pouvez en apprendre davantage sur Python dans IronPDF sur le site IronPDF for Python.
2.1 Fonctionnalités d'IronPDF
IronPDF est capable de générer des fichiers PDF à partir de diverses sources, y compris HTML, HTML5, ASPX, et Razor/MVC View. Il offre des fonctionnalités pour créer des PDF à partir de pages HTML et d'images.
Avec le support pour les user-agents, les proxies, les cookies, les headers HTTP, et les variables de forme, IronPDF permet la validation de formulaires de connexion HTML.
IronPDF aide à générer des fichiers PDF et à imprimer avec juste quelques lignes de code à partir de diverses sources comme des chaînes de caractères, des flux, des URLs, etc.
3.0 Configuration de Python
3.1 Configuration de l'environnement
Assurez-vous que Python est installé sur votre PC. Visitez le site officiel de Python pour télécharger et installer la dernière version de Python adaptée à votre système d'exploitation. Une fois Python installé, configurez un environnement virtuel pour isoler les dépendances de votre projet. Utilisez le module "venv" pour créer et gérer des environnements virtuels, offrant à votre projet de conversion un espace de travail propre et indépendant.
3.2 Nouveau projet dans PyCharm
Nous allons utiliser PyCharm, un IDE pour écrire du code Python, pour cette démonstration.
Cliquez sur "New Project" après le lancement de PyCharm.
L'écran d'accueil de PyCharm
Lorsque vous sélectionnez "New Project", une nouvelle fenêtre apparaîtra, vous permettant de spécifier l'emplacement du projet et son environnement. Cette nouvelle fenêtre peut être vue dans la capture d'écran ci-dessous.
L'écran du nouveau projet dans PyCharm
Cliquez sur le bouton Create pour commencer un nouveau projet, après avoir défini l'emplacement du projet et le chemin de l'environnement. Cela ouvrira une nouvelle fenêtre où le programme pourra être développé. Ce tutoriel recommande Python 3.9.
Un fichier principal ouvert dans PyCharm
3.3 Exigence de la bibliothèque IronPDF
IronPDF, une bibliothèque Python, repose principalement sur .NET 6.0. Par conséquent, pour utiliser IronPDF for Python, votre PC doit avoir le runtime .NET 6.0 installé. Avant que les utilisateurs Linux et Mac puissent utiliser ce module Python, .NET pourrait avoir besoin d'être installé. Vous pouvez obtenir l'environnement runtime requis sur le site .NET.
3.4 Configuration de la bibliothèque IronPDF
Le package "IronPDF" doit être installé pour créer, modifier et ouvrir des fichiers avec l'extension ".pdf". Pour installer le package dans PyCharm, ouvrez une fenêtre de terminal et tapez la commande suivante :
> pip install ironpdf
pip install ironpdf
La capture d'écran ci-dessous montre la configuration du package 'IronPDF'.
Un terminal montrant l'installation d'IronPDF à l'aide de pip
4.0 Analyse du PDF avec IronPDF
Grâce aux bibliothèques IronPDF, il est possible d'extraire du texte des fichiers PDF. IronPDF fournit diverses techniques pour l'extraction de texte. La première approche consiste à récupérer tout le contenu de la page comme une seule chaîne de caractères. La deuxième approche consiste à lire le contenu page par page, à partir de la première page. L'exemple de code suivant montre un schéma pour inspecter les fichiers PDF actuels avec IronPDF.
Il existe deux méthodes disponibles pour extraire des données d'un PDF :
Extraire à partir du PDF par page.
Extraire le PDF entier sous forme de texte.
Ci-dessous se trouve le fichier PDF que nous allons utiliser pour cet article. Il a deux pages.
Un PDF avec le numéro de page en haut de chaque page
4.0.1 EXTRACTION DE TEXTE PAR PAGES
Le code d'exemple fourni ci-dessous montre comment utiliser le numéro de page pour récupérer des données d'un fichier PDF.
from ironpdf importPdfDocument# Open a PDF file and create a PDF document objectpdfDocument = PdfDocument.FromFile("F:\\PDF\\1.pdf")# Extract text from the first page (index 0)AllText = pdfDocument.ExtractTextFromPage(0)# Print the extracted text from the first pageprint(AllText)
from ironpdf import PdfDocument

# Open a PDF file and create a PDF document object
pdfDocument = PdfDocument.FromFile("F:\\PDF\\1.pdf")

# Extract text from the first page (index 0)
AllText = pdfDocument.ExtractTextFromPage(0)

# Print the extracted text from the first page
print(AllText)
Python
L'extrait de code montre l'utilisation de la fonction FromFile pour lire un fichier PDF et créer un objet document PDF. Cet objet permet d'accéder aux textes et aux images présents dans le PDF. Pour extraire le texte d'une page particulière, la méthode ExtractTextFromPage peut être utilisée en fournissant le numéro de la page en tant que paramètre. Cette méthode renverra une chaîne contenant tous les mots de la page spécifiée. Le résultat s'affichera comme suit.
Une capture d'écran du terminal avec le texte de sortie "Page 1"
La boîte rectangulaire qui est mise en évidence dans le résultat est le texte extrait du fichier PDF de la page numéro 1, qui a l'index 0.
4.0.2 EXTRAIRE DE TOUTES LES PAGES
La première approche pour obtenir rapidement et facilement tout le contenu du PDF sous forme de chaîne est montrée dans l'exemple de code qui suit.
from ironpdf importPdfDocument# Create a PDF file object from the file pathpdf = PdfDocument.FromFile('F:\\PDF\\1.pdf')# Extract all text from the entire PDFall_text = pdf.ExtractAllText()# Print the extracted text from the entire PDFprint(all_text)
from ironpdf import PdfDocument

# Create a PDF file object from the file path
pdf = PdfDocument.FromFile('F:\\PDF\\1.pdf')

# Extract all text from the entire PDF
all_text = pdf.ExtractAllText()

# Print the extracted text from the entire PDF
print(all_text)
Python
Le code exemple montré ci-dessus explique comment lire un PDF à partir d'un chemin de fichier existant et le transformer en un objet fichier PDF en utilisant la fonction FromFile. Le texte brut du PDF sera extrait et converti en chaîne à l'aide de la fonction ExtractAllText de l'objet, et le texte extrait sera affiché sur le terminal. Le résultat sera présenté comme suit.
Une capture d'écran du terminal avec le texte de sortie "Page 1" et "Page 2"
Les boîtes rectangulaires mises en évidence dans le résultat contiennent le texte de données extrait de toutes les pages du fichier PDF.
Nous sommes capables de créer des PDF en utilisant C# avec l'aide d'IronPDF. Pour en savoir plus sur IronPDF, visitez le site IronPDF.
5.0 Conclusion
Pour minimiser les risques et assurer la protection des données, la bibliothèque IronPDF fournit des mesures de sécurité fortes. Il est compatible avec tous les navigateurs couramment utilisés et n'est pas limité à un seul. IronPDF permet aux programmeurs de créer et lire facilement des fichiers PDF avec juste quelques lignes de code. Pour répondre aux divers besoins des développeurs, la bibliothèque IronPDF propose diverses options de licence, y compris une licence développeur gratuite et des licences de développement supplémentaires qui peuvent être achetées.
Le package $999 Lite est fourni avec une licence perpétuelle, une garantie de remboursement de 30 jours, un an de support logiciel et des possibilités de mise à jour. Au-delà du premier achat, il n'y a pas de frais supplémentaires. Les environnements de production, de test et de développement utilisent tous ces licences. IronPDF offre également des licences gratuites avec quelques limitations temporelles et de redistribution. Pendant la période d'essai gratuite, les utilisateurs peuvent tester le produit en utilisation réelle sans filigrane. Pour plus de détails sur le coût et la licence de la version d'essai d'IronPDF, veuillez visiter la page de licence d'IronPDF.
Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


 L'écran d'accueil de PyCharm
 L'écran du nouveau projet dans PyCharm
 Un fichier principal ouvert dans PyCharm
 Un terminal montrant l'installation d'IronPDF à l'aide de pip
 Un PDF avec le numéro de page en haut de chaque page
 Une capture d'écran du terminal avec le texte de sortie "Page 1"
 Une capture d'écran du terminal avec le texte de sortie "Page 1" et "Page 2"







