



已更新 2026年5月8日
生成每月账户报表(PDF 文档)
using IronPDF C# PDF 库,开发人员可以在 .NET 项目中将 HTML 转换为可靠的 PDF 文件,而无需依赖外部服务。
阅读更多

您是否是需要从 PDF 中提取图像的开发人员? 也许您需要提取图形以便在其他文档中重复使用,或者需要在用新标识图像更新 PDF 文件之前删除旧标识图像。 无论您的需求是什么,IronPDF 在此帮助您轻松完成整个过程。
这篇文章演示了如何使用 IronPDF 的简单方法检索嵌入的图像。 您将学习如何一次提取所有图像或定位特定页面,提供可以在您的 .NET 应用程序中立即运行的完整代码示例。 在本文结束时,您将能够自信地编程地从任何 PDF 文档中提取图像。
从 PDF 文档中提取图像可以实现多种商业目的。 文档处理系统通常需要分离可视资产以进行归类或分析。 内容管理平台需要提取图像,以便在不同媒体中重新使用图形。 归档系统通过独立提取和存储图像来获得更好的组织和可搜索性。
当处理数百或数千个文档时,手动提取是不可扩展的。 使用 IronPDF 进行自动提取可确保一致性、节省时间,并在整个过程中保持图像质量。 库的Chrome 渲染引擎在处理 PDF 内容时提供像素级的精确度。 无论您是在构建文档管理系统、创建归档解决方案,还是重新使用视觉内容,IronPDF 都提供您所需的工具,高效提取嵌入图像。
通过 NuGet 包管理器安装 IronPDF 只需几秒钟。 创建一个新项目或打开一个现有项目,然后在包管理器控制台中运行:
 使用 NuGet 安装
安装后,将以下命名空间添加到您的 C# 文件中:
using IronPdf;
using System.Collections.Generic;
using System.Drawing;Imports IronPdf
Imports System.Collections.Generic
Imports System.Drawing下载 IronPDF 即刻开始提取图像,或探索综合文档,以获取更多功能。 有关详细的 API 信息,请查看对象参考指南。
ExtractAllImages 方法使从 PDF 中提取每个图像变得异常简单。 此方法返回代表文档中找到的所有图像的 AnyBitmap 对象集合。 为了演示此方法的工作原理,我创建了一个包含三个图像的示例文档:
现在,让我们来看一下将从该文档中提取所有图像的代码:
// Load the PDF document
var pdf = PdfDocument.FromFile("document.pdf");
// Extract all images from the PDF
IEnumerable<AnyBitmap> allImages = pdf.ExtractAllImages();
// Save each image to disk
int imageIndex = 0;
foreach (var image in allImages)
{
    image.SaveAs($"extracted_image_{imageIndex}.png");
    imageIndex++;
}Imports System.Collections.Generic
' Load the PDF document
Dim pdf = PdfDocument.FromFile("document.pdf")
' Extract all images from the PDF
Dim allImages As IEnumerable(Of AnyBitmap) = pdf.ExtractAllImages()
' Save each image to disk
Dim imageIndex As Integer = 0
For Each image In allImages
image.SaveAs($"extracted_image_{imageIndex}.png")
imageIndex += 1
Next这段代码加载您的 PDF,提取所有嵌入的图像,并将它们保存为 PNG 文件。 AnyBitmap 类无缝处理各种图像格式,保证原始质量。 通过更改文件扩展名,您还可以将它们保存为 JPEG、BMP 或 TIFF 图像格式。 对于更复杂的场景,请探索注释操作或管理 PDF 元数据。
提取过程保持图像分辨率和色深,确保提取期间不会发生质量损失。 IronPDF 自动处理 PDF 中的不同图像压缩类型,包括嵌入文档中的 JPEG、PNG 和 TIFF 格式。
在此,您可以看到代码已成功保存提取的图像文件:
如果我们查看第一个图像,您可以看到它保持了原始颜色和质量:
有时您只需要从特定页面而不是整个文档中获取图像。 ExtractImagesFromPage 和 ExtractImagesFromPages 方法提供了这种目标提取能力。 在以下示例中,让我们使用一个较长的 PDF 文档来演示 IronPDF 如何处理特定页面提取。 我将使用从维基百科页面生成的 PDF。
// Extract images from a single page (page 2)
var singlePageImages = pdf.ExtractImagesFromPage(1); // Pages are zero-indexed
// Extract images from multiple pages (pages 1, 3, and 5)
var multiplePageImages = pdf.ExtractImagesFromPages(new[] { 0, 2, 4 });
// Process extracted images
var i = 0;
foreach (var image in multiplePageImages)
{
    image.SaveAs($"C:\\Users\\kyess\\Desktop\\Desktop\\Code-Projects\\ExtractImageFromPdf\\output\\MultiPaged_image{i}.jpg");
    i++;
}' Extract images from a single page (page 2)
Dim singlePageImages = pdf.ExtractImagesFromPage(1) ' Pages are zero-indexed
' Extract images from multiple pages (pages 1, 3, and 5)
Dim multiplePageImages = pdf.ExtractImagesFromPages(New Integer() {0, 2, 4})
' Process extracted images
Dim i As Integer = 0
For Each image In multiplePageImages
image.SaveAs($"C:\Users\kyess\Desktop\Desktop\Code-Projects\ExtractImageFromPdf\output\MultiPaged_image{i}.jpg")
i += 1
Next这种方法特别适用于处理只包含相关图像的特定部分的大型 PDF。 通过避免不必要的提取操作,它减少了内存使用量并提高了处理速度。 为了有效处理多个 PDF,请考虑实现异步操作或探索并行 PDF 生成技术。
如您所见,代码轻松地提取了指定页面上的图像,以及来自第 2 页的单个图像:
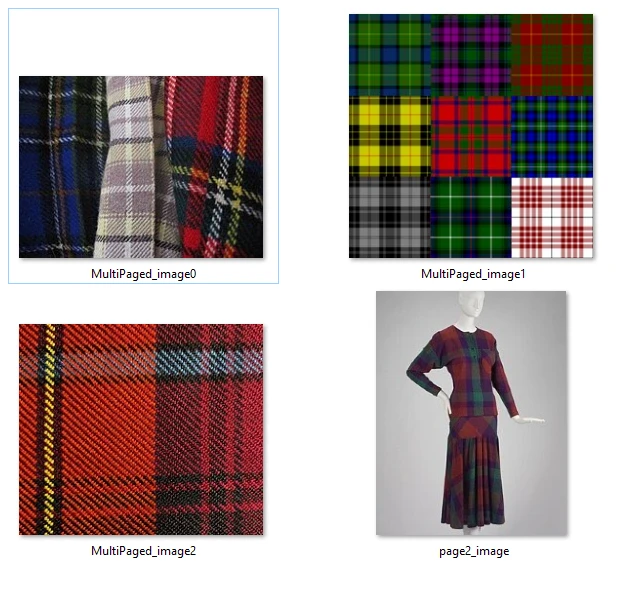
IronPDF 支持超出基础图像提取的更复杂提取场景。 ExtractAllRawImages 方法提供对原始图像数据的访问,以字节数组形式,非常适合直接数据库存储或自定义处理管道。
// Extract raw image data for advanced processing
var rawImages = pdf.ExtractAllRawImages();
foreach (byte[] imageData in rawImages)
{
    // Process raw bytes - store in database, apply filters, etc.
    System.IO.File.WriteAllBytes("raw_image.dat", imageData);
}' Extract raw image data for advanced processing
Dim rawImages = pdf.ExtractAllRawImages()
For Each imageData As Byte() In rawImages
' Process raw bytes - store in database, apply filters, etc.
System.IO.File.WriteAllBytes("raw_image.dat", imageData)
Next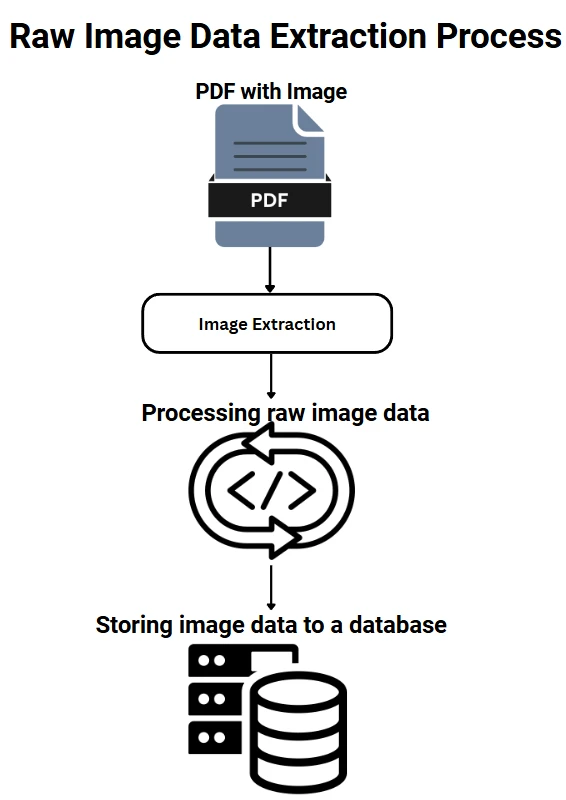
IronPDF 还无缝处理加密的 PDF。 加载文档时提供密码,图像提取与未加密文件的操作相同。 库在遵循文档权限的同时处理各种PDF 安全级别。 Microsoft 在其处理 .NET 中的图像文档中提供了有关图像处理操作的更多背景信息。
从 PDF 中提取图像时,几个注意事项可确保顺畅的操作。 处理包含高分辨率图像的大文档时,内存管理变得至关重要。 逐页处理 PDF 而不是一次加载全部以获得最佳性能。 Stack Overflow 社区经常讨论各种方法,但 IronPDF 的实现因其简单和可靠性而脱颖而出。
损坏的 PDF 可能包含受损的图像。 IronPDF 优雅地处理这些情况,跳过不可恢复的图像同时提取有效的图像。 在生产环境中,总是将提取代码包裹在 try-catch 块中。
一些 PDF 使用图像遮罩或透明层。 IronPDF 正确处理这些复杂的图像结构,在适用的情况下保持 alpha 通道。 当您需要从具有透明度的 PDF 文档中提取图像时,库能准确保持所有图像属性。 想要更多疑难解答资源,请访问IronPDF 疑难解答指南。
IronPDF 将 PDF 图像提取的复杂任务转变为简单、可靠的过程。 从使用 ExtractAllImages 的基本提取到页面特定的目标操作,库高效地处理各种需求。 在您的 .NET 应用程序中以最少代码从 PDF 文档中提取图像的能力使 IronPDF 成为文档处理工作流的重要工具。 现在您可以操作这些提取的图像,将它们用于其他 PDF 文档或做任何你想做的事情。 如果您希望在更多文档上重复使用它们,请务必查看IronPDF上的将图像盖印到PDF上的指南。
准备在您的项目中实施图像提取了吗? 开始您的免费试用,找到最适合您需求的解决方案。


Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





