



已更新 2026年5月8日
生成每月账户报表(PDF 文档)
using IronPDF C# PDF 库,开发人员可以在 .NET 项目中将 HTML 转换为可靠的 PDF 文件,而无需依赖外部服务。
阅读更多

本文将使用IronPDF 适用于 .NET,这是一款C# PDF库,用于读取PDF文件。
PdfDocument.FromFile方法打开并加载所需的PDF文件。ExtractAllText方法来检索内容。IronPDF,一个强大的C# PDF阅读库,使开发人员能够轻松处理PDF文档。 凭借其广泛的功能和特性,IronPDF简化了PDF文档处理的任务,使用户能够轻松地读取、提取和操作PDF内容。 无论您是在自动化文档流程、提取用于分析的数据和图像,还是从头创建PDF,IronPDF都提供了全面的工具集来简化这些任务。
本文探讨了在C#中使用IronPDF进行高效PDF处理的世界,展示了其多功能性和作为开发人员软件开发旅程中基本工具的价值。
在深入编码部分之前,让我们从设置一个全新的Visual Studio C#控制台应用程序项目开始。 该项目将作为开发和实践示例的专用工作空间。
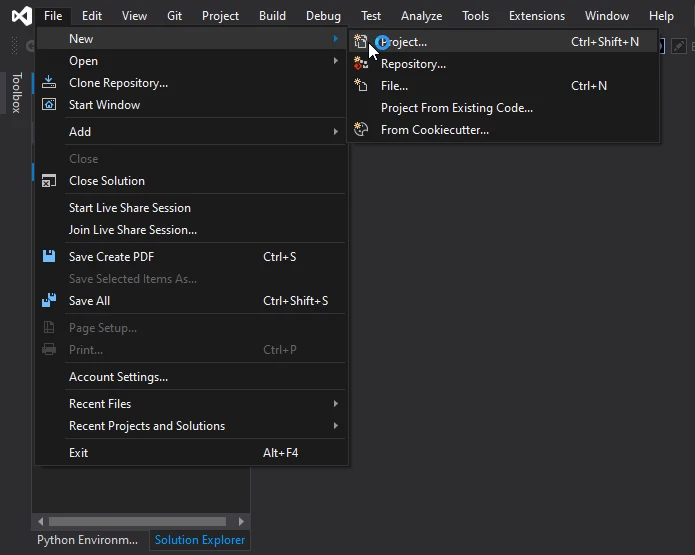 导航到Visual Studio中的创建项目对话框
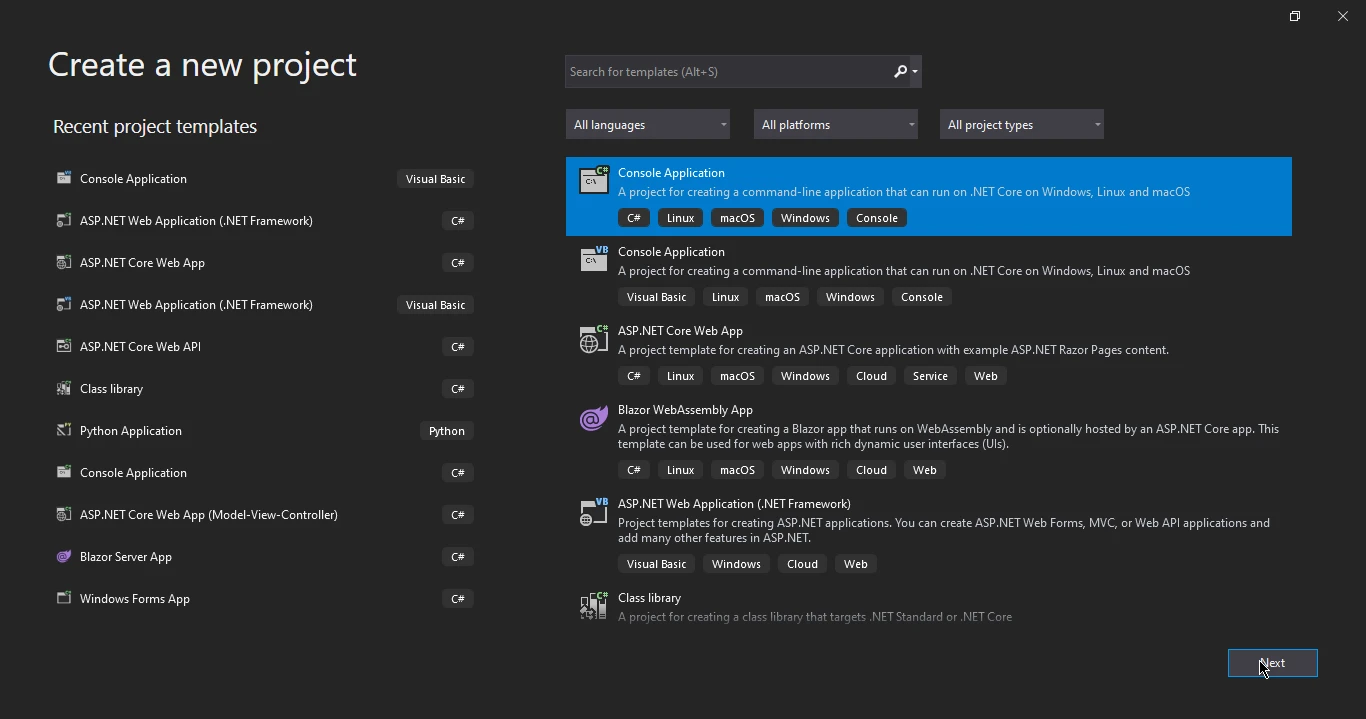 在 Visual Studio 中创建新项目
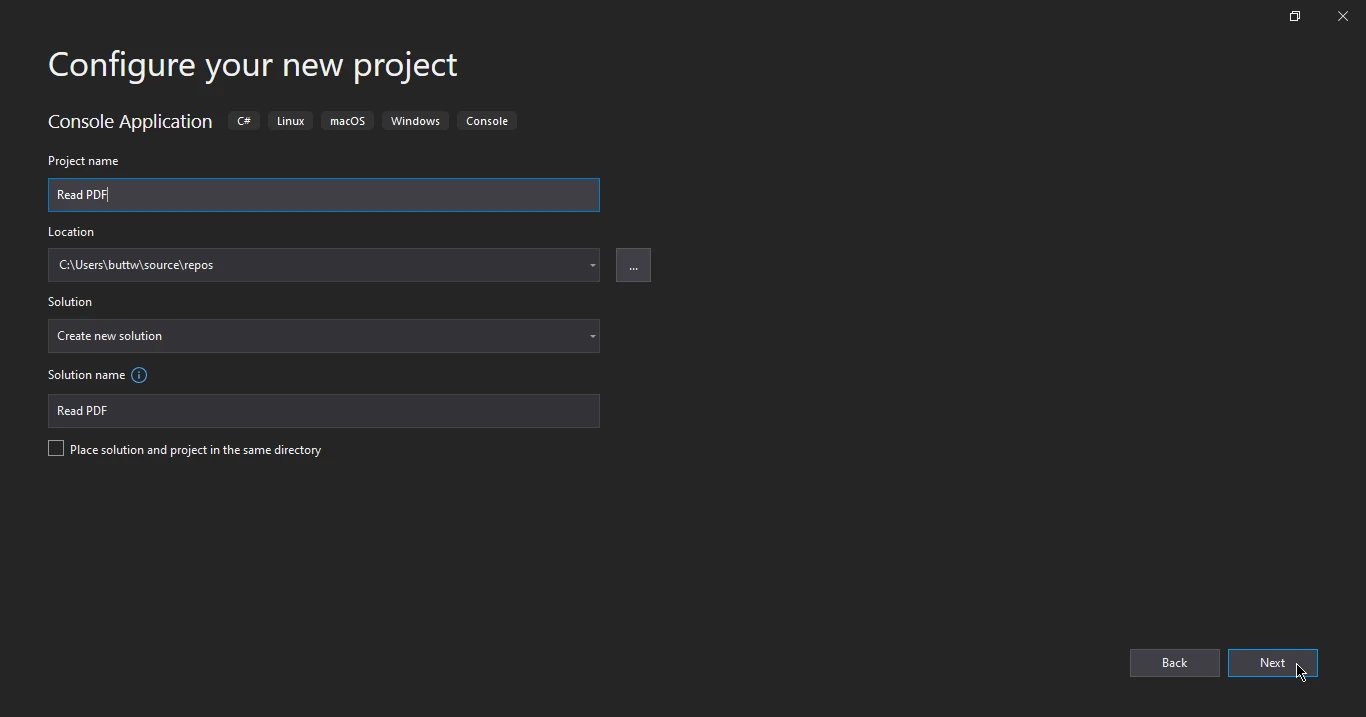 配置项目
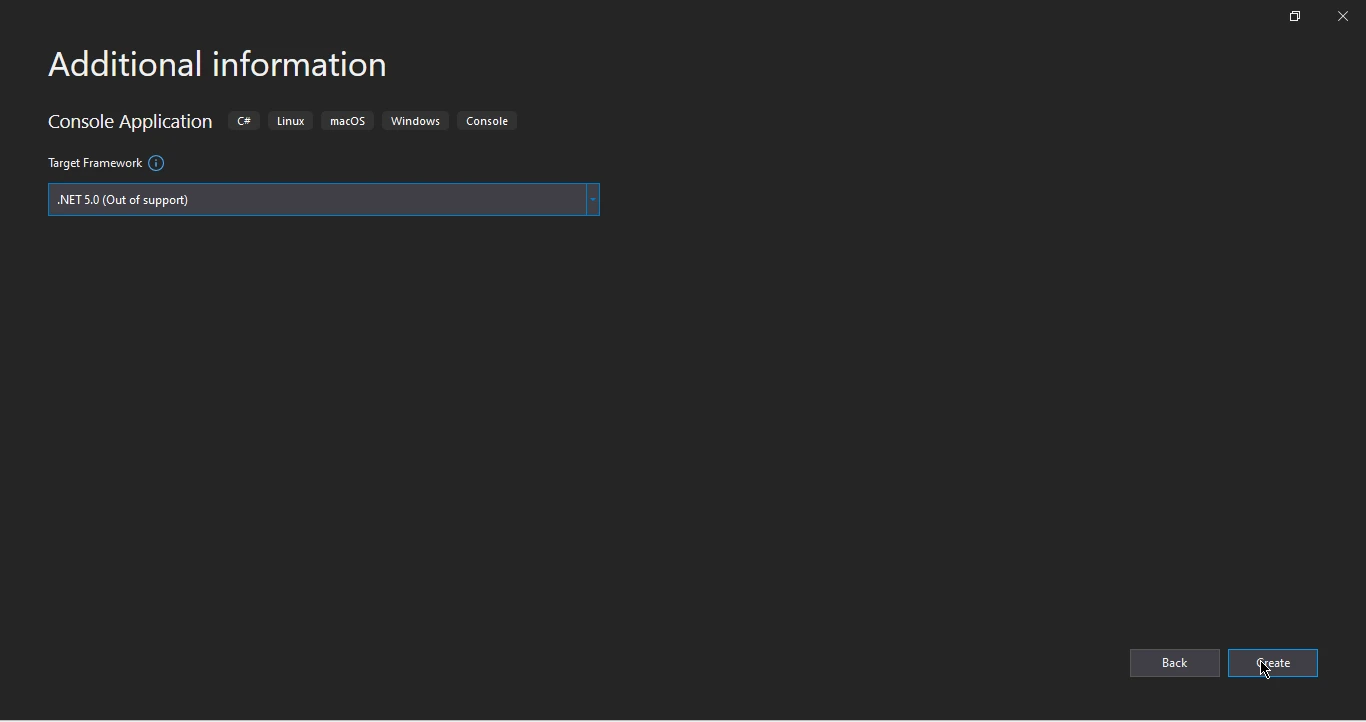 .NET Framework选择
现在项目已牢固建立,下一关键步骤涉及安装IronPDF。
IronPDF提供多种下载和安装PDF库的选项。 为了此指南的目的,将重点放在使用NuGet包管理器安装IronPDF上,这是一种高效且广泛采用的方法。
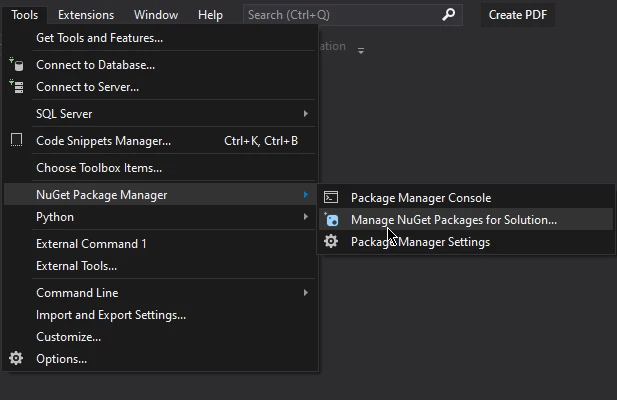 导航到 NuGet 包管理器
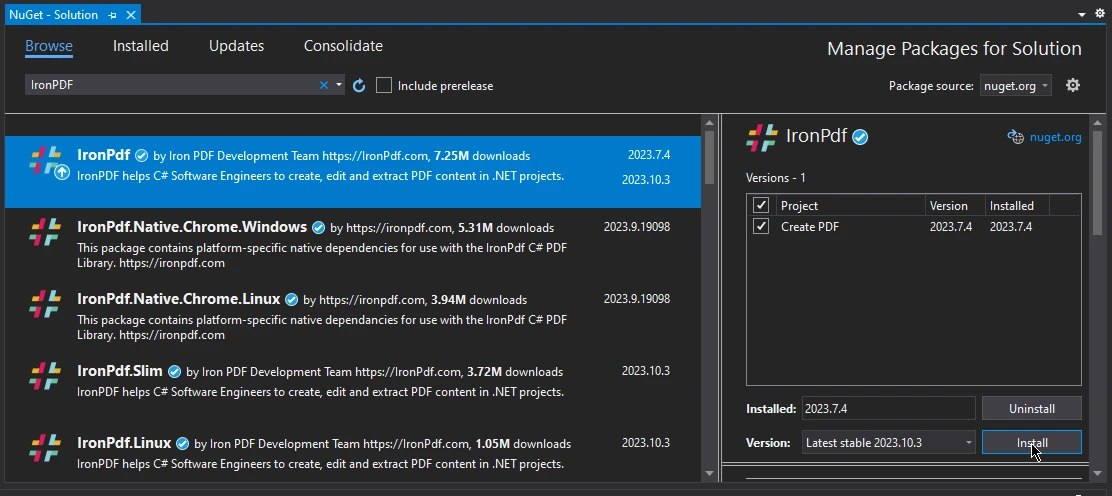 在NuGet包管理器UI中搜索和安装IronPDF包
对于那些更喜欢命令行方法的人,NuGet包管理器控制台提供了一条优雅的途径。 只需打开此控制台,输入以下命令,并按"Enter":
您还可以选择直接从NuGet网站链接获取包。
本节将展示如何使用C#编程语言和IronPDF打开并读取完整PDF文件。
using IronPdf;
using System;

class Program
{
    static void Main()
    {
        // Set the license key for IronPDF if available
        IronPdf.License.LicenseKey = "Your_License_Key_Here";

        // Load the PDF document from a specified file path
        var pdf = PdfDocument.FromFile("document_scaled_compressed.pdf");

        // Extract all text from the loaded PDF
        string text = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(text);
    }
}Imports IronPdf
Imports System
Friend Class Program
Shared Sub Main()
' Set the license key for IronPDF if available
IronPdf.License.LicenseKey = "Your_License_Key_Here"
' Load the PDF document from a specified file path
Dim pdf = PdfDocument.FromFile("document_scaled_compressed.pdf")
' Extract all text from the loaded PDF
Dim text As String = pdf.ExtractAllText()
' Output the extracted text to the console
Console.WriteLine(text)
End Sub
End Class要开始,您需要导入所需的命名空间。 在上述代码示例中,IronPdf命名空间被导入,其中包含处理PDF所需的基本功能。 此外,还导入了System命名空间用于通用的系统级操作。
using IronPdf;
using System;Imports IronPdf
Imports SystemIronPDF需要有效的许可证密钥才能在生产环境中使用。 在代码示例中,有一行用于设置许可证密钥。 然而,在您提供的代码中,许可证密钥是空的""。 确保在生产环境中使用时,将空字符串替换为IronPDF的有效许可证密钥。
IronPdf.License.LicenseKey = "Your_License_Key_Here";IronPdf.License.LicenseKey = "Your_License_Key_Here"下一步是加载并解析PDF文件。在提供的代码中,使用PdfDocument.FromFile方法通过文件名"document_scaled_compressed.pdf"加载PDF,并将其分配给pdf变量。 此PDF文件将用于文本提取。
var pdf = PdfDocument.FromFile("document_scaled_compressed.pdf");Dim pdf = PdfDocument.FromFile("document_scaled_compressed.pdf")IronPDF提供了一种简单的方法从加载的PDF文档中提取文本。 ExtractAllText方法可以从PDF的每一页中提取所有文本内容,并将其存储在名为text的string变量中,该方法相当于将PDF转换为文本。
string text = pdf.ExtractAllText();Dim text As String = pdf.ExtractAllText()最后一步是显示提取的文本。 在代码中,Console.WriteLine将打印并写入提取的文本到控制台。 这是一个有用的方法,用于调试或向用户展示文本。
Console.WriteLine(text);Console.WriteLine(text)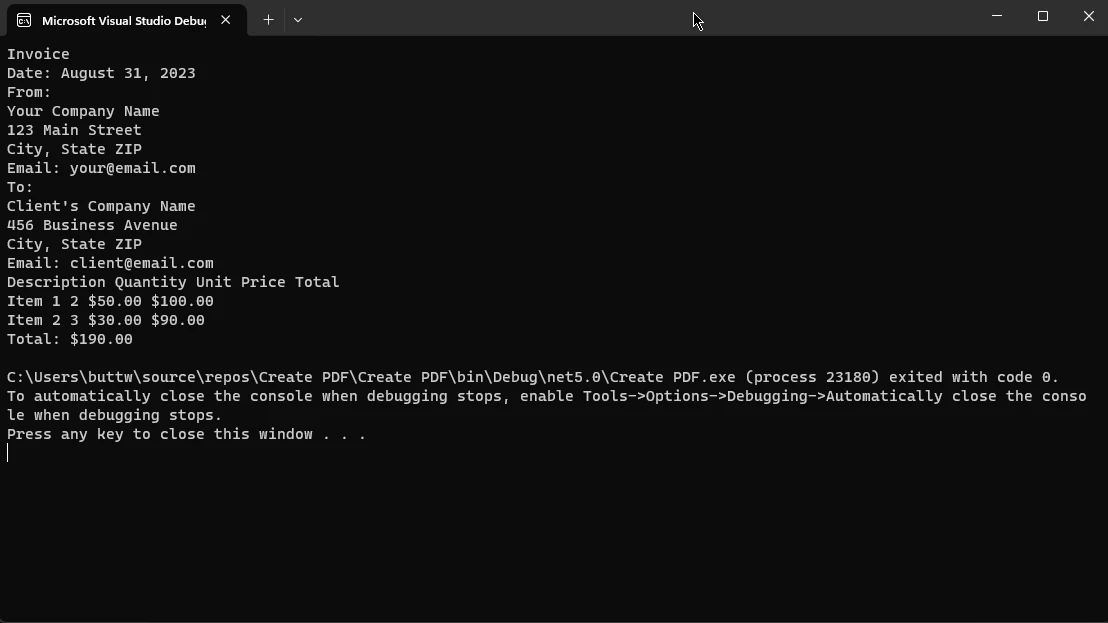 从PDF文件中提取的文本
本文指导开发者如何使用IronPDF库在C#中有效地处理PDF文件。 它首先展示了设置专用的Visual Studio项目,然后通过NuGet包管理器安装IronPDF的简单过程。 随后,该文章提供了逐步说明如何导入必要的库、设置IronPDF许可证密钥、加载PDF文件、提取文本内容,并显示各页提取的文本。 您还可以使用C#将提取的文本保存到TXT文件中。
凭借其用户友好的方法和全面的功能,IronPDF是自动化文档处理、数据提取和从HTML、URL及图像创建PDF的不可或缺的工具,使其在涉及PDF文件处理的C#软件开发项目中成为一个无价的资产。
使用IronPDF读取PDF文件的完整文章可在以下如何页面找到。 该C# PDF阅读器上的代码示例也可用。 有关使用IronPDF的更多代码示例,请访问此示例页面。 IronPDF还提供丰富的文档,以回答所有开发者的问题并提供全面的动手支持。 IronPDF提供免费试用许可证,以便用户在决定购买永久许可证之前全面探索其功能。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





