using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
USANDO IRONPDF
Firma PDF .NET para España: XAdES (TicketBAI), PAdES-LTV (LOPDGDD) y eIDAS con FNMT | IronPDF
La capacidad de extraer y utilizar datos de PDFs de manera programática presenta desafíos únicos para el posible desarrollador, debido a la complejidad del formato interno de los PDFs.
[IronPDF](/) es una de las muchas bibliotecas de programación .NET disponibles que está especialmente posicionada para ayudar a los desarrolladores a superar los desafíos de [extraer contenido (texto e imágenes)](/how-to/extract-text-and-images/) de PDFs de manera confiable, entre muchas otras tareas relacionadas con PDFs. IronPDF te libera de tener que entender los detalles del formato interno de los PDFs y te permite centrar tu tiempo y esfuerzo en entregar tu proyecto de manera rápida y a tiempo.
Este artículo profundiza en las complejidades del análisis de documentos PDF, las herramientas y técnicas involucradas, y el impacto transformador que la [biblioteca IronPDF for .NET](/) puede tener para ayudarte a comprender el contenido de tu PDF.
## Conceptos clave
1. **Análisis de PDFs:** Extraer datos estructurados de documentos PDF es el núcleo del análisis de PDFs. Implica reconocer patrones de documentos y definir reglas para recuperar puntos de datos específicos. La información extraída a menudo se almacena en bases de datos o se utiliza en otras aplicaciones.
2. **Herramientas de análisis de PDFs:** Estas herramientas, como IronPDF, Tabula, PyPDF2 y PDFMiner, automatizan el proceso de extracción. Utilizan algoritmos para interpretar la estructura del PDF y extraer información con precisión.
3. **Proceso de extracción de datos:** Extraer datos de PDFs generalmente implica importar archivos en una herramienta de análisis, analizar la estructura del documento y convertir los datos analizados en formatos como HTML, CSV, XML, o directamente en aplicaciones como Excel o Word.
4. **Datos estructurados vs. no estructurados:** Los PDFs suelen contener tanto datos estructurados (por ejemplo, tablas) como no estructurados. Las herramientas de análisis deben manejar ambos tipos para asegurar una extracción de datos significativa.
## Cómo analizar datos de documentos PDF: Guía paso a paso
### Paso 1: Abrir un extractor de PDF gratuito en línea para analizar archivos PDF
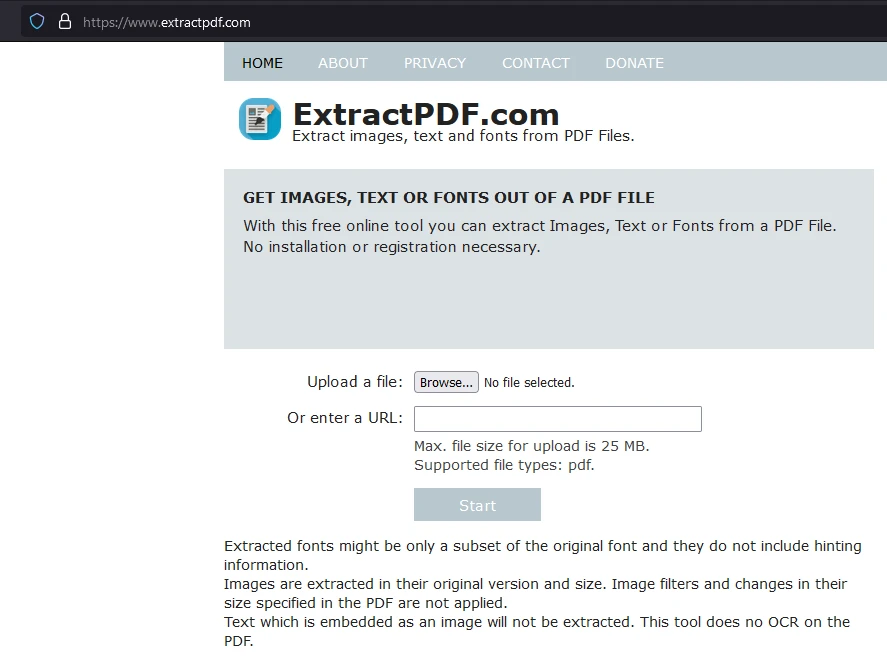
Una herramienta fácil de usar es el [Extractor de PDF en línea gratuito](https://www.extractpdf.com/). Navega al sitio web, donde puedes ver una descripción general de la herramienta, incluido cómo importa PDFs y qué datos puede extraer.
### Paso 2: Cargar el archivo PDF
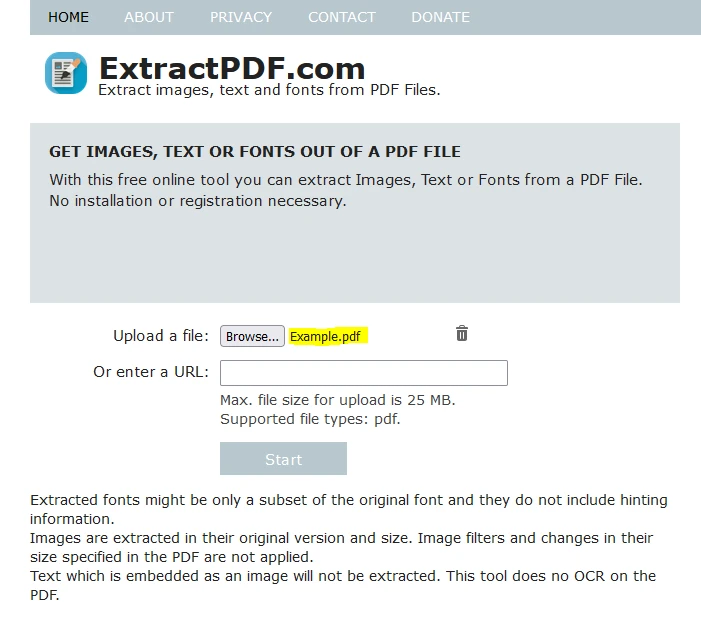
Haz clic en "Examinar" para seleccionar el archivo PDF del cual deseas extraer datos.
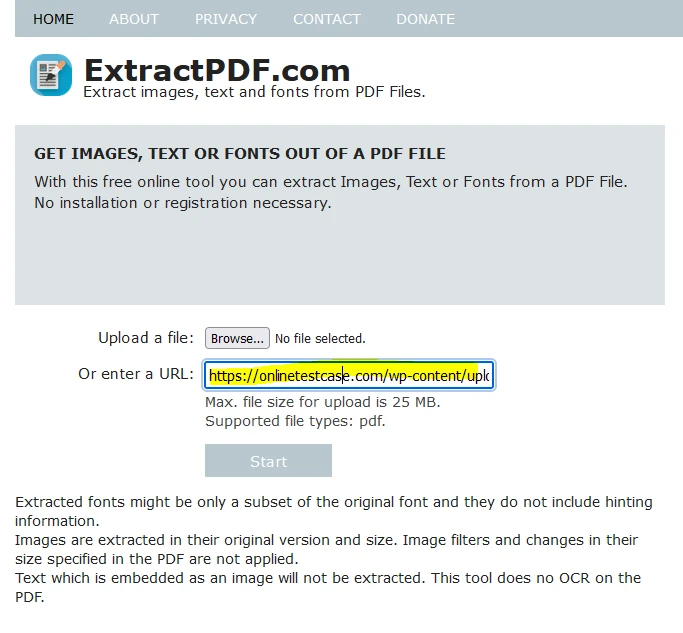
Alternativamente, puedes subir el archivo pegando un enlace al PDF.
### Paso 3: Iniciar la extracción
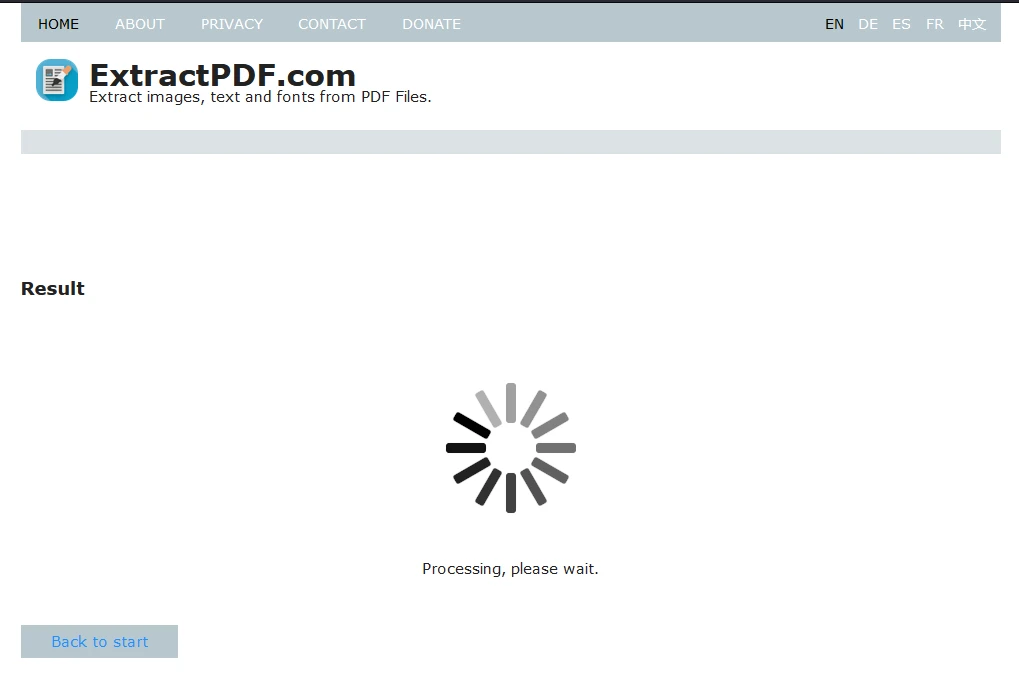
Después de subir el archivo, haz clic en "Iniciar" para comenzar el proceso de extracción de datos. La herramienta mostrará una pantalla de carga durante el procesamiento.
### Paso 4: Descarga de los datos extraídos
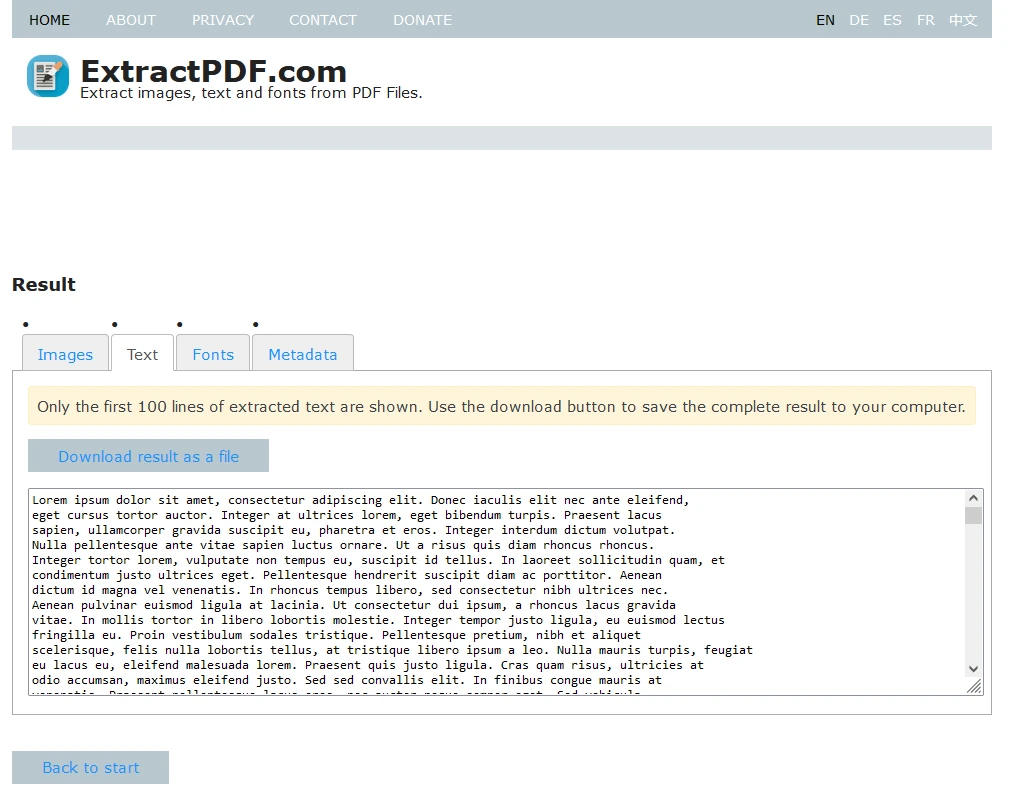
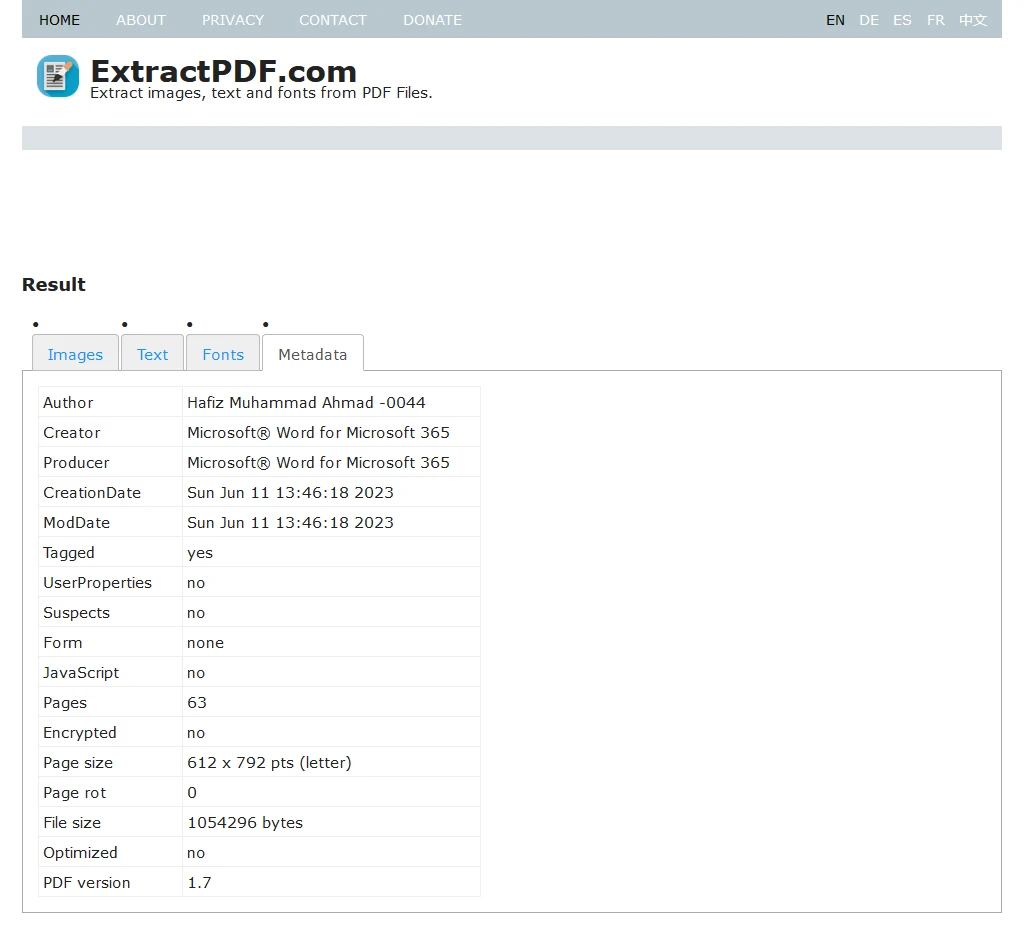
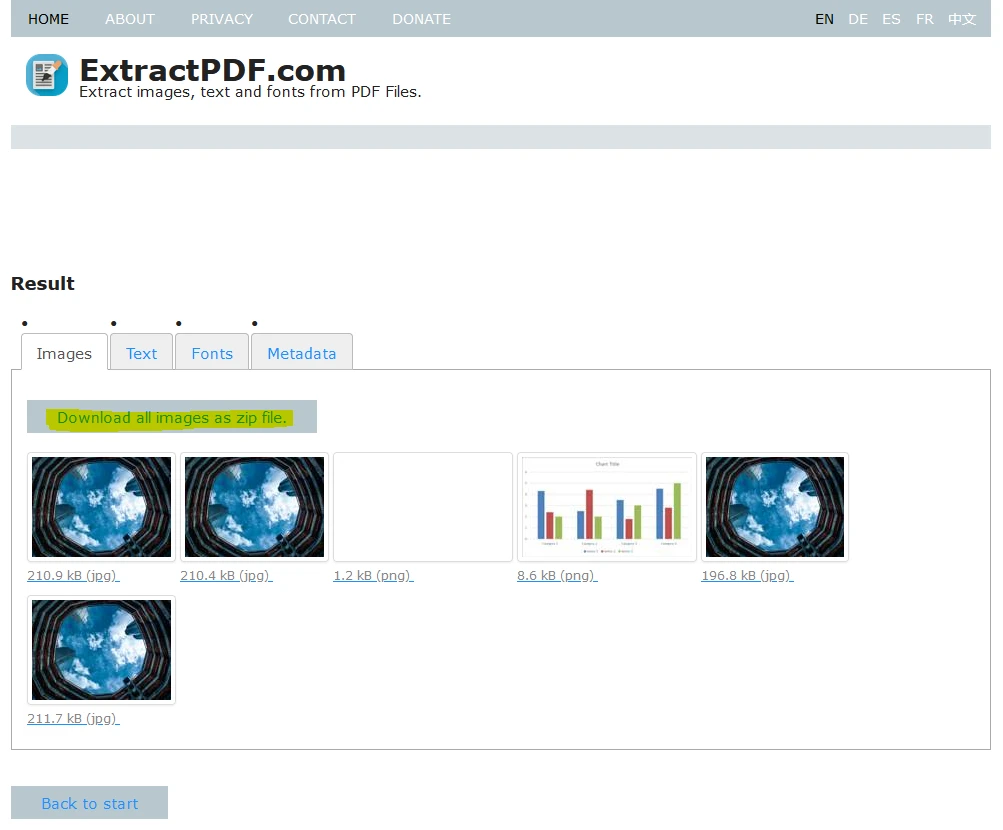
Una vez que la extracción se complete, puedes descargar los datos. La herramienta proporciona el texto, las imágenes, las fuentes y los metadatos extraídos del PDF en un formato tabular.
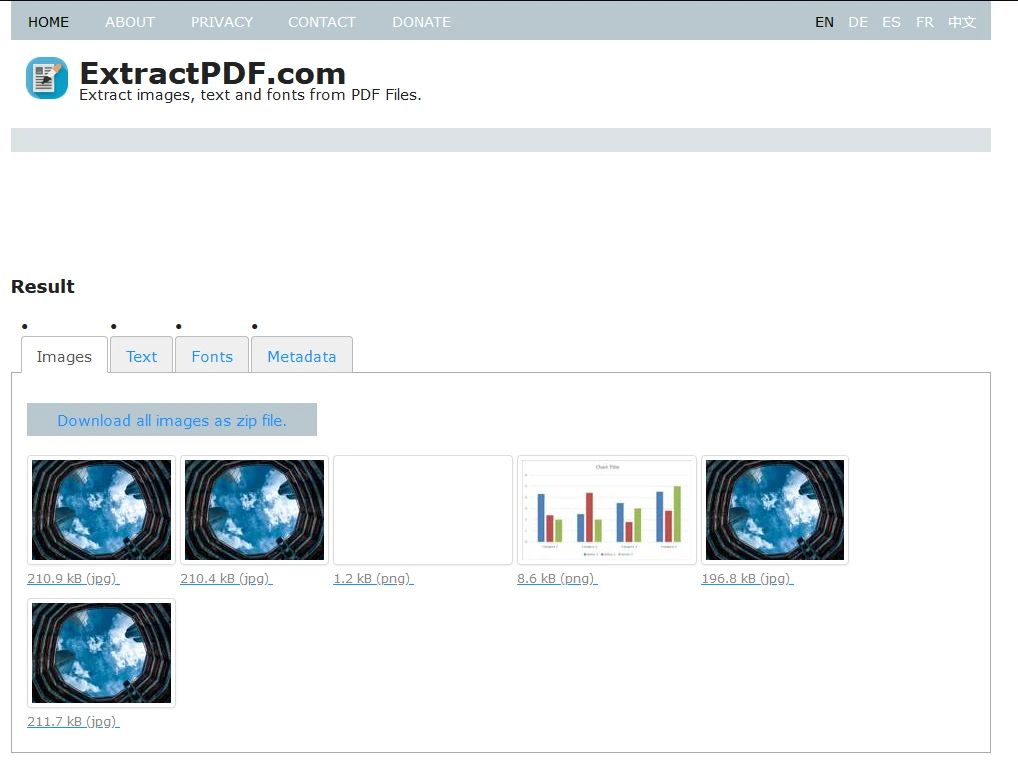
El texto que se puede copiar en bases de datos se encuentra bajo la pestaña 'Texto'.
Los metadatos, incluidos el título del documento, el autor, la fecha de creación y más, están disponibles bajo la pestaña 'Metadatos'.
Finalmente, puedes descargar todos los datos extraídos como un archivo ZIP.
## Beneficios del análisis de PDF
1. **Automatización de procesos de negocio:** El análisis de PDFs automatiza el proceso de extracción de datos, reduciendo el trabajo manual y mejorando las operaciones empresariales. Esta automatización permite una toma de decisiones más rápida y una mayor escalabilidad.
2. **Reducción de errores:** La entrada manual de datos es propensa a errores. Las herramientas de análisis de PDFs reducen los errores humanos, asegurando un manejo de datos más preciso y reduciendo errores costosos.
3. **Ahorro de tiempo y costo:** Automatizar la extracción de datos de PDFs ahorra tiempo y recursos significativos, que las organizaciones pueden redirigir a tareas más estratégicas.
4. **Versatilidad en el uso de datos:** Los datos extraídos pueden convertirse en varios formatos, lo que facilita su integración con herramientas como Excel, Word o Google Sheets.
## Parametrización de datos PDF con IronPDF
IronPDF es una poderosa biblioteca de [Iron Software](https://ironsoftware.com/) que los desarrolladores pueden usar para extraer datos de PDFs de manera programática. Admite extraer texto, tablas, imágenes y [extracción de metadatos de PDF](/how-to/metadata/) con alta eficiencia.
### Instalación de IronPDF
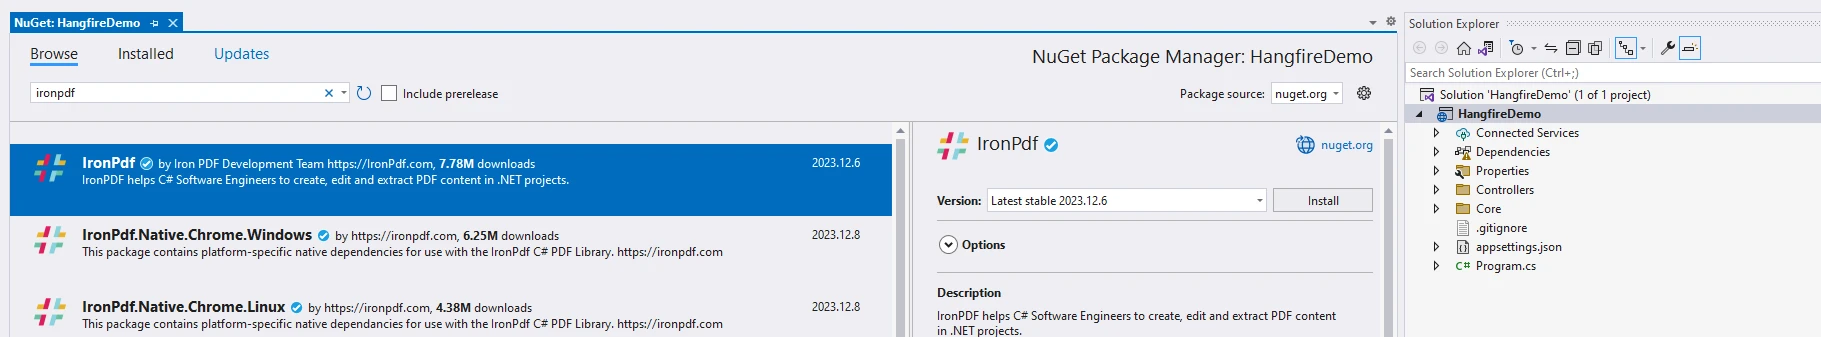
Puedes instalar IronPDF a través del administrador de paquetes [IronPDF en NuGet](https://www.nuget.org/packages/IronPdf/) en Visual Studio.
#### Instalación mediante el gestor de paquetes NuGet
En Visual Studio, busca "IronPDF" en el Administrador de Paquetes NuGet y haz clic en instalar.
#### Instalación mediante la consola del gestor de paquetes
Alternativamente, usa este comando en la Consola del Administrador de Paquetes:
```shell
:ProductInstall
```
### Ejemplo de código: Análisis de un PDF con IronPDF
```csharp
using IronPdf;

namespace ParsePdf
{
    public partial class Form1 : Form
    {
        public Form1()
        {
            InitializeComponent();

            // Select the Desired PDF File
            using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf");

            // Extract text from the PDF
            string allText = pdf.ExtractAllText();

            // Display the extracted text in a MessageBox
            // Only the first 1000 characters are shown for brevity
            MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK);
        }
    }
}
```
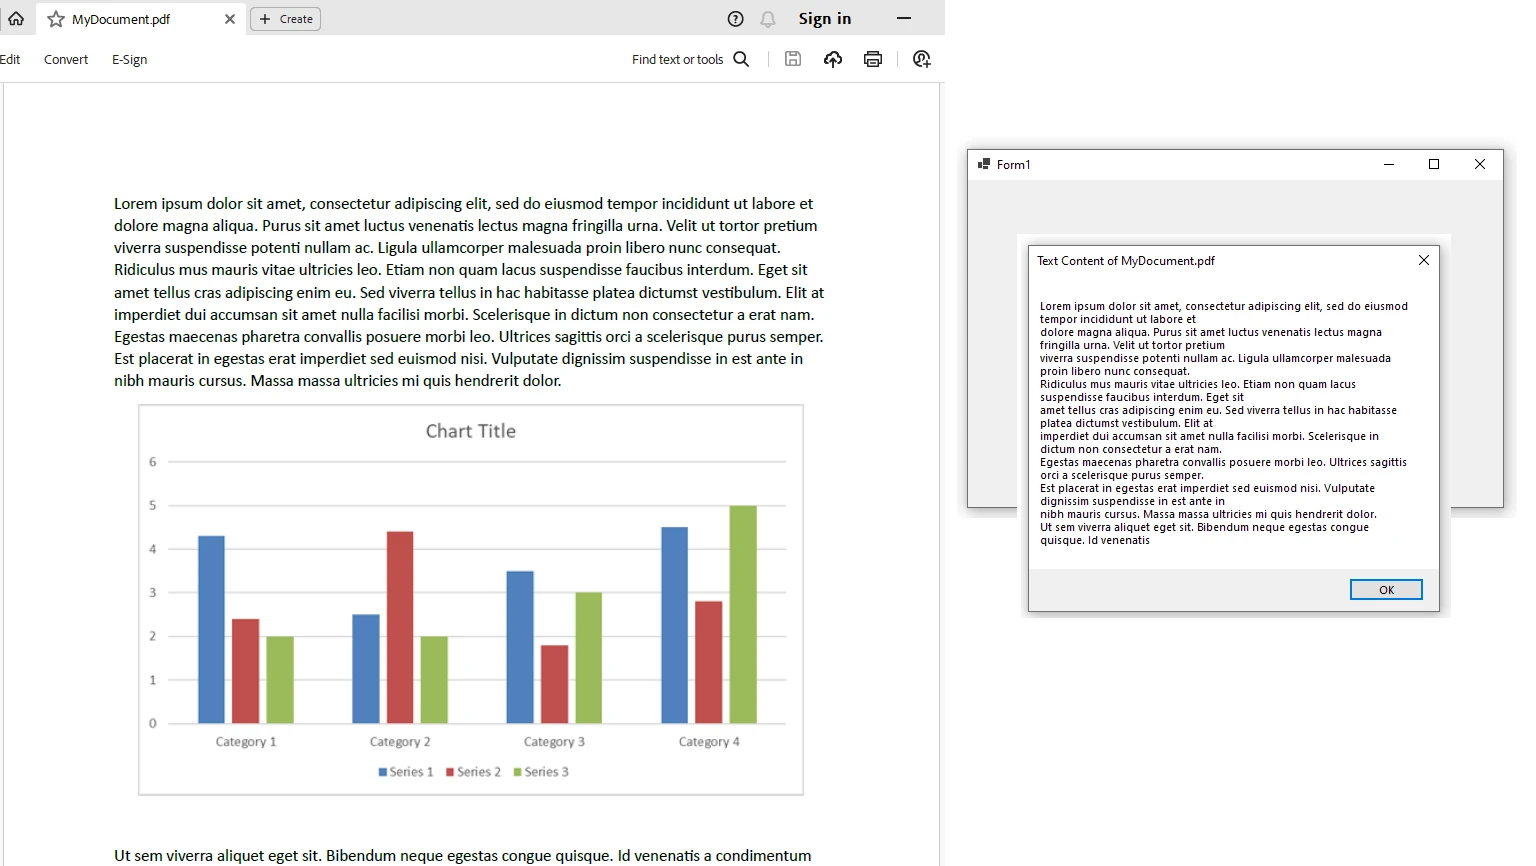
En este ejemplo, creamos una aplicación de Windows Forms que usa IronPDF para extraer texto de un archivo PDF seleccionado. El texto extraído se muestra en un cuadro de mensaje.
### Licencia de IronPDF
IronPDF requiere una [clave de licencia de IronPDF](/licensing/) que puedes obtener como parte de una [licencia de prueba gratuita](trial-license). Agregue la clave de licencia a su archivo `appsettings.json`:
```json
{
"IronPdf.LicenseKey": "your license key here"
}
```
[Solicita una licencia de prueba gratuita](trial-license) desde la [página de licencias del producto de IronPDF](trial-license).
## Conclusión
El análisis eficiente de PDFs desbloquea todo el potencial de los documentos digitales, permitiendo a las empresas automatizar procesos, reducir errores y ahorrar tiempo y dinero. Al dominar las técnicas y herramientas de análisis de PDFs, las organizaciones pueden mejorar la productividad y lograr más con sus activos digitales. IronPDF ofrece una solución ideal para desarrolladores que buscan trabajar programáticamente con documentos PDF.
La capacidad de extraer y utilizar datos de PDFs de manera programática presenta desafíos únicos para el posible desarrollador, debido a la complejidad del formato interno de los PDFs.
IronPDF es una de las muchas bibliotecas de programación .NET disponibles que está especialmente posicionada para ayudar a los desarrolladores a superar los desafíos de extraer contenido (texto e imágenes) de PDFs de manera confiable, entre muchas otras tareas relacionadas con PDFs. IronPDF te libera de tener que entender los detalles del formato interno de los PDFs y te permite centrar tu tiempo y esfuerzo en entregar tu proyecto de manera rápida y a tiempo.
Este artículo profundiza en las complejidades del análisis de documentos PDF, las herramientas y técnicas involucradas, y el impacto transformador que la biblioteca IronPDF for .NET puede tener para ayudarte a comprender el contenido de tu PDF.
Conceptos clave
Análisis de PDFs: Extraer datos estructurados de documentos PDF es el núcleo del análisis de PDFs. Implica reconocer patrones de documentos y definir reglas para recuperar puntos de datos específicos. La información extraída a menudo se almacena en bases de datos o se utiliza en otras aplicaciones.
Herramientas de análisis de PDFs: Estas herramientas, como IronPDF, Tabula, PyPDF2 y PDFMiner, automatizan el proceso de extracción. Utilizan algoritmos para interpretar la estructura del PDF y extraer información con precisión.
Proceso de extracción de datos: Extraer datos de PDFs generalmente implica importar archivos en una herramienta de análisis, analizar la estructura del documento y convertir los datos analizados en formatos como HTML, CSV, XML, o directamente en aplicaciones como Excel o Word.
Datos estructurados vs. no estructurados: Los PDFs suelen contener tanto datos estructurados (por ejemplo, tablas) como no estructurados. Las herramientas de análisis deben manejar ambos tipos para asegurar una extracción de datos significativa.
Cómo analizar datos de documentos PDF: Guía paso a paso
Paso 1: Abrir un extractor de PDF gratuito en línea para analizar archivos PDF
Una herramienta fácil de usar es el Extractor de PDF en línea gratuito. Navega al sitio web, donde puedes ver una descripción general de la herramienta, incluido cómo importa PDFs y qué datos puede extraer.
Paso 2: Cargar el archivo PDF
Haz clic en "Examinar" para seleccionar el archivo PDF del cual deseas extraer datos.
Alternativamente, puedes subir el archivo pegando un enlace al PDF.
Paso 3: Iniciar la extracción
Después de subir el archivo, haz clic en "Iniciar" para comenzar el proceso de extracción de datos. La herramienta mostrará una pantalla de carga durante el procesamiento.
Paso 4: Descarga de los datos extraídos
Una vez que la extracción se complete, puedes descargar los datos. La herramienta proporciona el texto, las imágenes, las fuentes y los metadatos extraídos del PDF en un formato tabular.
El texto que se puede copiar en bases de datos se encuentra bajo la pestaña 'Texto'.
Los metadatos, incluidos el título del documento, el autor, la fecha de creación y más, están disponibles bajo la pestaña 'Metadatos'.
Finalmente, puedes descargar todos los datos extraídos como un archivo ZIP.
Beneficios del análisis de PDF
Automatización de procesos de negocio: El análisis de PDFs automatiza el proceso de extracción de datos, reduciendo el trabajo manual y mejorando las operaciones empresariales. Esta automatización permite una toma de decisiones más rápida y una mayor escalabilidad.
Reducción de errores: La entrada manual de datos es propensa a errores. Las herramientas de análisis de PDFs reducen los errores humanos, asegurando un manejo de datos más preciso y reduciendo errores costosos.
Ahorro de tiempo y costo: Automatizar la extracción de datos de PDFs ahorra tiempo y recursos significativos, que las organizaciones pueden redirigir a tareas más estratégicas.
Versatilidad en el uso de datos: Los datos extraídos pueden convertirse en varios formatos, lo que facilita su integración con herramientas como Excel, Word o Google Sheets.
Parametrización de datos PDF con IronPDF
IronPDF es una poderosa biblioteca de Iron Software que los desarrolladores pueden usar para extraer datos de PDFs de manera programática. Admite extraer texto, tablas, imágenes y extracción de metadatos de PDF con alta eficiencia.
Instalación de IronPDF
Puedes instalar IronPDF a través del administrador de paquetes IronPDF en NuGet en Visual Studio.
Instalación mediante el gestor de paquetes NuGet
En Visual Studio, busca "IronPDF" en el Administrador de Paquetes NuGet y haz clic en instalar.
Instalación mediante la consola del gestor de paquetes
Alternativamente, usa este comando en la Consola del Administrador de Paquetes:
PM > Install-Package IronPdf
Install-Package IronPdf
Ejemplo de código: Análisis de un PDF con IronPDF
using IronPdf;namespace ParsePdf{ public partial class Form1 : Form { publicForm1() {InitializeComponent(); // Select the Desired PDF File using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf"); // Extract text from the PDF string allText = pdf.ExtractAllText(); // Display the extracted text in a MessageBox // Only the first 1000 characters are shown for brevityMessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK); } }}
using IronPdf;

namespace ParsePdf
{
    public partial class Form1 : Form
    {
        public Form1()
        {
            InitializeComponent();

            // Select the Desired PDF File
            using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf");

            // Extract text from the PDF
            string allText = pdf.ExtractAllText();

            // Display the extracted text in a MessageBox
            // Only the first 1000 characters are shown for brevity
            MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK);
        }
    }
}
ImportsIronPdfNamespaceParsePdfPartialPublic Class Form1InheritsForm Public Sub New()InitializeComponent() ' Select the Desired PDF FileUsing pdf AsPdfDocument = PdfDocument.FromFile("MyDocument.pdf") ' Extract text from the PDF Dim allText AsString = pdf.ExtractAllText() ' Display the extracted text in a MessageBox ' Only the first 1000 characters are shown for brevityMessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)EndUsing End Sub End ClassEndNamespace
Imports IronPdf

Namespace ParsePdf
    Partial Public Class Form1
        Inherits Form

        Public Sub New()
            InitializeComponent()

            ' Select the Desired PDF File
            Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")

                ' Extract text from the PDF
                Dim allText As String = pdf.ExtractAllText()

                ' Display the extracted text in a MessageBox
                ' Only the first 1000 characters are shown for brevity
                MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
            End Using
        End Sub
    End Class
End Namespace
En este ejemplo, creamos una aplicación de Windows Forms que usa IronPDF para extraer texto de un archivo PDF seleccionado. El texto extraído se muestra en un cuadro de mensaje.
El análisis eficiente de PDFs desbloquea todo el potencial de los documentos digitales, permitiendo a las empresas automatizar procesos, reducir errores y ahorrar tiempo y dinero. Al dominar las técnicas y herramientas de análisis de PDFs, las organizaciones pueden mejorar la productividad y lograr más con sus activos digitales. IronPDF ofrece una solución ideal para desarrolladores que buscan trabajar programáticamente con documentos PDF.
Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.