更新日 2026年9月4日
月次口座明細書をPDF文書として生成する
IronPDF C# PDFライブラリを使用することで、開発者は外部サービスに依存することなく、.NETプロジェクト内でHTMLを信頼性の高いPDFファイルに変換することができます。
詳しく読む

PDFをプログラムで効率的に抽出して利用する能力は、PDFの内部形式の複雑さにより、開発者にとって独自の挑戦をもたらします。
IronPDFは、.NETプログラミングライブラリの一つで、PDFからコンテンツ(テキストと画像)を確実に抽出し、多くの他のPDF関連タスクを解決するのに役立つ開発者にとって独自の立場にあります。 IronPDFは、PDFの内部構造を理解する必要から解放し、プロジェクトを迅速かつ適時に提供することに焦点を置くことができます。
この記事では、PDFドキュメント解析の複雑さ、関与するツールと技術、そしてIronPDF .NETライブラリがPDFのコンテンツを把握するのにどのような変革的な影響を与えるかについて掘り下げます。
使いやすいツールの一つが無料オンラインPDF抽出ツールです。 ウェブサイトに移動すると、PDFをどのようにインポートし、どのようなデータを抽出できるかについてのツールの概要を見ることができます。
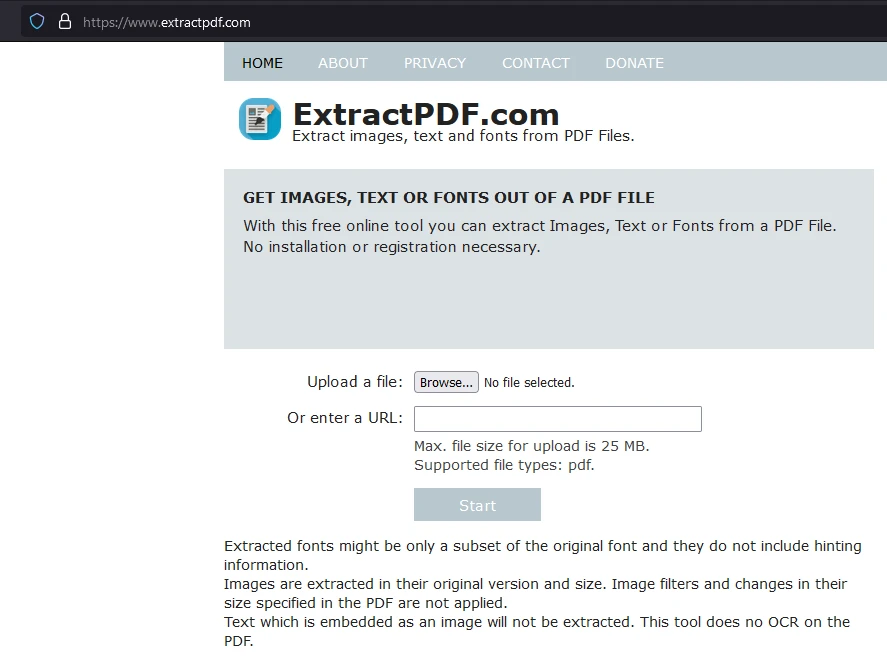
"Browse"をクリックして、データを抽出したいPDFファイルを選択します。
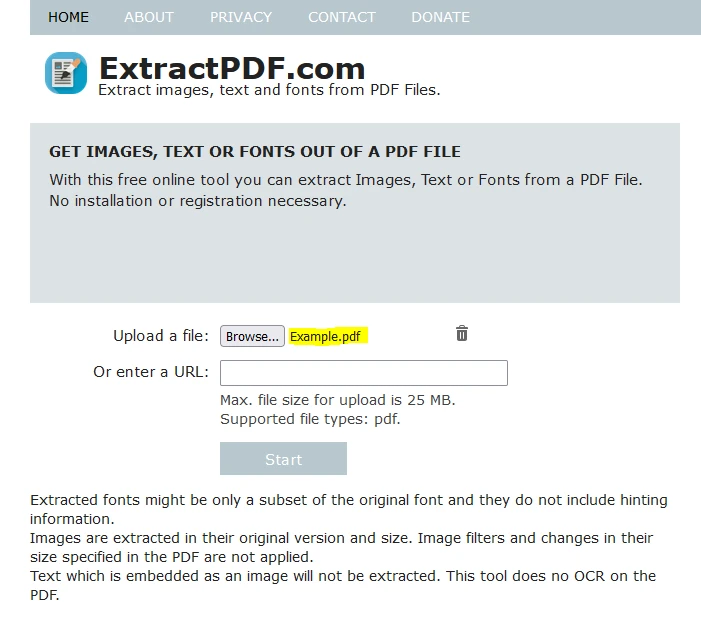
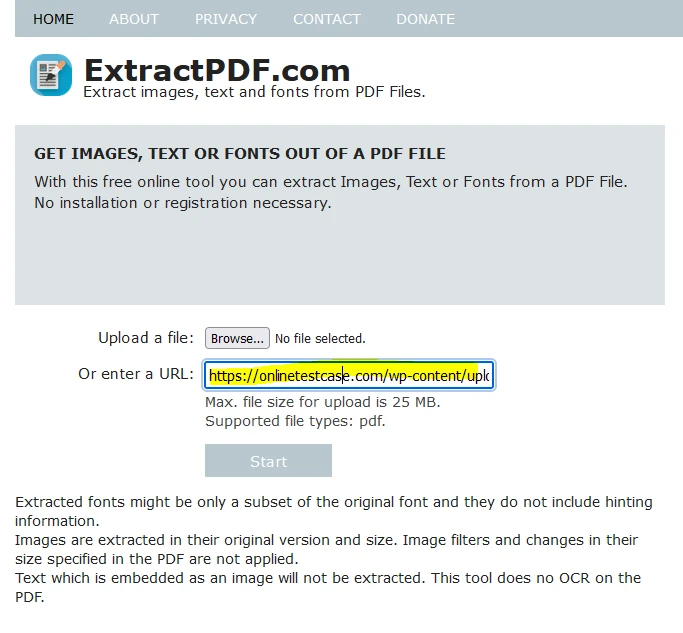
または、PDFへのリンクを貼り付けてファイルをアップロードすることもできます。
ファイルをアップロードした後、"Start"をクリックしてデータ抽出プロセスを開始します。 ツールは処理中にローディング画面を表示します。
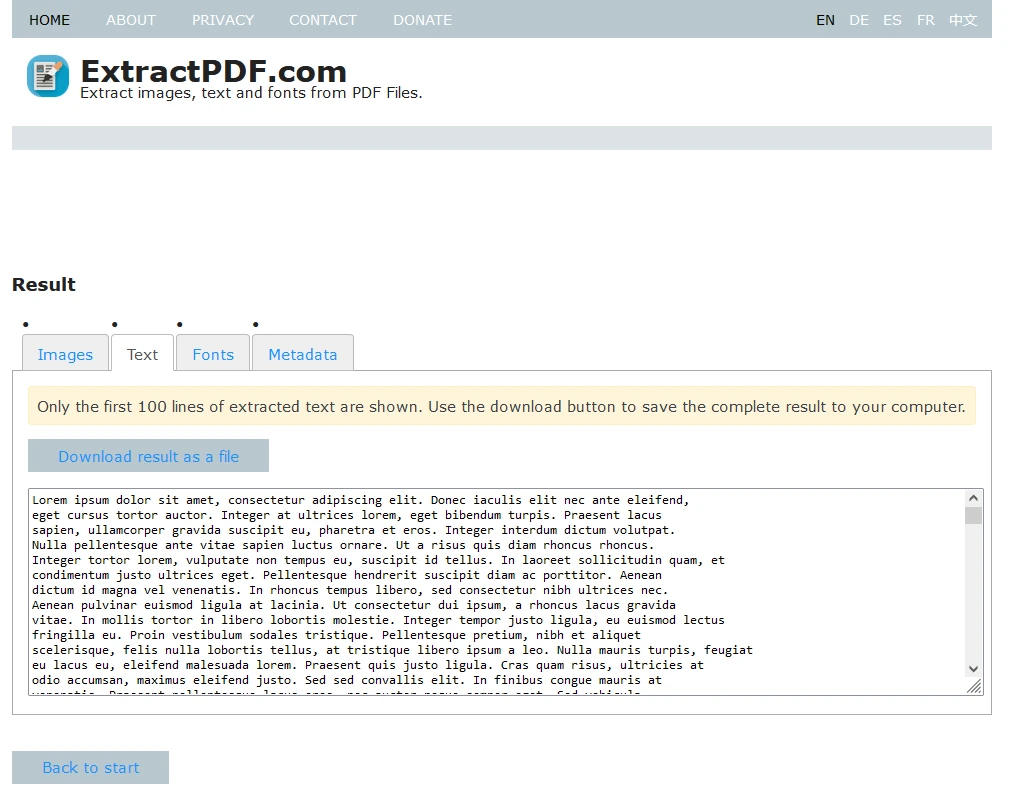
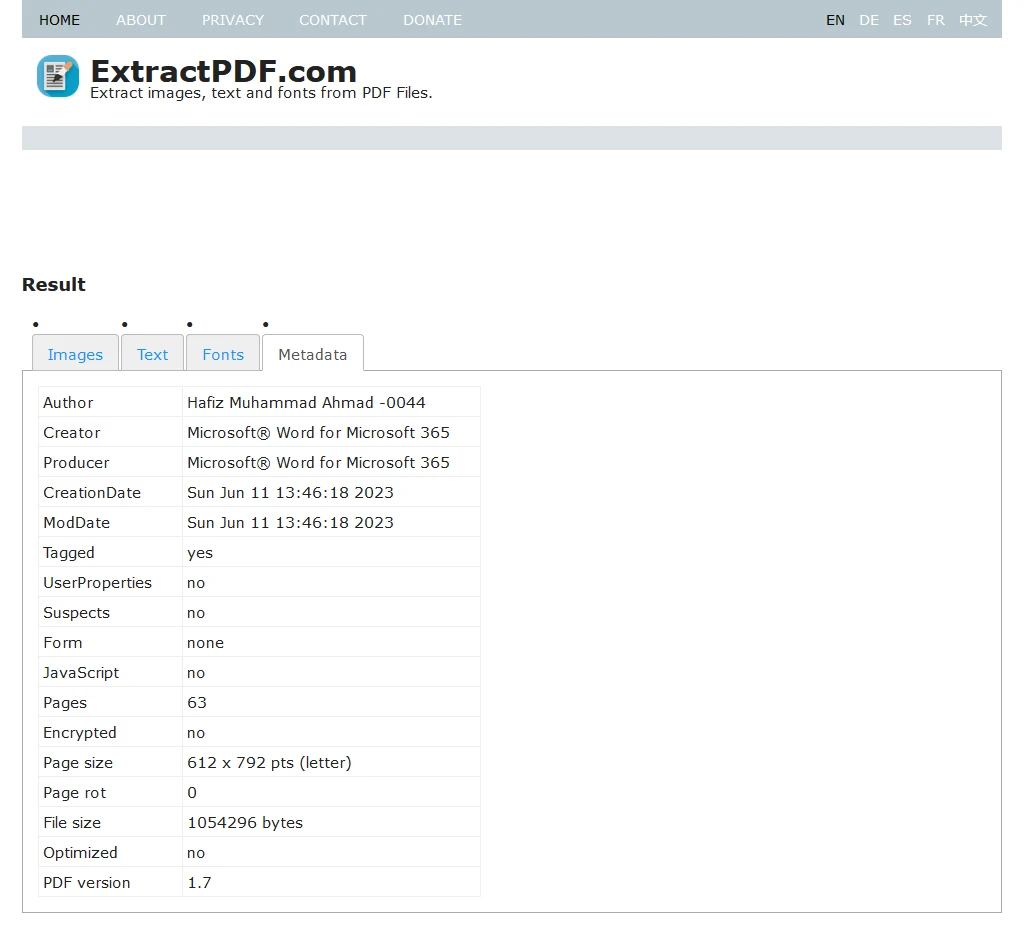
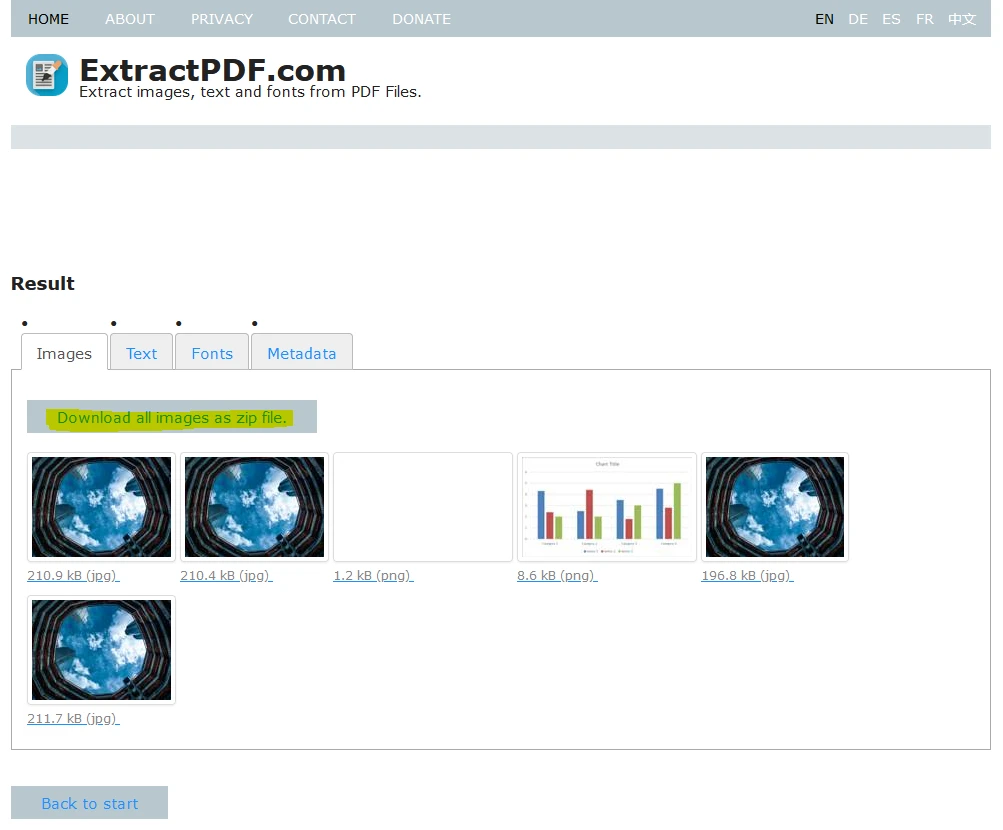
抽出が完了すると、データをダウンロードできます。 ツールは、PDFから抽出されたテキストや画像、フォント、メタデータを表形式で提供します。
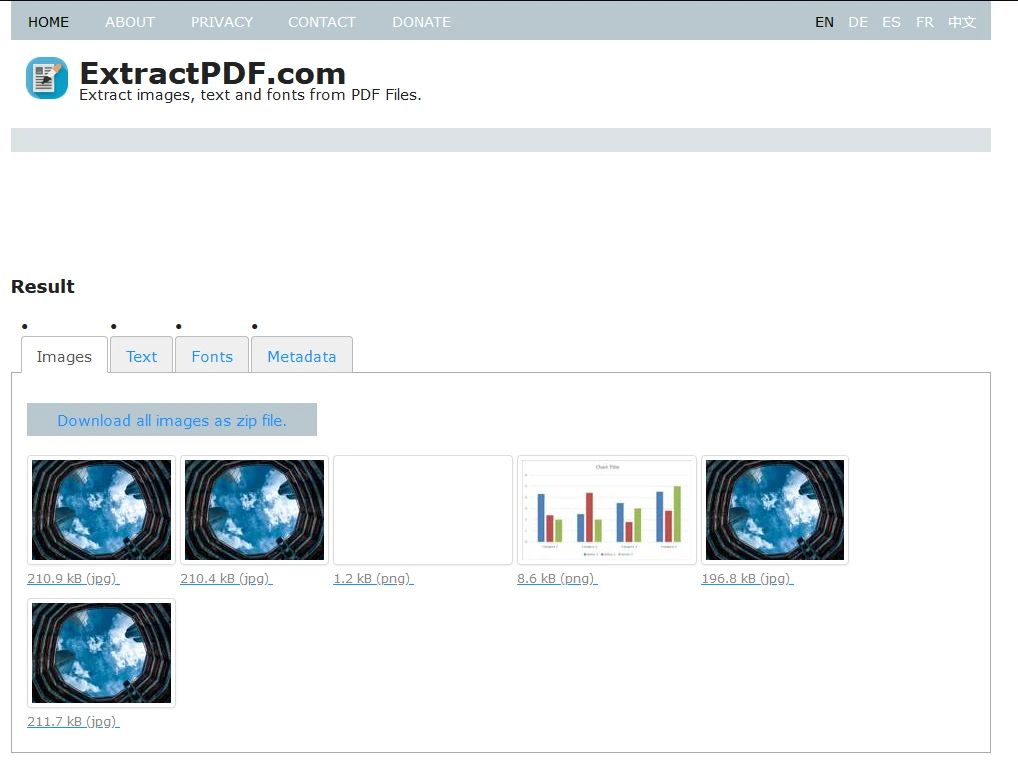
データベースにコピー可能なテキストは"Text"タブにあります。
ドキュメントのタイトル、著者、作成日などのメタデータは"Metadata"タブにあります。
最後に、抽出されたすべてのデータをZIPファイルとしてダウンロードできます。
Iron Softwareの強力なライブラリであるIronPDFを使用し、開発者はプログラムでPDFからデータを抽出することができます。 テキスト、テーブル、画像、およびPDFのメタデータ抽出を高効率でサポートします。
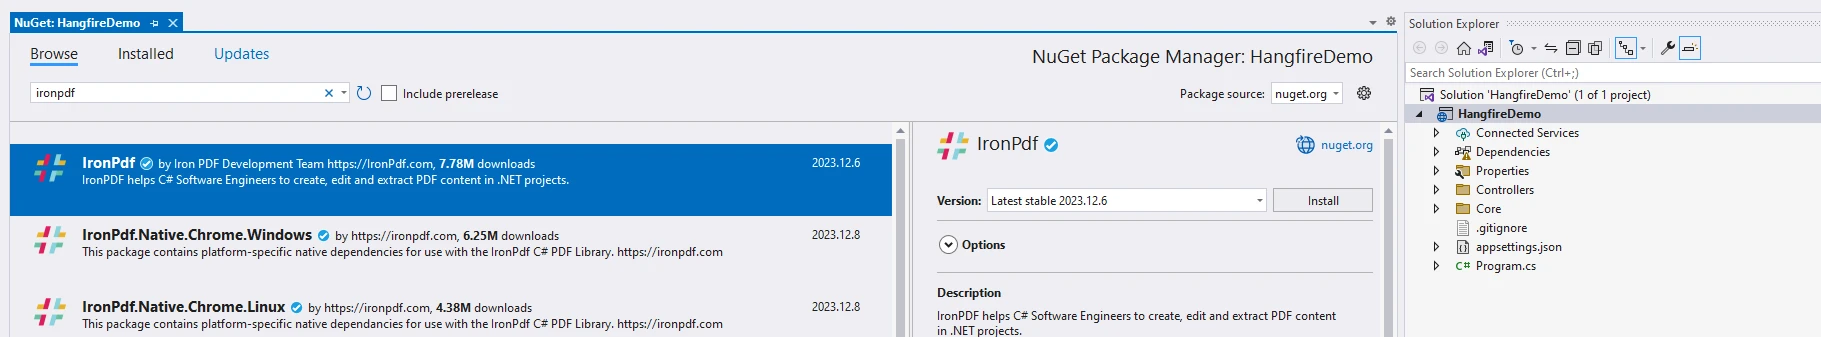
IronPDFは、Visual StudioにおけるNuGetのIronPDFパッケージマネージャーを通じてインストールできます。
Visual StudioでNuGetパッケージマネージャーに"IronPDF"を検索し、インストールをクリックします。
または、パッケージマネージャーコンソールでこのコマンドを使用します。
using IronPdf;

namespace ParsePdf
{
    public partial class Form1 : Form
    {
        public Form1()
        {
            InitializeComponent();

            // Select the Desired PDF File
            using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf");

            // Extract text from the PDF
            string allText = pdf.ExtractAllText();

            // Display the extracted text in a MessageBox
            // Only the first 1000 characters are shown for brevity
            MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK);
        }
    }
}Imports IronPdf
Namespace ParsePdf
Partial Public Class Form1
Inherits Form
Public Sub New()
InitializeComponent()
' Select the Desired PDF File
Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")
' Extract text from the PDF
Dim allText As String = pdf.ExtractAllText()
' Display the extracted text in a MessageBox
' Only the first 1000 characters are shown for brevity
MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
End Using
End Sub
End Class
End NamespaceImports IronPdf
Namespace ParsePdf
Partial Public Class Form1
Inherits Form
Public Sub New()
InitializeComponent()
' Select the Desired PDF File
Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")
' Extract text from the PDF
Dim allText As String = pdf.ExtractAllText()
' Display the extracted text in a MessageBox
' Only the first 1000 characters are shown for brevity
MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
End Using
End Sub
End Class
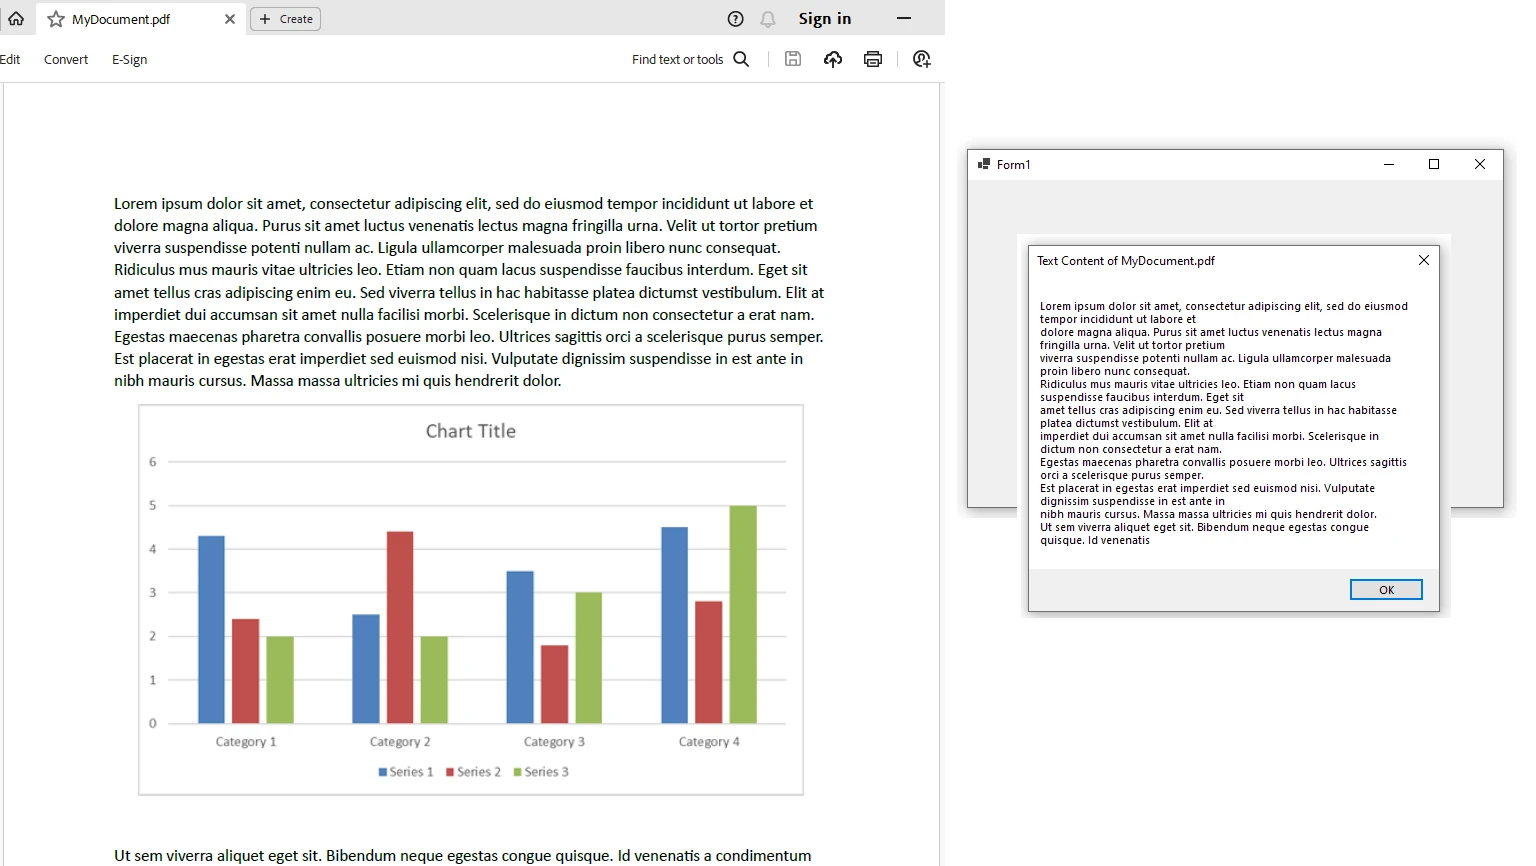
End Namespaceこの例では、IronPDFを使用して選択したPDFファイルからテキストを抽出し、抽出されたテキストをメッセージボックスに表示するWindows Formsアプリケーションを作成します。
IronPDFには、IronPDFからライセンスキーが必要で、無料の試用ライセンスの一部として取得できます。 ライセンスキーをappsettings.jsonファイルに追加してください:
{
  "IronPdf.LicenseKey": "your license key here"
}IronPDFのプロダクトライセンスページから無料の試用ライセンスをリクエストします。
効率的なPDF解析はデジタルドキュメントの完全な可能性を引き出し、ビジネスにおいてプロセスの自動化、エラーの削減、時間とコストの節約を可能にします。 PDF解析技術とツールを習得することにより、組織は生産性を向上させ、デジタル資産でより多くを達成することができます。 IronPDFは、PDFドキュメントをプログラムで扱いたい開発者に理想的なソリューションを提供します。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。

IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。