



已更新 2026年5月8日
生成每月账户报表(PDF 文档)
using IronPDF C# PDF 库,开发人员可以在 .NET 项目中将 HTML 转换为可靠的 PDF 文件,而无需依赖外部服务。
阅读更多

由于PDF内部格式的复杂性,程序化地高效提取和利用PDF数据给未来的开发者带来了独特的挑战。
IronPDF 是许多可用的.NET编程库之一,其独特之处在于能够帮助开发者克服从PDF中可靠提取内容(文本和图像)的挑战,以及处理许多其他与PDF相关的任务。 IronPDF使您无需了解PDF内部结构的细节,让您能够专注于快速按时交付项目。
本文深入探讨了PDF文档解析的复杂性、所涉及的工具和技术,以及IronPDF .NET库在帮助您掌握PDF内容方面的变革性影响。
一个易于使用的工具是免费在线PDF提取器。 导航到网站,您可以看到该工具的概述,包括如何导入PDF和可提取数据。
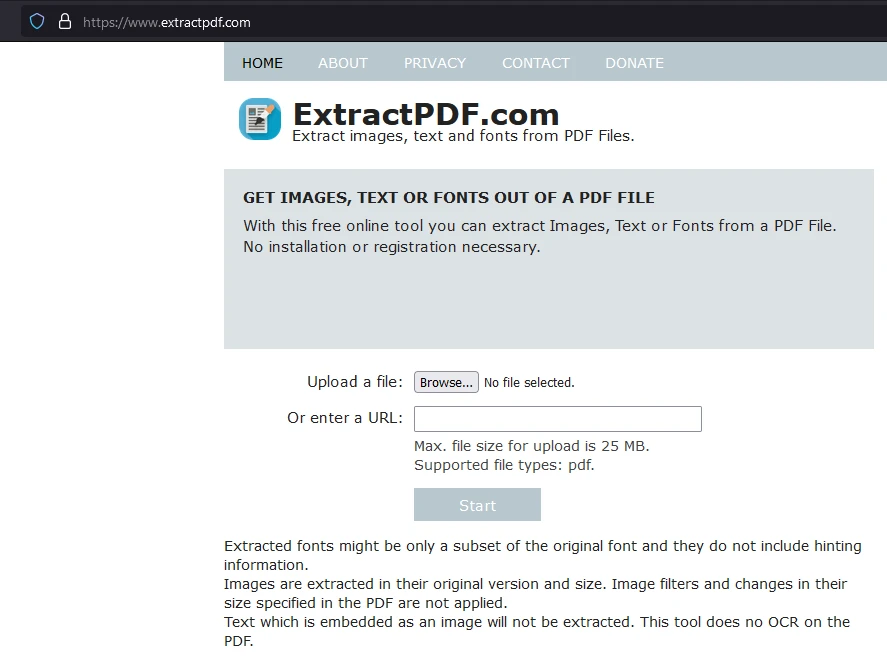
点击"浏览"以选择您希望提取数据的PDF文件。
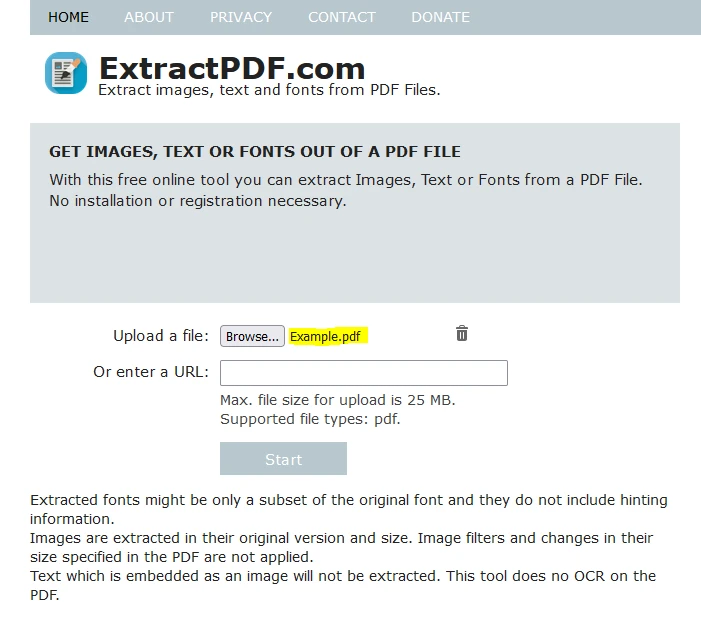
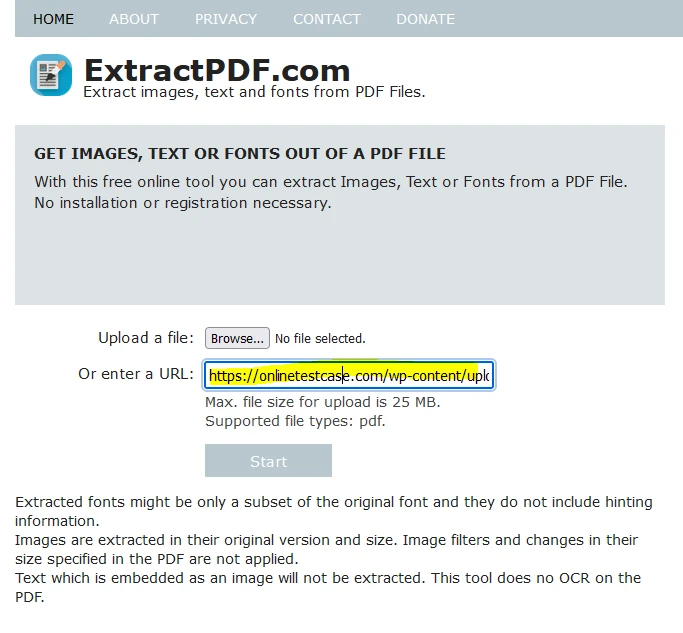
或者,您可以通过粘贴PDF链接来上传文件。
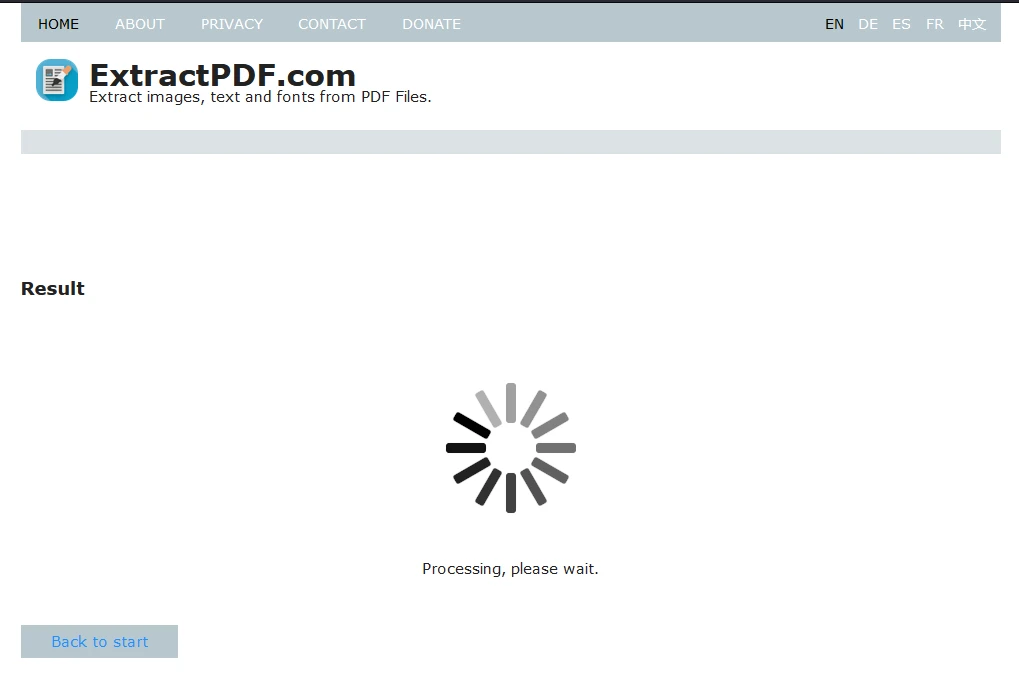
上传文件后,点击"开始"以开始数据提取过程。 工具将在处理过程中显示加载屏幕。
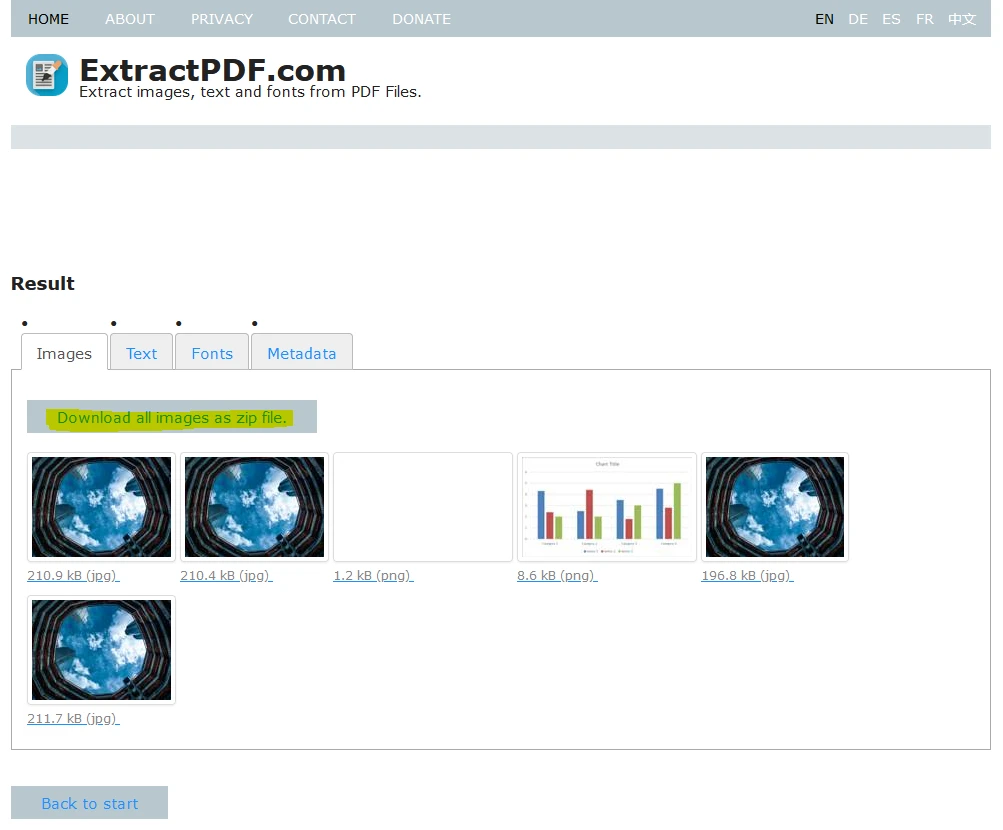
提取完成后,您可以下载数据。 工具以表格格式提供从PDF中提取的文本、图像、字体和元数据。
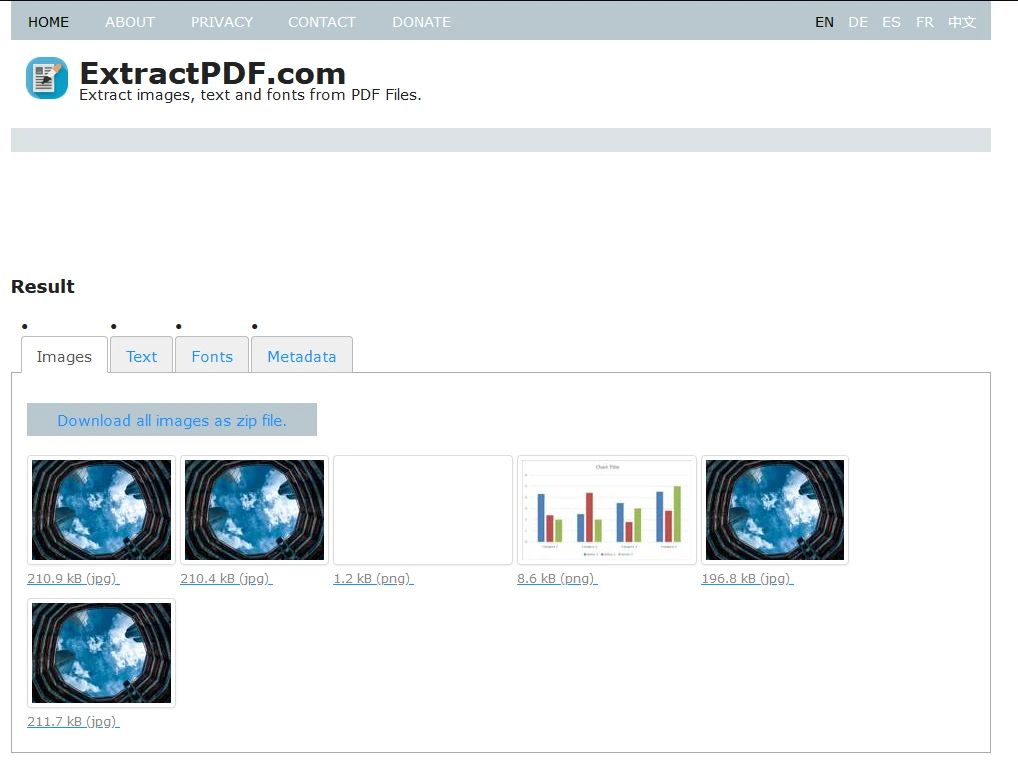
可复制到数据库的文本在"文本"选项卡下找到。
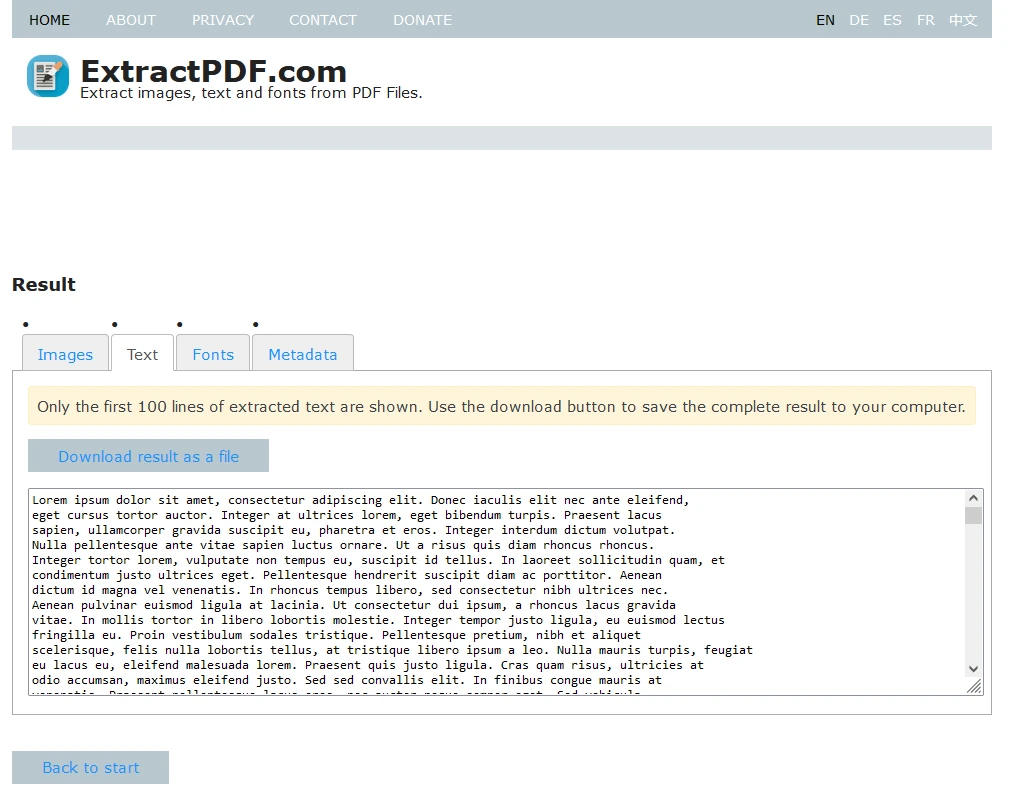
元数据,包括文档标题、作者、创建日期等,可在"元数据"选项卡下查看。
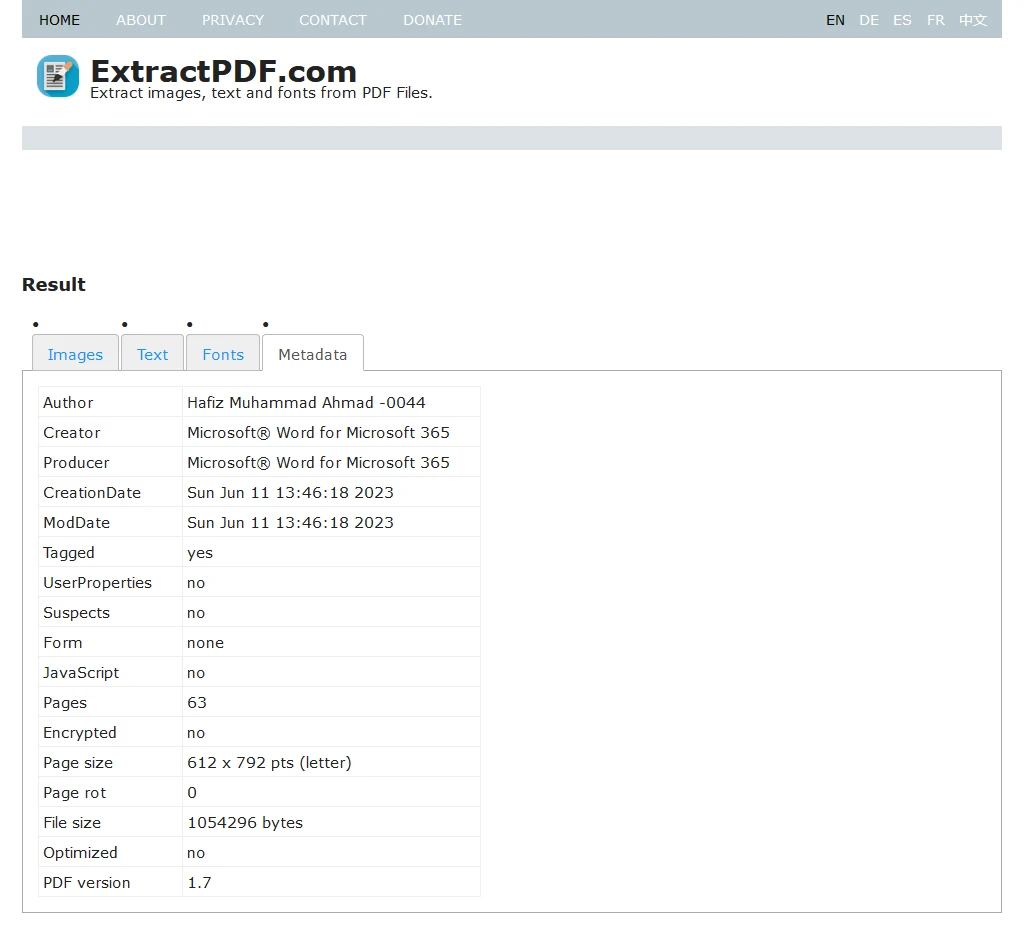
最后,您可以将所有提取的数据下载为ZIP文件。
IronPDF是Iron Software提供的一个强大的库,开发者可以使用它以编程方式从PDF中提取数据。 它支持高效提取文本、表格、图像和PDF元数据提取。
您可以通过Visual Studio中的IronPDF on NuGet包管理器安装IronPDF。
在Visual Studio中,在NuGet包管理器中搜索"IronPDF"并点击安装。
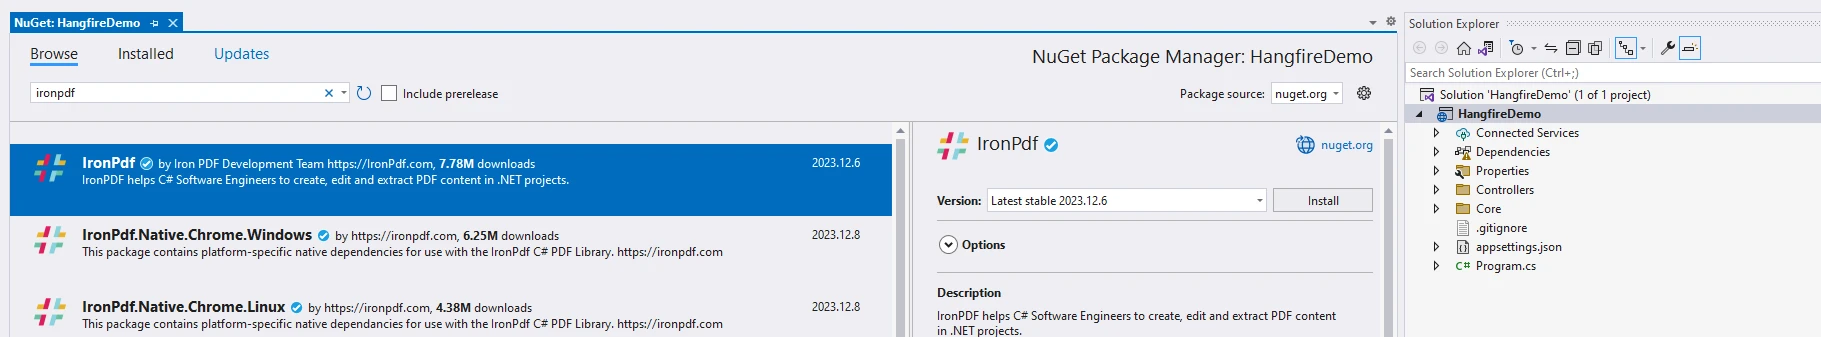
或者,在包管理器控制台中使用以下命令:
using IronPdf;

namespace ParsePdf
{
    public partial class Form1 : Form
    {
        public Form1()
        {
            InitializeComponent();

            // Select the Desired PDF File
            using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf");

            // Extract text from the PDF
            string allText = pdf.ExtractAllText();

            // Display the extracted text in a MessageBox
            // Only the first 1000 characters are shown for brevity
            MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK);
        }
    }
}Imports IronPdf
Namespace ParsePdf
Partial Public Class Form1
Inherits Form
Public Sub New()
InitializeComponent()
' Select the Desired PDF File
Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")
' Extract text from the PDF
Dim allText As String = pdf.ExtractAllText()
' Display the extracted text in a MessageBox
' Only the first 1000 characters are shown for brevity
MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
End Using
End Sub
End Class
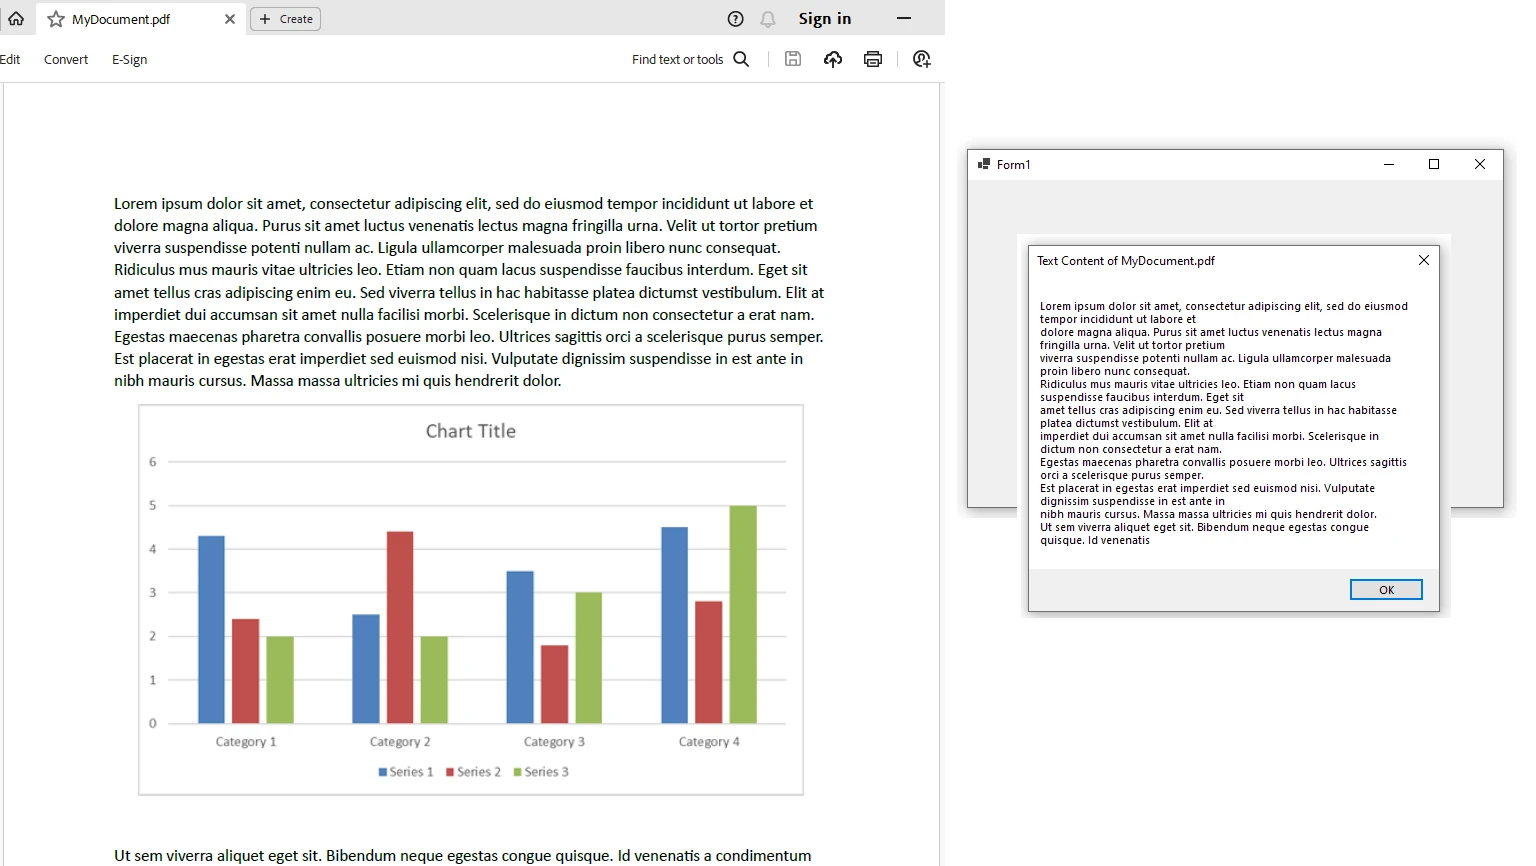
End Namespace在此示例中,我们创建一个使用IronPDF从选择的PDF文件中提取文本的Windows窗体应用程序。提取的文本随后显示在一个消息框中。
IronPDF需要IronPDF的许可密钥,您可以通过免费试用许可证获取。 将许可证密钥添加到您的appsettings.json文件中:
{
  "IronPdf.LicenseKey": "your license key here"
}高效的PDF解析释放了数字文档的全部潜力,使企业能够自动化流程,减少错误,节省时间和金钱。 通过掌握PDF解析技术和工具,组织可以提高生产力,并利用其数字资产取得更多成就。 IronPDF为希望以编程方式处理PDF文档的开发者提供了理想的解决方案。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





