已更新 2026年9月4日
產生每月帳戶報表(PDF 文件)
using IronPDF C# PDF 庫,開發人員可以在 .NET 專案中將 HTML 轉換為可靠的 PDF 文件,而無需依賴外部服務。
閱讀更多

由於PDF的內部格式複雜性,能夠有效地從PDF中提取和利用資料對於想要開發的開發者來說,這是一個獨特的挑戰。
IronPDF 是眾多可用的.NET 程式庫之一,它獨特地幫助開發者克服從PDF中可靠地提取內容(文字和圖像)的挑戰,以及許多其他PDF相關的任務。 IronPDF 讓您不必了解PDF的內部結構的細節,讓您專注於快速按時交付您的項目。
本文深入探討了PDF文件解析的復雜性、涉及的工具和技術,以及IronPDF .NET 程式庫 可以對幫助您掌握PDF内容産生的變革性影響。
一個易於使用的工具是免費的線上PDF提取器。 導航到網站, 您可以看到工具的概述,包括它如何導入PDF以及它可以提取哪些資料。
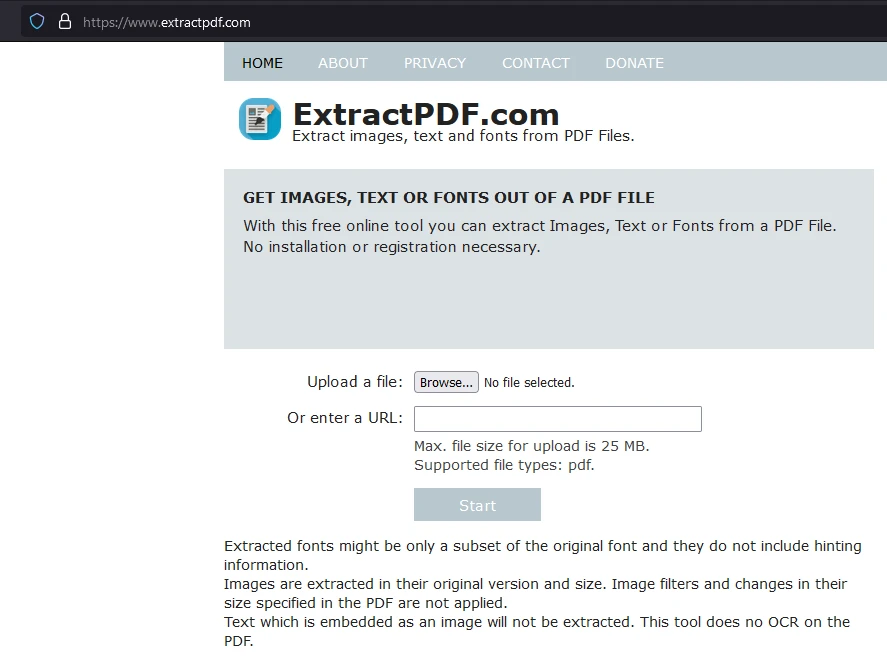
單擊"瀏覽"以選擇您想要從中提取資料的PDF文件。
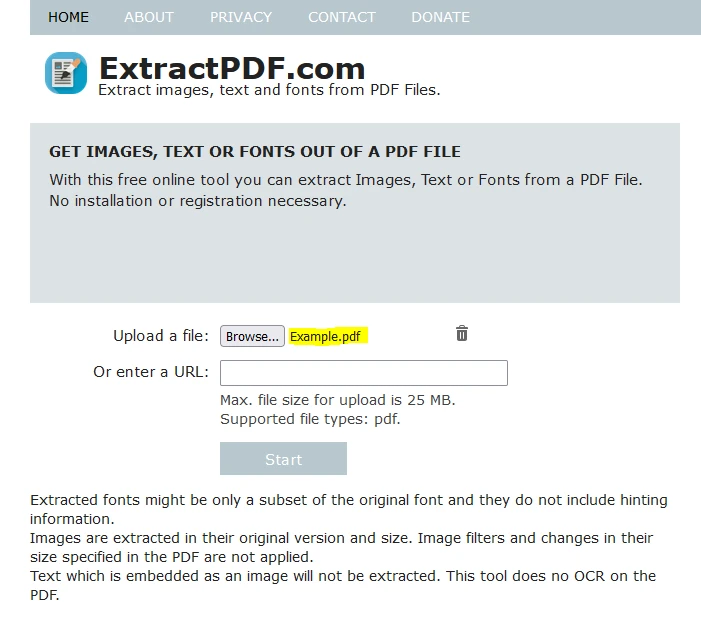
或者,您可以通過粘貼PDF的連結上傳文件。
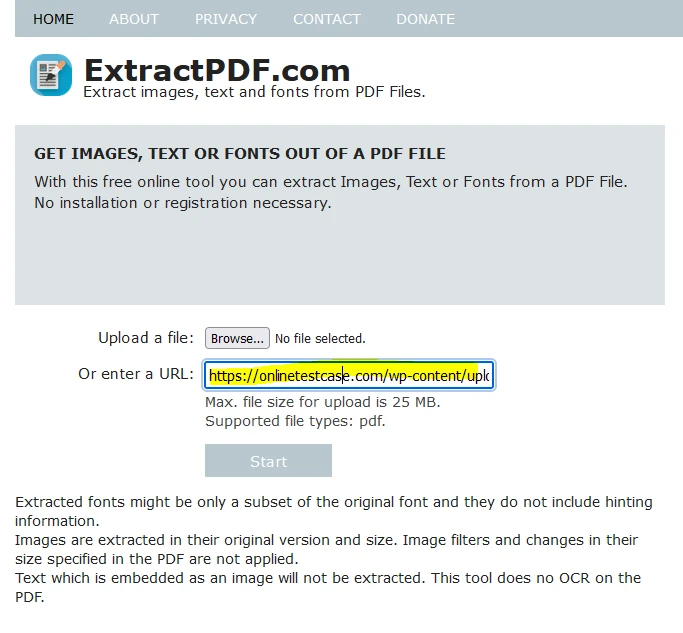
上傳文件後,單擊"開始"以開始資料提取過程。 工具將在處理過程中顯示載入螢幕。
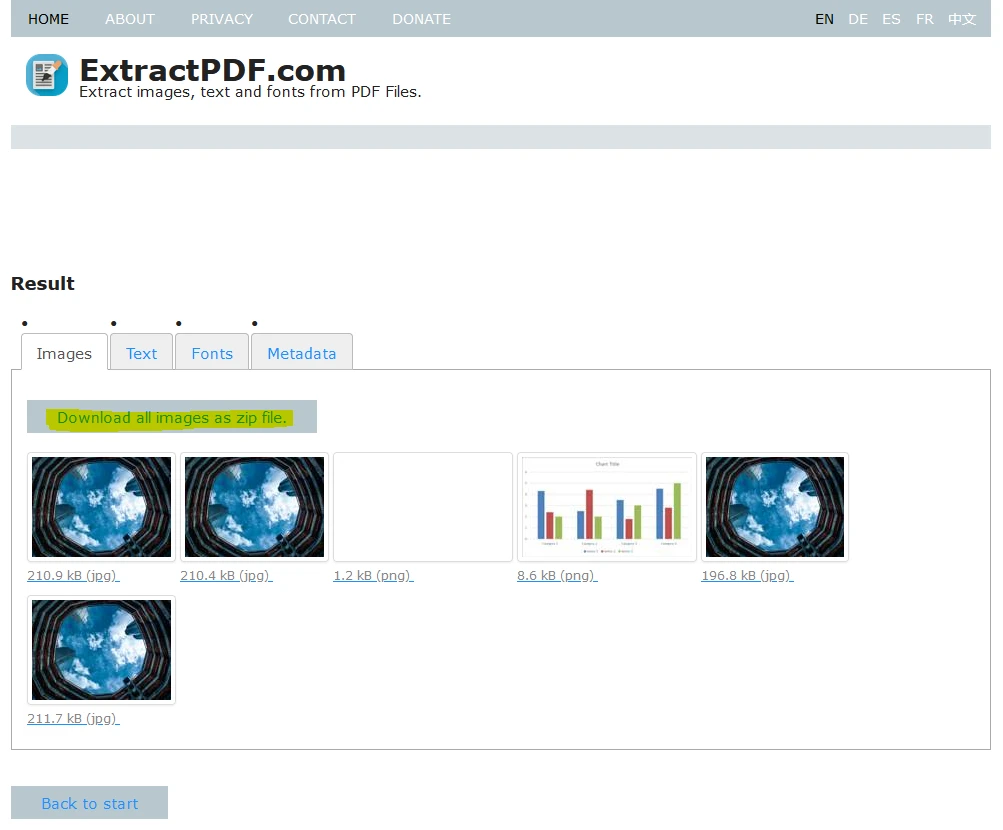
提取完成後,您可以下載資料。 工具提供從PDF中提取的文字、圖像、字體和元資料,以表格格式顯示。
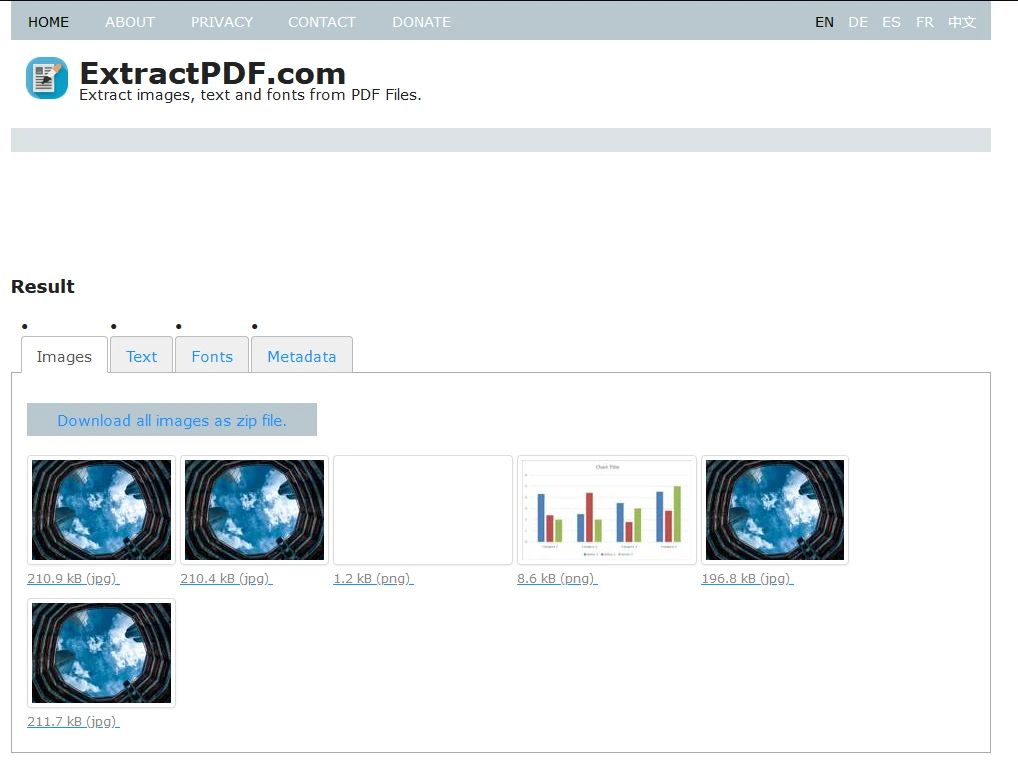
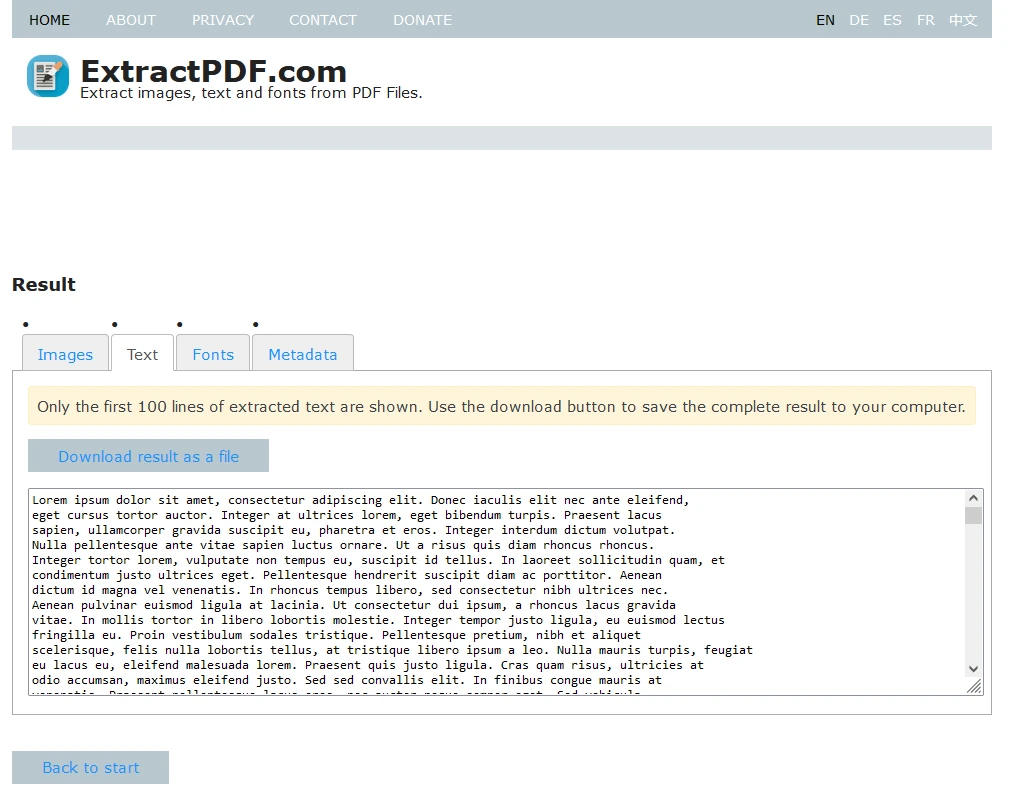
可以複製到資料庫的文字位於"文字"選項卡下。
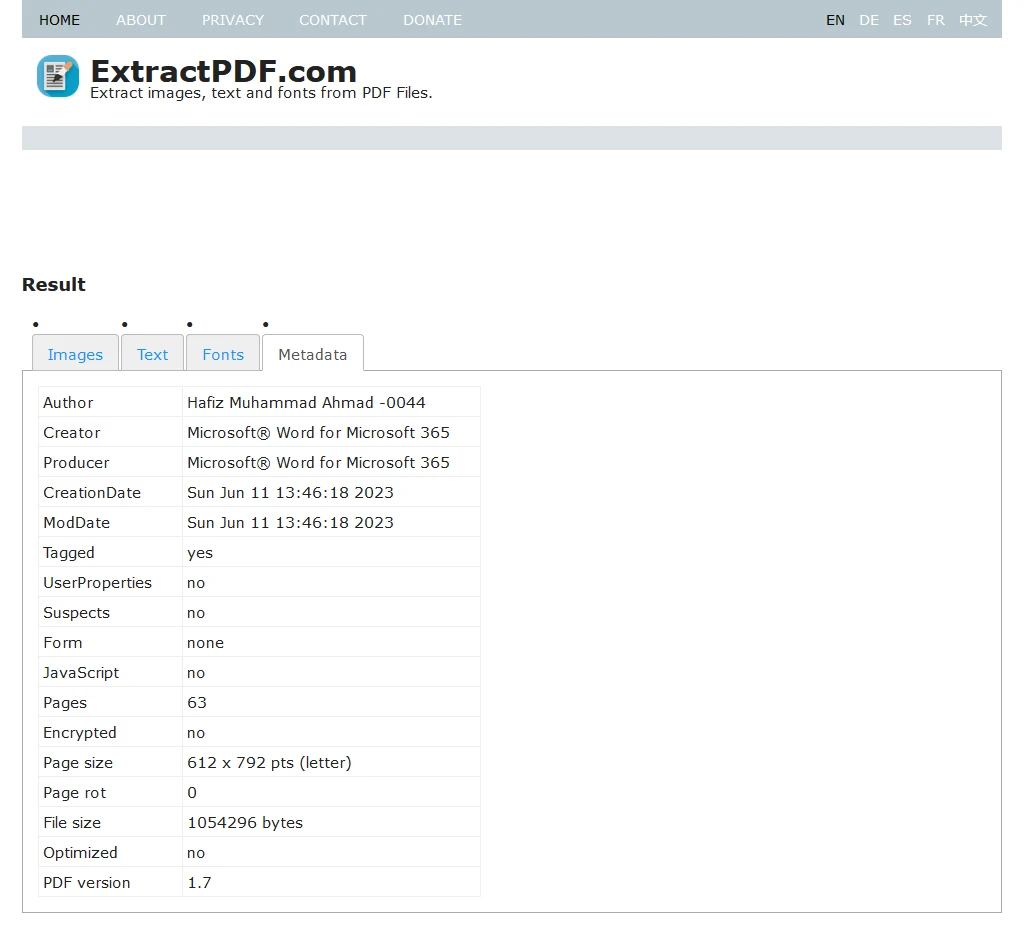
包括文件標題、作者、建立日期等元資料可在"元資料"選項卡下獲得。
最後,您可以將所有提取的資料下載為ZIP文件。
IronPDF是來自Iron Software的一個強大程式庫,開發者可以用來編程地從PDF中提取資料。 它支持高效提取文字、表格、圖像和PDF元資料提取。
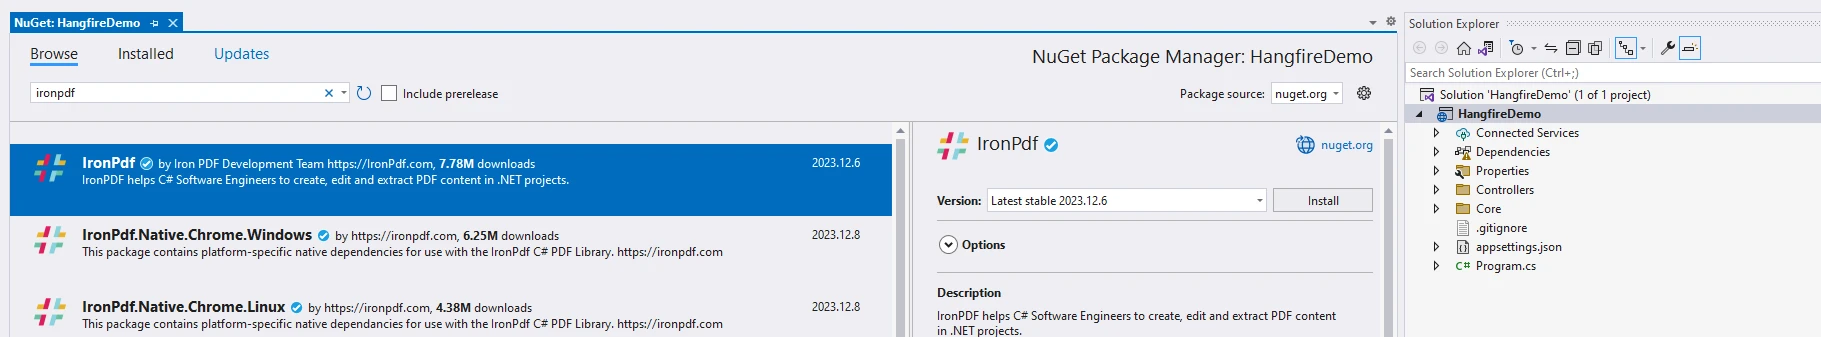
您可以通過Visual Studio中的IronPDF on NuGet套裝管理器安裝IronPDF。
在Visual Studio中, 在NuGet包管理器中搜索"IronPDF"並單擊安裝。
或者,使用此命令在包管理器控制台:
using IronPdf;

namespace ParsePdf
{
    public partial class Form1 : Form
    {
        public Form1()
        {
            InitializeComponent();

            // Select the Desired PDF File
            using PdfDocument pdf = PdfDocument.FromFile("MyDocument.pdf");

            // Extract text from the PDF
            string allText = pdf.ExtractAllText();

            // Display the extracted text in a MessageBox
            // Only the first 1000 characters are shown for brevity
            MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK);
        }
    }
}Imports IronPdf
Namespace ParsePdf
Partial Public Class Form1
Inherits Form
Public Sub New()
InitializeComponent()
' Select the Desired PDF File
Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")
' Extract text from the PDF
Dim allText As String = pdf.ExtractAllText()
' Display the extracted text in a MessageBox
' Only the first 1000 characters are shown for brevity
MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
End Using
End Sub
End Class
End NamespaceImports IronPdf
Namespace ParsePdf
Partial Public Class Form1
Inherits Form
Public Sub New()
InitializeComponent()
' Select the Desired PDF File
Using pdf As PdfDocument = PdfDocument.FromFile("MyDocument.pdf")
' Extract text from the PDF
Dim allText As String = pdf.ExtractAllText()
' Display the extracted text in a MessageBox
' Only the first 1000 characters are shown for brevity
MessageBox.Show(allText.Substring(0, 1000), "Text Content", MessageBoxButtons.OK)
End Using
End Sub
End Class
End Namespace在此範例中,我們建立了一個Windows Form應用程式,使用IronPDF 從選定的PDF文件中提取文字。 然後會在消息框中顯示提取的文字。
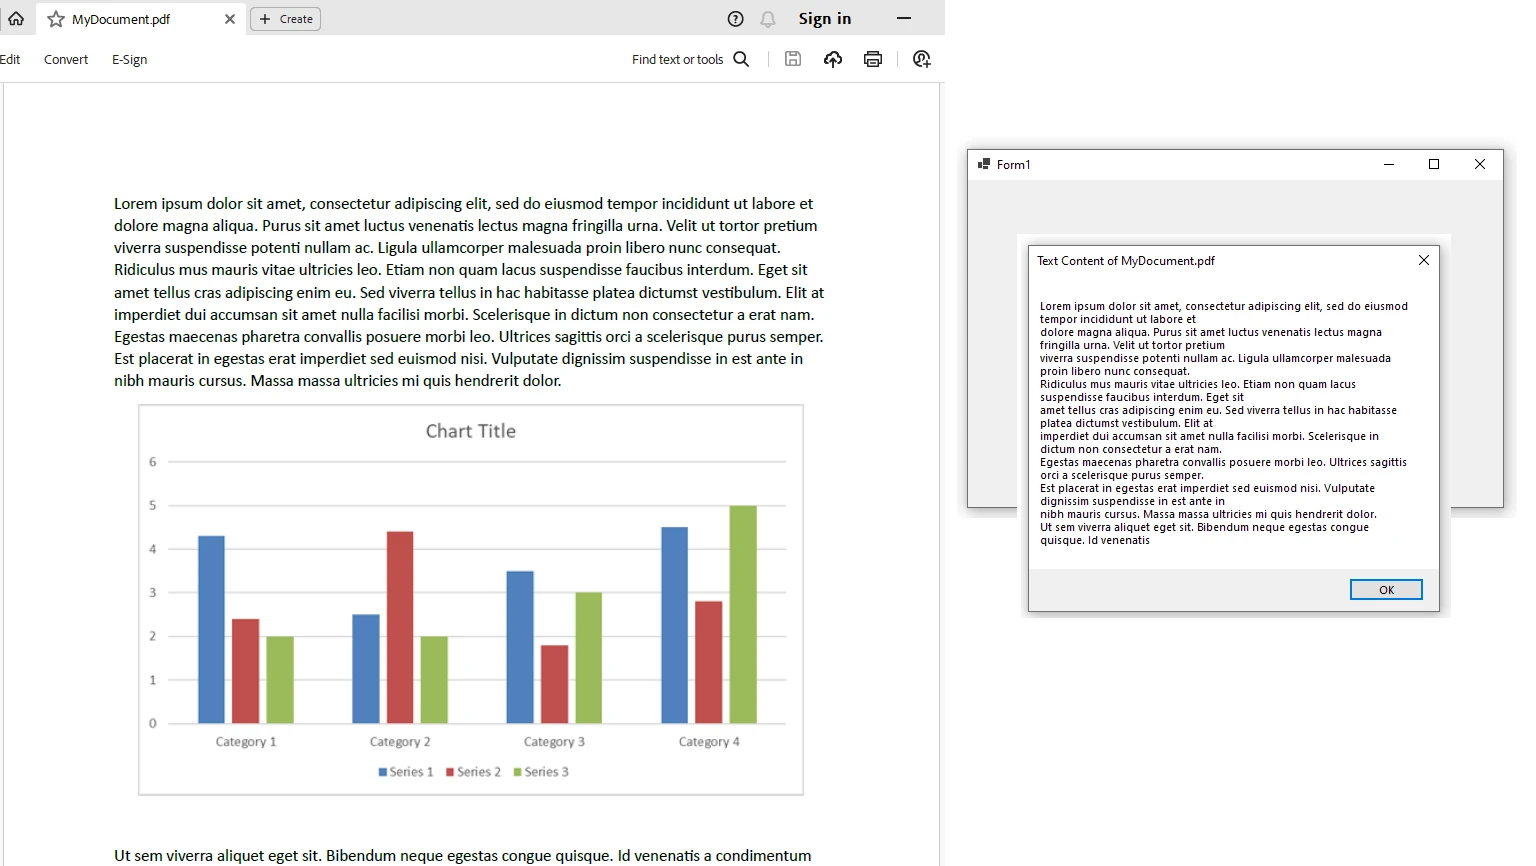
IronPDF需要從IronPDF 獲取免費試用授權的一部分的授權金鑰。 將授權金鑰新增到您的appsettings.json文件中:
{
  "IronPdf.LicenseKey": "your license key here"
}有效率的PDF解析釋放數位文件的全部潛力,使企業能夠自動化流程,減少錯誤,節省時間和金錢。 通過掌握PDF解析技術和工具,組織可以提高生產力,充分利用其數位資產。 IronPDF為開發者提供了一個理想的解決方案,讓其能夠編程方式處理PDF文件。
Curtis Chau擁有Carleton大學的電腦科學學士學位,專精於前端開發,擁有Node.js、TypeScript、JavaScript和React的專業知識。Curtis熱衷於建立直觀且美觀的使用者介面,喜愛使用現代框架並建立結構良好、視覺吸引力的手冊。

IronPDF 是 IRONSUITE 的一部分
10 款適用於辦公室文件的 .NET API 產品

當您需要您的PDF看起來像HTML一樣快速。