# Java PDF vers fichier image
Convertissez les documents PDF en formats image comme JPEG, PNG ou TIFF en Java en utilisant la méthode `toBufferedImages` d'IronPDF. Chargez un fichier PDF, appelez `toBufferedImages` pour obtenir une liste d'objets `BufferedImage`, puis écrivez chaque image sur le disque en utilisant `ImageIO`. La conversion complète prend moins de dix lignes de code Java fonctionnel.
*as-heading:2(Démarrage rapide : Convertir un PDF en images en Java)*
1. Ajoutez la dépendance IronPDF à votre projet Maven :
```xml :title=pom.xml
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>2024.9.1</version>
</dependency>
```
2. Chargez votre document PDF :
```java
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/load-pdf.java
PdfDocument pdf = PdfDocument.fromFile(Paths.get("document.pdf"));
```
3. Convertir en images et enregistrer :
```java
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-and-save.java
List<BufferedImage> images = pdf.toBufferedImages();
for (int i = 0; i < images.size(); i++) {
ImageIO.write(images.get(i), "PNG", new File("page_" + i + ".png"));
}
```
<div class="hsg-featured-snippet">
<h3>Comment convertir un PDF en image en Java</h3>
<ol>
<li><a class="js-modal-open" data-modal-id="download-modal" href="#download-modal">Installez la bibliothèque Java IronPDF</a></li>
<li>Chargez un fichier PDF en utilisant <code>PdfDocument.fromFile()</code></li>
<li>Appelez <code>toBufferedImages()</code> pour obtenir une <code>List<BufferedImage></code></li>
<li>Définissez les dimensions de sortie avec <code>ToImageOptions</code> si nécessaire</li>
<li>Écrivez chaque image sur le disque en utilisant <code>ImageIO.write()</code></li>
</ol>
</div>
## Qu'est-ce que la conversion de PDF en images et pourquoi est-elle nécessaire ?
La conversion de PDF en image transforme chaque page d'un document PDF en un fichier image autonome (JPEG, PNG ou TIFF) qui peut être affiché, intégré ou traité sans visualiseur PDF. Les bibliothèques standard de Java ne fournissent aucun mécanisme intégré pour cela, ce qui en fait un point de douleur persistant pour les développeurs qui ont besoin d'aperçus de documents, de générateurs de vignettes ou de pipelines d'archivage.
Les utilisations courantes incluent la génération d'aperçus de vignettes pour les systèmes de gestion de documents, la production de captures d'écran de niveau page pour les applications web, et l'extraction de contenu visuel pour les rapports ou les présentations. IronPDF gère toute la complexité du rendu en interne, de sorte que le code de l'application reste court et que le rendu est précis au pixel près, indépendamment des polices, des graphiques vectoriels ou des champs de formulaire dans le PDF source. Pour l'opération inverse de placement d'images dans un PDF, consultez le [guide de conversion d'image en PDF](https://ironpdf.com/how-to/image-to-pdf/).
## Qu'est-ce qu'IronPDF for Java et en quoi est-il utile?
[IronPDF for Java](/java/) est une bibliothèque pour créer, lire et éditer des fichiers PDF dans les projets basés sur Maven. Les développeurs l'utilisent pour générer des PDFs à partir de HTML, modifier des documents existants et extraire du contenu sans Adobe Acrobat ou aucun visualiseur PDF installé sur le serveur.
La bibliothèque prend en charge les en-têtes et pieds de page personnalisés, les signatures numériques, la création de formulaires, la protection par mot de passe, et le rendu multithread. Sa fonctionnalité de conversion de PDF en image expose une API claire à travers deux surcharges de `toBufferedImages` : une qui convertit chaque page avec les paramètres par défaut, et une qui accepte un objet `ToImageOptions` et un `PageSelection` pour contrôler la résolution et l'intervalle des pages. Pour une vue d'ensemble complète des fonctionnalités, visitez la [documentation IronPDF for Java](/java/docs/). Pour la référence API complète, consultez la [référence API Java](https://ironpdf.com/java/object-reference/api/).
Au-delà de la conversion de base, IronPDF prend en charge le [rendu HTML en PDF](https://ironpdf.com/java/tutorials/html-to-pdf/), des [filigranes personnalisés](https://ironpdf.com/java/how-to/custom-watermark/), des [arrière-plans et avant-plans](https://ironpdf.com/java/how-to/background-foreground/), ainsi que la [création de formulaires](https://ironpdf.com/java/how-to/create-forms/). Il fournit également des artefacts Maven sur le [dépôt Sonatype Maven Central](https://central.sonatype.com/artifact/com.ironsoftware/ironpdf), ainsi la gestion des dépendances suit les flux de travail standard de Maven ou Gradle.
## Quels sont les prérequis dont j'ai besoin avant de commencer ?
Avant de commencer, confirmez que les éléments suivants sont en place :
1. Java installé avec le chemin défini dans les Variables d'environnement. Voir le [guide d'installation Java officiel](https://www.java.com/en/download/help/download_options.html#windows).
2. Un IDE Java installé ; Eclipse ou IntelliJ fonctionnent bien. Téléchargez [Eclipse](https://www.eclipse.org/downloads/) ou [IntelliJ IDEA](https://www.jetbrains.com/idea/download/#section=windows).
3. Maven intégré à l'IDE. Voir ce [tutoriel d'installation de Maven](https://www.jetbrains.com/idea/guide/tutorials/marco-codes-maven/installing-maven/) pour IntelliJ.
4. [Clés de licence configurées](https://ironpdf.com/java/get-started/license-keys/) avant le déploiement en production.
## Comment installer IronPDF for Java?
Une fois que tous les prérequis sont en place, l'installation est une seule déclaration de dépendance Maven. Pour des étapes d'installation détaillées, consultez la [documentation de démarrage](https://ironpdf.com/java/docs/).
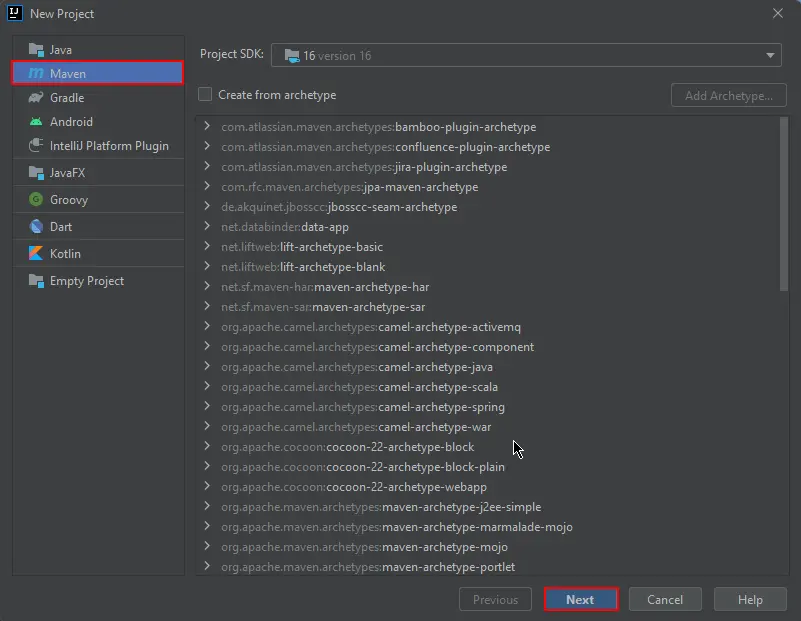
Ouvrez JetBrains IntelliJ IDEA et créez un nouveau projet Maven.
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-1.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-1.webp" alt="Boîte de dialogue Nouveau projet d'IntelliJ IDEA avec Maven sélectionné et le SDK Java 16 configuré pour l'installation d'IronPDF" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Créer un nouveau projet Maven</p>
</div>
</div>
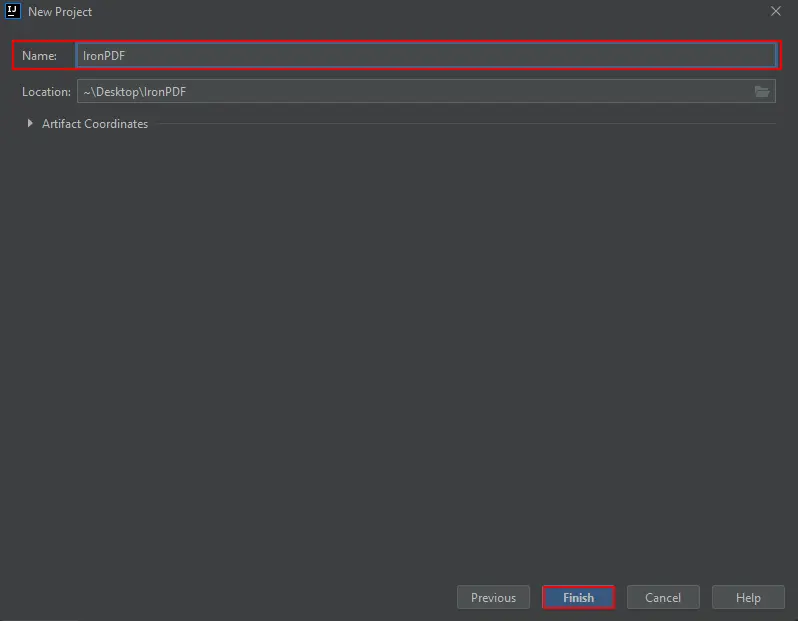
Une nouvelle fenêtre apparaît. Saisissez le nom du projet et cliquez sur Terminer.
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-2.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-2.webp" alt="Boîte de dialogue Nouveau projet d'IntelliJ IDEA montrant le champ de saisie du nom du projet et le dossier Bureau comme emplacement du projet" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Nouveau nom de projet</p>
</div>
</div>
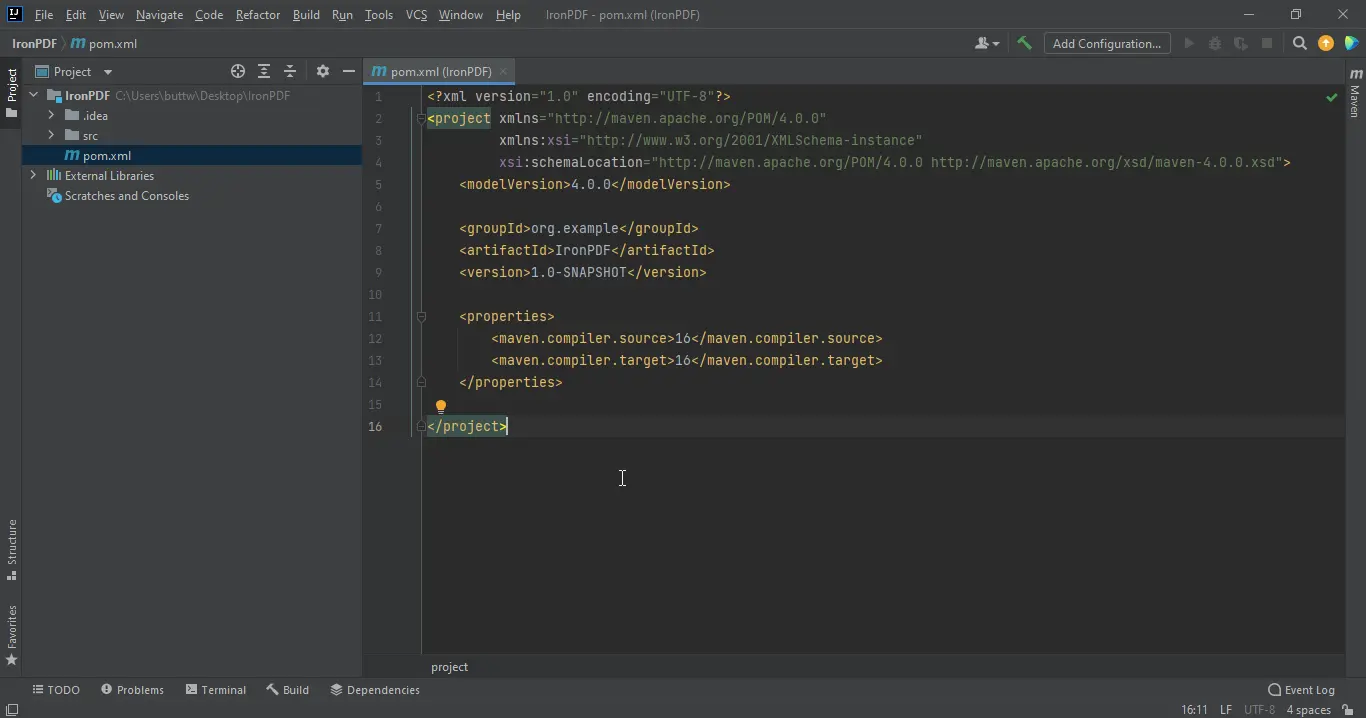
Après avoir cliqué sur Terminer, le nouveau projet s'ouvre avec `pom.xml` affiché par défaut. Ajoutez les dépendances suivantes à ce fichier. L'entrée SLF4J optionnelle supprime le bruit de journalisation pendant le développement ; retirez-la si votre projet inclut déjà un framework de journalisation.
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-3.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-3.webp" alt="IntelliJ IDEA affichant un pom.xml Maven vide avec les paramètres du compilateur Java 10, prêt pour l'ajout de la dépendance IronPDF" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Nouveau projet : fichier pom.xml par défaut</p>
</div>
</div>
```xml
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/pom-dependencies.xml
<dependencies>
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>2024.9.1</version>
</dependency>
<!-- Optional: SLF4J logging - remove if your project already uses a logging framework -->
<dependency>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-simple</artifactId>
<version>1.7.36</version>
</dependency>
</dependencies>
```
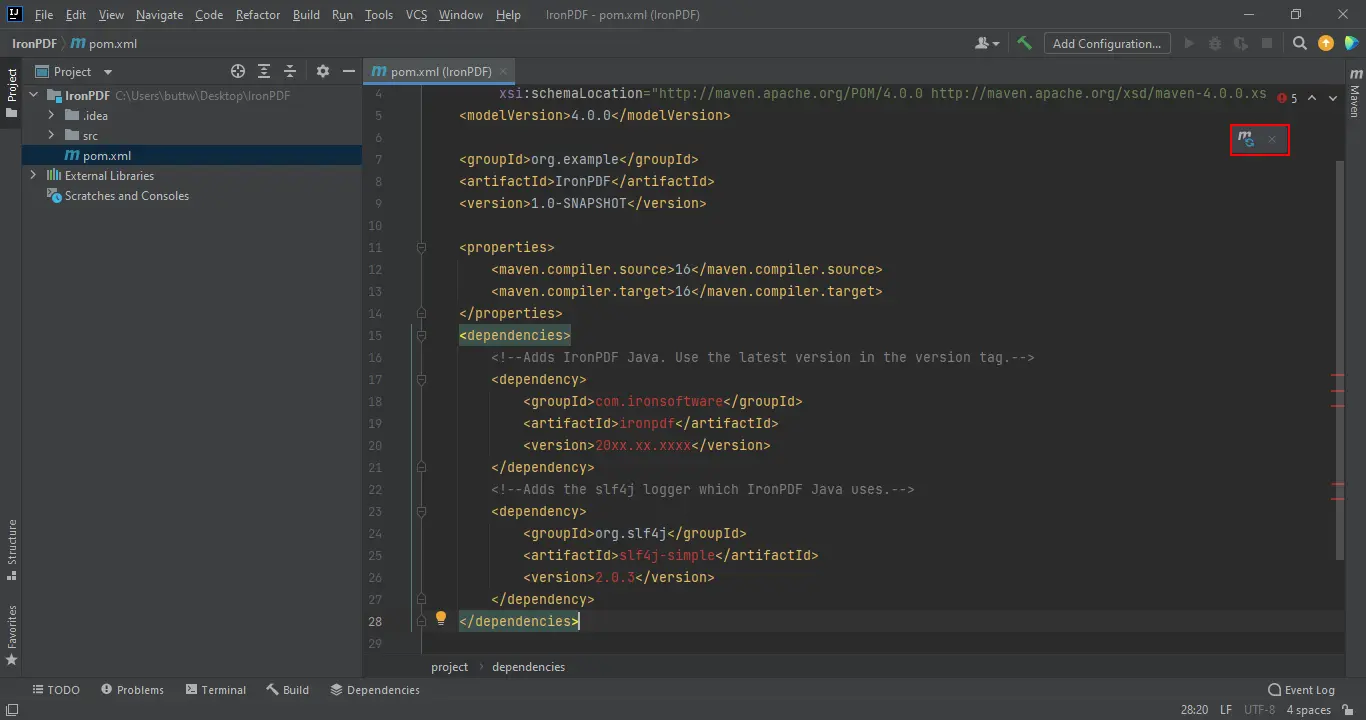
Une fois que les dépendances sont ajoutées à `pom.xml`, une icône de synchronisation Maven apparaît dans le coin supérieur droit de l'éditeur.
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-4.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-4.webp" alt="Fichier pom.xml Maven dans IntelliJ IDEA avec les blocs de dépendances IronPDF et SLF4J mis en évidence et l'icône de synchronisation Maven visible" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Dépendances Maven ajoutées</p>
</div>
</div>
Cliquez sur l'icône de synchronisation pour télécharger le JAR IronPDF. Le temps de téléchargement dépend de la vitesse de connexion, généralement moins de deux minutes. Après l'installation, consultez la [référence API Java](https://ironpdf.com/java/object-reference/api/) pour voir toutes les méthodes et options de configuration disponibles. Pour les cibles de déploiement dans le cloud, IronPDF propose des guides testés pour [AWS](https://ironpdf.com/java/get-started/aws/), [Azure](https://ironpdf.com/java/get-started/azure/), et [Google Cloud](https://ironpdf.com/java/get-started/google-cloud/).
## Comment convertir des fichiers PDF en images à l'aide d'IronPDF?
Appeler `toBufferedImages` sur un objet `PdfDocument` produit un `List<BufferedImage>` où chaque élément correspond à une page PDF dans l'ordre croissant des numéros de page. Le résultat peut ensuite être écrit sur le disque, passé à un pipeline de traitement d'images, ou renvoyé directement à une réponse web.
IronPDF convertit également les URLs et les chaînes HTML en PDF à la volée, ce qui permet de capturer n'importe quelle page web ou tout document HTML rendu en images dans un pipeline unique sans étape de rendu séparée.
### Comment convertir un document PDF existant en images?
`toBufferedImages` accepte un argument optionnel `ToImageOptions` pour contrôler les dimensions de sortie, et un argument `PageSelection` pour cibler des pages spécifiques. Lorsque aucun argument n'est passé, toutes les pages sont converties à leur résolution naturelle.
L'exemple ci-dessous convertit toutes les pages d'un PDF en fichiers PNG, en utilisant `ToImageOptions` pour limiter chaque image de sortie à 800x500 pixels :
```java
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-pdf-to-images.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.nio.file.Paths;
import java.util.List;
public class Main {
public static void main(String[] args) throws IOException {
// Load the PDF document from disk
PdfDocument pdf = PdfDocument.fromFile(Paths.get("business_plan.pdf"));
// Configure output image dimensions
ToImageOptions options = new ToImageOptions();
options.setImageMaxHeight(800);
options.setImageMaxWidth(500);
// Convert all pages to BufferedImage objects with the configured dimensions
List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages());
// Write each page image to the assets/images folder (create the folder first)
int pageIndex = 1;
for (BufferedImage page : pages) {
String fileName = "assets/images/" + pageIndex++ + ".png";
ImageIO.write(page, "PNG", new File(fileName));
}
}
}
```
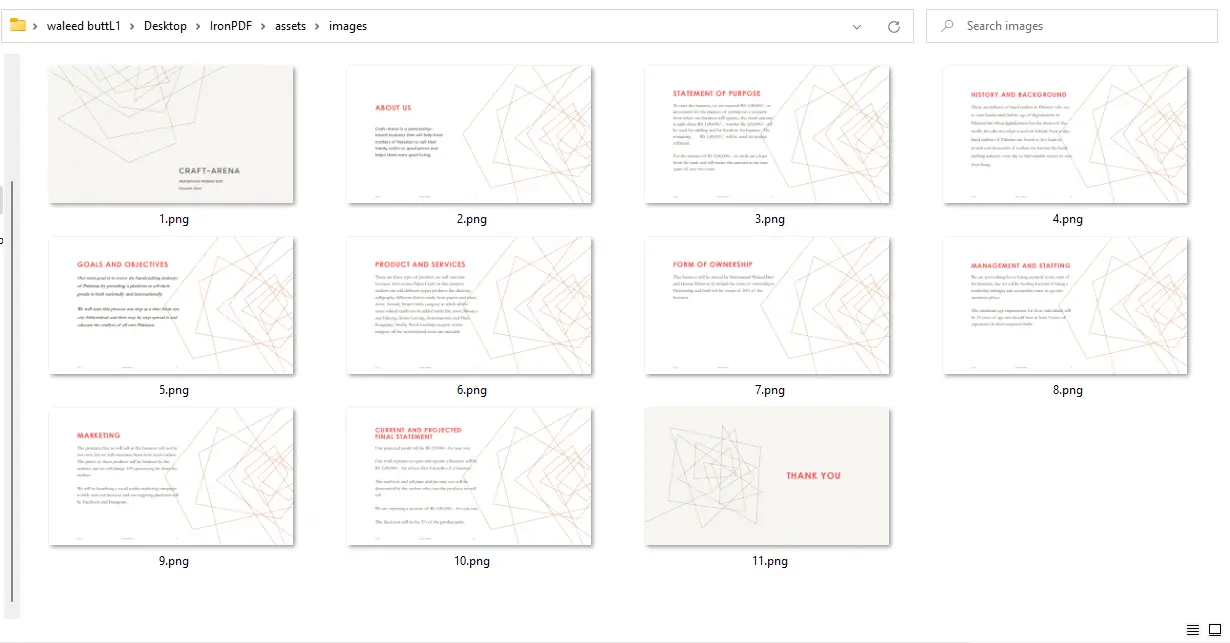
Les images de sortie sont enregistrées dans `assets/images/` avec des noms de fichiers numériques commençant par `1`. Créez ce dossier avant d'exécuter le programme, car `ImageIO.write` ne crée pas de répertoires manquants. Les appels `setImageMaxHeight` et `setImageMaxWidth` définissent des limites supérieures pour chaque dimension ; IronPDF préserve le rapport d'aspect original et n'étire pas l'image.
[[t:(Pour enregistrer au format JPEG au lieu de PNG, changez la chaîne de format dans `ImageIO.write` de `"PNG"` à `"JPEG"` et mettez à jour l'extension de fichier en conséquence.)]]
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-5.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-5.webp" alt="Explorateur de fichiers Windows affichant 11 fichiers image PNG numérotés dans le dossier assets/images après la conversion de PDF en images" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">PDF en Images - Sortie de 11 fichiers PNG, un par page</p>
</div>
</div>
Pour plus d'exemples de conversion, visitez la [page d'exemples de rastérisation de PDF](https://ironpdf.com/java/examples/rasterize-a-pdf-to-images/).
### Comment convertir une URL en images avec IronPDF ?
`PdfDocument.renderUrlAsPdf` récupère l'URL, la rend avec le moteur Chromium intégré, et renvoie un `PdfDocument` qui peut être immédiatement passé à `toBufferedImages`. Cela simplifie la capture de toute page web accessible publiquement en une série d'images.
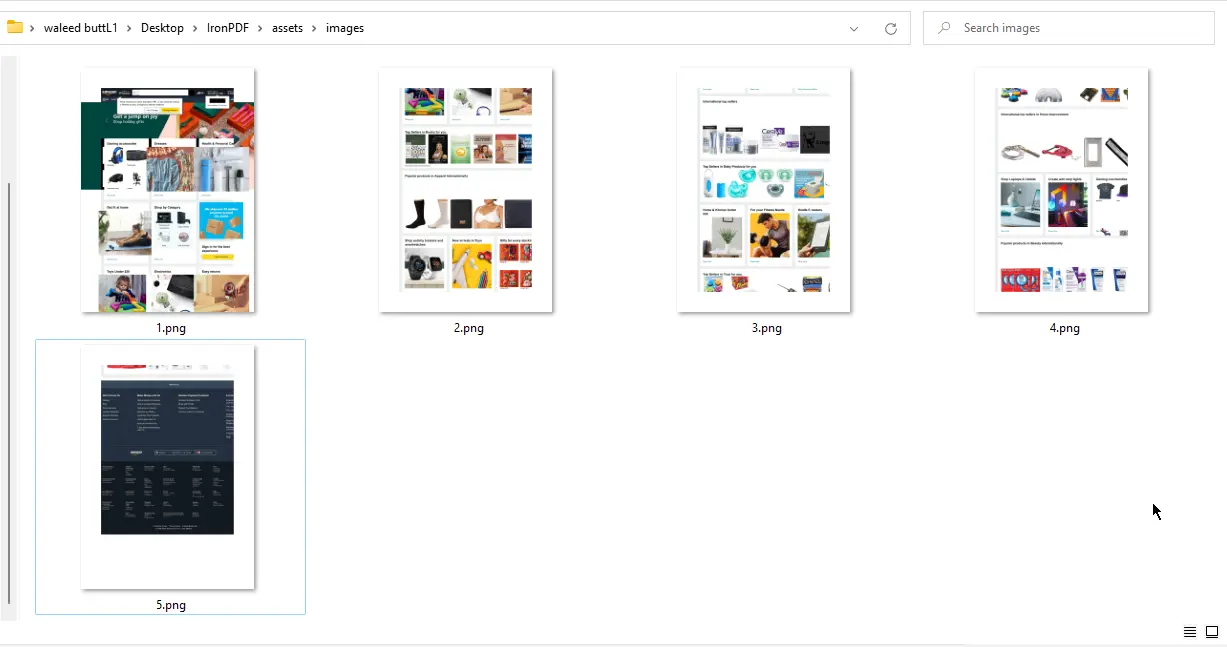
L'exemple ci-dessous rend une page produit Amazon en PDF puis enregistre chaque page résultante en tant que fichier PNG :
```java
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-url-to-images.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.util.List;
public class Main {
public static void main(String[] args) throws IOException {
// Render a URL to a PDF document using the Chromium rendering engine
PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com");
// Configure output image dimensions
ToImageOptions options = new ToImageOptions();
options.setImageMaxHeight(800);
options.setImageMaxWidth(500);
// Convert all pages and write to disk
List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages());
int pageIndex = 1;
for (BufferedImage page : pages) {
String fileName = "assets/images/" + pageIndex++ + ".png";
ImageIO.write(page, "PNG", new File(fileName));
}
}
}
```
<div class="content-img-align-center">
<div class="center-image-wrapper">
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-6.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-pdf-to-image/java-pdf-to-image-6.webp" alt="Explorateur de fichiers Windows affichant 5 fichiers PNG numérotés dans le dossier assets/images après la conversion d'une URL en images avec IronPDF" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">URL vers Images - Sortie de 5 fichiers PNG</p>
</div>
</div>
Pour les pages nécessitant une authentification ou des cookies de session avant le rendu, consultez le [guide sur les connexions aux sites web](https://ironpdf.com/java/examples/ironpdf-website-and-system-logins/).
[[i:(Le moteur de rendu Chromium qui alimente `renderUrlAsPdf` applique le même support CSS et JavaScript qu'un navigateur de bureau moderne. Les pages qui s'appuient sur JavaScript côté client pour charger le contenu se rendront correctement, y compris les applications monopage.)]]
### Comment convertir des pages spécifiques en images?
`PageSelection` fournit plusieurs méthodes de fabrication pour cibler un sous-ensemble de pages plutôt que l'ensemble du document. Cela est utile lorsque seule une page de couverture, une section de résumé ou une plage de pages connue doit être extraite.
```java
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/page-selection.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.nio.file.Paths;
import java.util.List;
public class PageSelectionExample {
public static void main(String[] args) throws IOException {
PdfDocument pdf = PdfDocument.fromFile(Paths.get("report.pdf"));
ToImageOptions options = new ToImageOptions();
options.setImageMaxHeight(800);
options.setImageMaxWidth(500);
// Convert only the first page (page index is zero-based)
List<BufferedImage> coverPage = pdf.toBufferedImages(options, PageSelection.singlePage(0));
ImageIO.write(coverPage.get(0), "PNG", new File("cover.png"));
// Convert pages 2 through 5 (zero-based indices 1 through 4)
List<BufferedImage> excerpt = pdf.toBufferedImages(options, PageSelection.pageRange(1, 4));
for (int i = 0; i < excerpt.size(); i++) {
ImageIO.write(excerpt.get(i), "PNG", new File("excerpt_" + (i + 1) + ".png"));
}
}
}
```
`PageSelection.singlePage(0)` cible uniquement la première page, ce qui est utile pour générer une miniature de couverture. `PageSelection.pageRange(1, 4)` extrait les pages deux à cinq en utilisant des indices basés sur zéro. Les deux renvoient un `List<BufferedImage>`, donc le schéma de boucle est identique quel que soit le nombre de pages sélectionnées.
[[n:(Les indices de pages dans `PageSelection` commencent à zéro : la première page est `0`, la seconde est `1`, et ainsi de suite. Passer un indice hors plage génère une `IndexOutOfBoundsException` en cours d'exécution.)]]
## Quelles sont les prochaines étapes pour la conversion de PDF en image en Java ?
Ce guide couvrait trois schémas courants : convertir toutes les pages d'un PDF existant, capturer une URL en images de page, et extraire une plage de pages cible. IronPDF gère le contrôle de la résolution et la sélection du format via `ToImageOptions` et `ImageIO`, en gardant le code d'appel court et prévisible.
Pour continuer à construire avec IronPDF for Java, explorez ces ressources connexes :
- [Exemples de rastérisation Java](https://ironpdf.com/java/examples/rasterize-a-pdf-to-images/) - échantillons de code supplémentaires de PDF en image
- [Extraire des images et du texte d'un PDF](https://ironpdf.com/java/examples/extract-image-from-pdf/) - extraire des images intégrées de fichiers PDF existants
- [Compresser des PDFs en Java](https://ironpdf.com/java/how-to/compress-pdf-java-tutorial/) - réduire la taille du fichier avant le stockage ou la transmission
- [Filigranes personnalisés](https://ironpdf.com/java/how-to/custom-watermark/) - tamponner des images de sortie ou des PDF avec un filigrane avant sauvegarde
- [Documentation IronPDF for Java](/java/docs/) - référence API complète et guides de configuration
IronPDF for Java est gratuit pour le développement. Une licence est requise pour le déploiement commercial. [Commencez votre essai gratuit](#trial-license) ou [voyez les options de licence](#licensing) pour voir quel plan convient à votre projet.
Prêt à voir ce qu'IronPDF peut faire d'autre ? Consultez la page de tutoriels [IronPDF for Java](/java/tutorials/html-to-pdf/) complète.
Convertissez les documents PDF en formats image comme JPEG, PNG ou TIFF en Java en utilisant la méthode toBufferedImages d'IronPDF. Chargez un fichier PDF, appelez toBufferedImages pour obtenir une liste d'objets BufferedImage, puis écrivez chaque image sur le disque en utilisant ImageIO. La conversion complète prend moins de dix lignes de code Java fonctionnel.
Démarrage rapide : Convertir un PDF en images en Java
Ajoutez la dépendance IronPDF à votre projet Maven :
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/load-pdf.javaPdfDocument pdf = PdfDocument.fromFile(Paths.get("document.pdf"));
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/load-pdf.java
PdfDocument pdf = PdfDocument.fromFile(Paths.get("document.pdf"));
Java
Convertir en images et enregistrer :
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-and-save.javaList<BufferedImage> images = pdf.toBufferedImages();for (int i = 0; i < images.size(); i++) {ImageIO.write(images.get(i), "PNG", newFile("page_" + i + ".png"));}
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-and-save.java
List<BufferedImage> images = pdf.toBufferedImages();
for (int i = 0; i < images.size(); i++) {
    ImageIO.write(images.get(i), "PNG", new File("page_" + i + ".png"));
}
Chargez un fichier PDF en utilisant PdfDocument.fromFile()
Appelez toBufferedImages() pour obtenir une List<BufferedImage>
Définissez les dimensions de sortie avec ToImageOptions si nécessaire
Écrivez chaque image sur le disque en utilisant ImageIO.write()
Qu'est-ce que la conversion de PDF en images et pourquoi est-elle nécessaire ?
La conversion de PDF en image transforme chaque page d'un document PDF en un fichier image autonome (JPEG, PNG ou TIFF) qui peut être affiché, intégré ou traité sans visualiseur PDF. Les bibliothèques standard de Java ne fournissent aucun mécanisme intégré pour cela, ce qui en fait un point de douleur persistant pour les développeurs qui ont besoin d'aperçus de documents, de générateurs de vignettes ou de pipelines d'archivage.
Les utilisations courantes incluent la génération d'aperçus de vignettes pour les systèmes de gestion de documents, la production de captures d'écran de niveau page pour les applications web, et l'extraction de contenu visuel pour les rapports ou les présentations. IronPDF gère toute la complexité du rendu en interne, de sorte que le code de l'application reste court et que le rendu est précis au pixel près, indépendamment des polices, des graphiques vectoriels ou des champs de formulaire dans le PDF source. Pour l'opération inverse de placement d'images dans un PDF, consultez le guide de conversion d'image en PDF.
Qu'est-ce qu'IronPDF for Java et en quoi est-il utile?
IronPDF for Java est une bibliothèque pour créer, lire et éditer des fichiers PDF dans les projets basés sur Maven. Les développeurs l'utilisent pour générer des PDFs à partir de HTML, modifier des documents existants et extraire du contenu sans Adobe Acrobat ou aucun visualiseur PDF installé sur le serveur.
La bibliothèque prend en charge les en-têtes et pieds de page personnalisés, les signatures numériques, la création de formulaires, la protection par mot de passe, et le rendu multithread. Sa fonctionnalité de conversion de PDF en image expose une API claire à travers deux surcharges de toBufferedImages : une qui convertit chaque page avec les paramètres par défaut, et une qui accepte un objet ToImageOptions et un PageSelection pour contrôler la résolution et l'intervalle des pages. Pour une vue d'ensemble complète des fonctionnalités, visitez la documentation IronPDF for Java. Pour la référence API complète, consultez la référence API Java.
Une fois que tous les prérequis sont en place, l'installation est une seule déclaration de dépendance Maven. Pour des étapes d'installation détaillées, consultez la documentation de démarrage.
Ouvrez JetBrains IntelliJ IDEA et créez un nouveau projet Maven.
Créer un nouveau projet Maven
Une nouvelle fenêtre apparaît. Saisissez le nom du projet et cliquez sur Terminer.
Nouveau nom de projet
Après avoir cliqué sur Terminer, le nouveau projet s'ouvre avec pom.xml affiché par défaut. Ajoutez les dépendances suivantes à ce fichier. L'entrée SLF4J optionnelle supprime le bruit de journalisation pendant le développement ; retirez-la si votre projet inclut déjà un framework de journalisation.
Nouveau projet : fichier pom.xml par défaut
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/pom-dependencies.xml<dependencies> <dependency> <groupId>com.ironsoftware</groupId> <artifactId>ironpdf</artifactId> <version>2024.9.1</version> </dependency> <!-- Optional: SLF4J logging - remove if your project already uses a logging framework --> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-simple</artifactId> <version>1.7.36</version> </dependency></dependencies>
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/pom-dependencies.xml
<dependencies>
    <dependency>
        <groupId>com.ironsoftware</groupId>
        <artifactId>ironpdf</artifactId>
        <version>2024.9.1</version>
    </dependency>
    <!-- Optional: SLF4J logging - remove if your project already uses a logging framework -->
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-simple</artifactId>
        <version>1.7.36</version>
    </dependency>
</dependencies>
XML
Une fois que les dépendances sont ajoutées à pom.xml, une icône de synchronisation Maven apparaît dans le coin supérieur droit de l'éditeur.
Dépendances Maven ajoutées
Cliquez sur l'icône de synchronisation pour télécharger le JAR IronPDF. Le temps de téléchargement dépend de la vitesse de connexion, généralement moins de deux minutes. Après l'installation, consultez la référence API Java pour voir toutes les méthodes et options de configuration disponibles. Pour les cibles de déploiement dans le cloud, IronPDF propose des guides testés pour AWS, Azure, et Google Cloud.
Comment convertir des fichiers PDF en images à l'aide d'IronPDF?
Appeler toBufferedImages sur un objet PdfDocument produit un List<BufferedImage> où chaque élément correspond à une page PDF dans l'ordre croissant des numéros de page. Le résultat peut ensuite être écrit sur le disque, passé à un pipeline de traitement d'images, ou renvoyé directement à une réponse web.
IronPDF convertit également les URLs et les chaînes HTML en PDF à la volée, ce qui permet de capturer n'importe quelle page web ou tout document HTML rendu en images dans un pipeline unique sans étape de rendu séparée.
Comment convertir un document PDF existant en images?
toBufferedImages accepte un argument optionnel ToImageOptions pour contrôler les dimensions de sortie, et un argument PageSelection pour cibler des pages spécifiques. Lorsque aucun argument n'est passé, toutes les pages sont converties à leur résolution naturelle.
L'exemple ci-dessous convertit toutes les pages d'un PDF en fichiers PNG, en utilisant ToImageOptions pour limiter chaque image de sortie à 800x500 pixels :
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-pdf-to-images.javaimport com.ironsoftware.ironpdf.PdfDocument;import com.ironsoftware.ironpdf.edit.PageSelection;import com.ironsoftware.ironpdf.image.ToImageOptions;import javax.imageio.ImageIO;import java.awt.image.BufferedImage;import java.io.File;import java.io.IOException;import java.nio.file.Paths;import java.util.List;public class Main { public static void main(String[] args) throws IOException { // Load the PDF document from disk PdfDocument pdf = PdfDocument.fromFile(Paths.get("business_plan.pdf")); // Configure output image dimensions ToImageOptions options = newToImageOptions(); options.setImageMaxHeight(800); options.setImageMaxWidth(500); // Convert all pages to BufferedImage objects with the configured dimensions List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages()); // Write each page image to the assets/images folder (create the folder first) int pageIndex = 1; for (BufferedImage page : pages) { String fileName = "assets/images/" + pageIndex++ + ".png";ImageIO.write(page, "PNG", newFile(fileName)); } }}
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-pdf-to-images.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        // Load the PDF document from disk
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("business_plan.pdf"));

        // Configure output image dimensions
        ToImageOptions options = new ToImageOptions();
        options.setImageMaxHeight(800);
        options.setImageMaxWidth(500);

        // Convert all pages to BufferedImage objects with the configured dimensions
        List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages());

        // Write each page image to the assets/images folder (create the folder first)
        int pageIndex = 1;
        for (BufferedImage page : pages) {
            String fileName = "assets/images/" + pageIndex++ + ".png";
            ImageIO.write(page, "PNG", new File(fileName));
        }
    }
}
Java
Les images de sortie sont enregistrées dans assets/images/ avec des noms de fichiers numériques commençant par 1. Créez ce dossier avant d'exécuter le programme, car ImageIO.write ne crée pas de répertoires manquants. Les appels setImageMaxHeight et setImageMaxWidth définissent des limites supérieures pour chaque dimension ; IronPDF préserve le rapport d'aspect original et n'étire pas l'image.
Conseils: Pour enregistrer au format JPEG au lieu de PNG, changez la chaîne de format dans ImageIO.write de "PNG" à "JPEG" et mettez à jour l'extension de fichier en conséquence.
PDF en Images - Sortie de 11 fichiers PNG, un par page
Comment convertir une URL en images avec IronPDF ?
PdfDocument.renderUrlAsPdf récupère l'URL, la rend avec le moteur Chromium intégré, et renvoie un PdfDocument qui peut être immédiatement passé à toBufferedImages. Cela simplifie la capture de toute page web accessible publiquement en une série d'images.
L'exemple ci-dessous rend une page produit Amazon en PDF puis enregistre chaque page résultante en tant que fichier PNG :
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-url-to-images.javaimport com.ironsoftware.ironpdf.PdfDocument;import com.ironsoftware.ironpdf.edit.PageSelection;import com.ironsoftware.ironpdf.image.ToImageOptions;import javax.imageio.ImageIO;import java.awt.image.BufferedImage;import java.io.File;import java.io.IOException;import java.util.List;public class Main { public static void main(String[] args) throws IOException { // Render a URL to a PDF document using the Chromium rendering engine PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com"); // Configure output image dimensions ToImageOptions options = newToImageOptions(); options.setImageMaxHeight(800); options.setImageMaxWidth(500); // Convert all pages and write to disk List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages()); int pageIndex = 1; for (BufferedImage page : pages) { String fileName = "assets/images/" + pageIndex++ + ".png";ImageIO.write(page, "PNG", newFile(fileName)); } }}
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/convert-url-to-images.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        // Render a URL to a PDF document using the Chromium rendering engine
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com");

        // Configure output image dimensions
        ToImageOptions options = new ToImageOptions();
        options.setImageMaxHeight(800);
        options.setImageMaxWidth(500);

        // Convert all pages and write to disk
        List<BufferedImage> pages = pdf.toBufferedImages(options, PageSelection.allPages());
        int pageIndex = 1;
        for (BufferedImage page : pages) {
            String fileName = "assets/images/" + pageIndex++ + ".png";
            ImageIO.write(page, "PNG", new File(fileName));
        }
    }
}
Veuillez noter: Le moteur de rendu Chromium qui alimente renderUrlAsPdf applique le même support CSS et JavaScript qu'un navigateur de bureau moderne. Les pages qui s'appuient sur JavaScript côté client pour charger le contenu se rendront correctement, y compris les applications monopage.
Comment convertir des pages spécifiques en images?
PageSelection fournit plusieurs méthodes de fabrication pour cibler un sous-ensemble de pages plutôt que l'ensemble du document. Cela est utile lorsque seule une page de couverture, une section de résumé ou une plage de pages connue doit être extraite.
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/page-selection.javaimport com.ironsoftware.ironpdf.PdfDocument;import com.ironsoftware.ironpdf.edit.PageSelection;import com.ironsoftware.ironpdf.image.ToImageOptions;import javax.imageio.ImageIO;import java.awt.image.BufferedImage;import java.io.File;import java.io.IOException;import java.nio.file.Paths;import java.util.List;public class PageSelectionExample { public static void main(String[] args) throws IOException { PdfDocument pdf = PdfDocument.fromFile(Paths.get("report.pdf")); ToImageOptions options = newToImageOptions(); options.setImageMaxHeight(800); options.setImageMaxWidth(500); // Convert only the first page (page index is zero-based) List<BufferedImage> coverPage = pdf.toBufferedImages(options, PageSelection.singlePage(0));ImageIO.write(coverPage.get(0), "PNG", newFile("cover.png")); // Convert pages 2 through 5 (zero-based indices 1 through 4) List<BufferedImage> excerpt = pdf.toBufferedImages(options, PageSelection.pageRange(1, 4)); for (int i = 0; i < excerpt.size(); i++) {ImageIO.write(excerpt.get(i), "PNG", newFile("excerpt_" + (i + 1) + ".png")); } }}
//:path=/static-assets/ironpdf-java/content-code-examples/how-to/java-pdf-to-image-tutorial/page-selection.java
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;
import com.ironsoftware.ironpdf.image.ToImageOptions;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.File;
import java.io.IOException;
import java.nio.file.Paths;
import java.util.List;

public class PageSelectionExample {
    public static void main(String[] args) throws IOException {
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("report.pdf"));
        ToImageOptions options = new ToImageOptions();
        options.setImageMaxHeight(800);
        options.setImageMaxWidth(500);

        // Convert only the first page (page index is zero-based)
        List<BufferedImage> coverPage = pdf.toBufferedImages(options, PageSelection.singlePage(0));
        ImageIO.write(coverPage.get(0), "PNG", new File("cover.png"));

        // Convert pages 2 through 5 (zero-based indices 1 through 4)
        List<BufferedImage> excerpt = pdf.toBufferedImages(options, PageSelection.pageRange(1, 4));
        for (int i = 0; i < excerpt.size(); i++) {
            ImageIO.write(excerpt.get(i), "PNG", new File("excerpt_" + (i + 1) + ".png"));
        }
    }
}
Java
PageSelection.singlePage(0) cible uniquement la première page, ce qui est utile pour générer une miniature de couverture. PageSelection.pageRange(1, 4) extrait les pages deux à cinq en utilisant des indices basés sur zéro. Les deux renvoient un List<BufferedImage>, donc le schéma de boucle est identique quel que soit le nombre de pages sélectionnées.
Important: Les indices de pages dans PageSelection commencent à zéro : la première page est 0, la seconde est 1, et ainsi de suite. Passer un indice hors plage génère une IndexOutOfBoundsException en cours d'exécution.
Quelles sont les prochaines étapes pour la conversion de PDF en image en Java ?
Ce guide couvrait trois schémas courants : convertir toutes les pages d'un PDF existant, capturer une URL en images de page, et extraire une plage de pages cible. IronPDF gère le contrôle de la résolution et la sélection du format via ToImageOptions et ImageIO, en gardant le code d'appel court et prévisible.
Pour continuer à construire avec IronPDF for Java, explorez ces ressources connexes :
Prêt à voir ce qu'IronPDF peut faire d'autre ? Consultez la page de tutoriels IronPDF for Java complète.
Questions Fréquemment Posées
Comment convertir un fichier PDF en images PNG en Java ?
Chargez le PDF en utilisant PdfDocument.fromFile(), appelez toBufferedImages() pour obtenir une liste d'objets BufferedImage représentant chaque page, puis utilisez ImageIO.write() pour enregistrer chaque image en tant que fichier PNG.
Quels formats d'image sont disponibles pour la conversion des pages PDF?
La méthode toBufferedImages d'IronPDF renvoie des objets BufferedImage. Vous pouvez les enregistrer dans n'importe quel format pris en charge par la classe ImageIO de Java, notamment PNG, JPEG et TIFF.
Puis-je convertir seulement certaines pages d'un PDF en images?
Oui. Passez un argument PageSelection à toBufferedImages. Utilisez PageSelection.singlePage(0) pour convertir une seule page ou PageSelection.pageRange(1, 4) pour convertir une plage. Les index des pages commencent à zéro.
Quels sont les cas d'utilisation courants pour la conversion de PDF en images en Java?
Les cas d'utilisation courants incluent la génération d'aperçus miniatures pour les systèmes de gestion de documents, la production de captures d'écran au niveau de la page pour les applications web, l'extraction de contenu visuel pour des présentations, et l'archivage de documents sous forme de fichiers image pour les systèmes qui ne prennent pas en charge le rendu PDF.
Comment ajouter IronPDF à mon projet Maven ?
Ajoutez la dépendance suivante à l'intérieur du bloc <dependencies> de votre pom.xml: <dependency><groupId>com.ironsoftware</groupId><artifactId>ironpdf</artifactId><version>2024.9.1</version></dependency>
Puis-je convertir une URL directement en fichiers image?
Oui. Appelez PdfDocument.renderUrlAsPdf(url) pour rendre la page en utilisant le moteur Chromium intégré, puis passez le PdfDocument résultant à toBufferedImages pour obtenir une liste d'images de page.
Comment contrôler la résolution de l'image de sortie?
Créez une instance ToImageOptions, appelez setImageMaxHeight() et setImageMaxWidth() pour définir des dimensions maximales, puis passez-la en premier argument à toBufferedImages. IronPDF préserve le rapport d'aspect et ne déforme pas l'image.
What are the output image formats that IronPDF supports?
IronPDF supports converting PDFs to various image formats, including JPEG, PNG, and TIFF.
How does IronPDF handle conversion of multi-page PDFs?
IronPDF converts each page of a multi-page PDF into a standalone image, maintaining the order and allowing for individual processing or storage.
What Java prerequisites are needed for using IronPDF?
Before using IronPDF, ensure that Java is installed, along with a Java IDE like Eclipse or IntelliJ, and that Maven is set up and integrated with the IDE.
Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.