Extraire des données de table structurées de documents PDF est une nécessité fréquente pour les développeurs C#, crucial pour l'analyse de données, la création de rapports ou l'intégration d'informations dans d'autres systèmes. Cependant, les PDF sont principalement conçus pour une présentation visuelle cohérente, pas pour une extraction de données directe. Cela peut rendre la lecture de tableaux à partir de fichiers PDF par programmation en C# une tâche difficile, en particulier car les tableaux peuvent varier considérablement - des grilles simples basées sur du texte aux mises en page complexes avec des cellules fusionnées, ou même des tableaux intégrés en tant qu'images dans des documents scannés.
Ce guide fournit un tutoriel complet en C# sur la façon d'aborder l'extraction de tableaux PDF à l'aide d'IronPDF. Nous explorerons principalement l'utilisation des puissantes capacités d'extraction de texte d'IronPDF pour accéder puis analyser les données tabulaires à partir de PDF basés sur du texte. Nous discuterons de l'efficacité de cette méthode, fournirons des stratégies pour l'analyse, et offrirons des éclairages sur la gestion des informations extraites. De plus, nous aborderons des stratégies pour traiter des scénarios plus complexes, y compris des PDF numérisés.
Étapes clés pour extraire des données de tableau à partir de PDF en C#
- Installez la bibliothèque C# IronPDF (https://nuget.org/packages/IronPdf/) pour le traitement des PDF.
- (Étape de démonstration optionnelle) Créez un échantillon de PDF avec un tableau à partir d'une chaîne HTML en utilisant
RenderHtmlAsPdf de IronPDF. (Voir section : (Étape de démonstration) Créer un document PDF avec des données de table)
- Chargez n'importe quel document PDF et utilisez la méthode
ExtractAllText pour récupérer son contenu texte brut. (See section: Extract All Text Containing Table Data from the PDF)
- Implémentez une logique C# pour analyser le texte extrait et identifier les lignes et cellules de la table. (See section: Parsing Extracted Text to Reconstruct Table Data in C#)
- Exportez les données de table structurées ou enregistrez-les dans un fichier CSV pour une utilisation ultérieure. (See section: Parsing Extracted Text to Reconstruct Table Data in C#)
- Envisagez des techniques avancées comme l'OCR pour les PDF numérisés (à discuter ultérieurement).
IronPDF - Bibliothèque PDF C#
IronPDF est une solution de bibliothèque C# .NET pour la manipulation de PDF en .NET (https://ironpdf.com/), qui aide les développeurs à lire, créer et éditer facilement des documents PDF dans leurs applications logicielles. Son moteur Chromium robuste rend les documents PDF à partir de HTML avec une grande précision et rapidité. Il permet aux développeurs de convertir de différents formats vers le PDF et vice versa de manière transparente. Il prend en charge les derniers frameworks .NET, notamment .NET 7, .NET 6, 5, 4, .NET Core, et Standard.
De plus, l'API .NET d'IronPDF permet également aux développeurs de manipuler et éditer les PDF, d'ajouter des en-têtes et pieds de page, et surtout d'extraire du texte, des images, et (comme nous le verrons) des données de table à partir des PDF avec aisance.
Quelques fonctionnalités importantes incluent :
Pour extraire des données de table des documents PDF, nous allons mettre en place un projet C# :
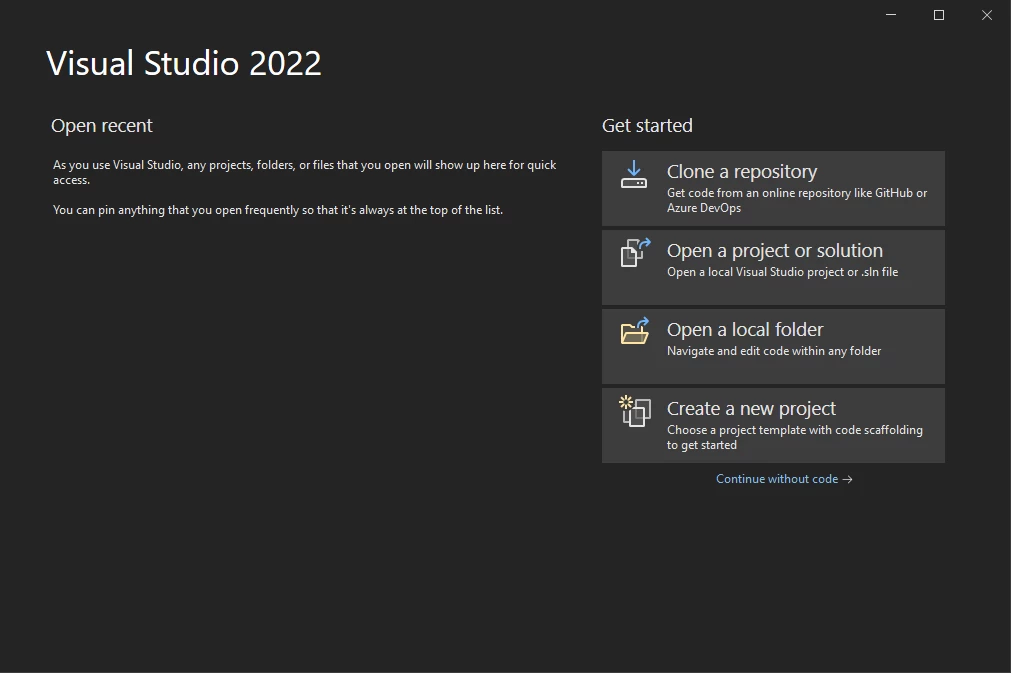
- Visual Studio : Assurez-vous d'avoir installé Visual Studio (par exemple, 2022). Si ce n'est pas le cas, téléchargez-le depuis le site de Visual Studio (https://visualstudio.microsoft.com/downloads/).
- Créer un projet :
-
Sélectionnez "Application Console" (ou votre type de projet C# préféré) et cliquez sur Suivant.
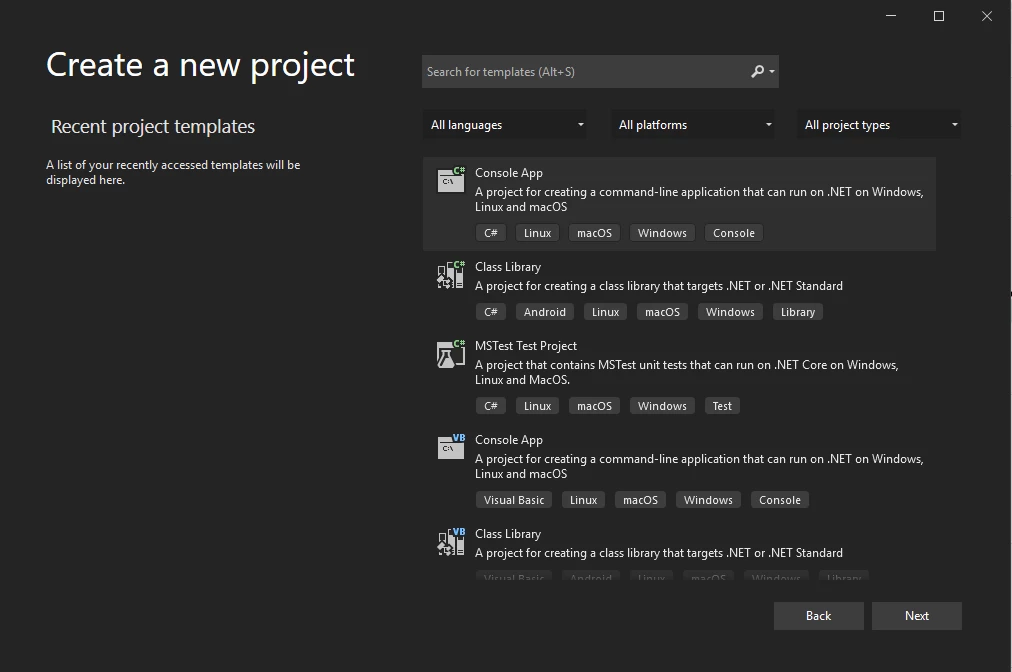 Créer une nouvelle application console dans Visual Studio
-
Nommez votre projet (par exemple, "ReadPDFTableDemo") et cliquez sur Suivant.
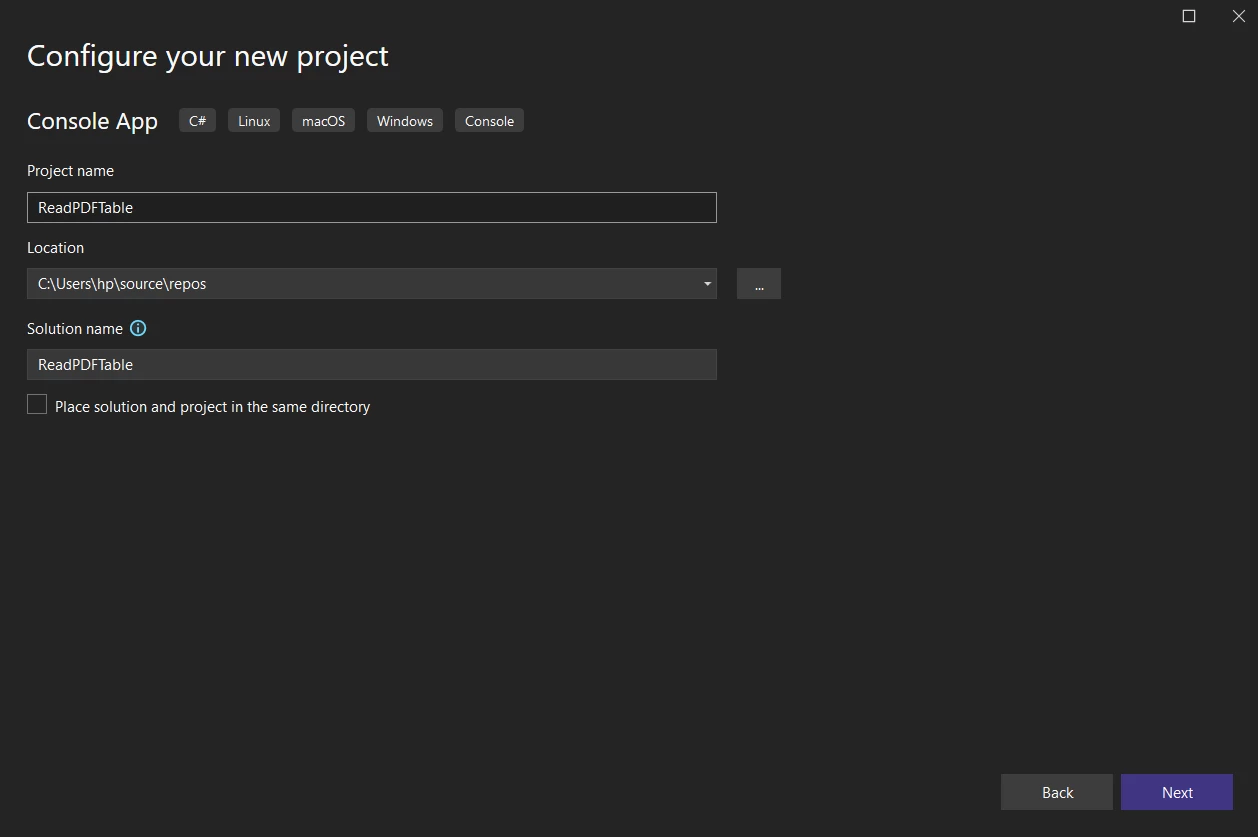 Configurez la nouvelle application créée
-
Choisissez votre framework .NET désiré (par exemple, .NET 6 ou supérieur).
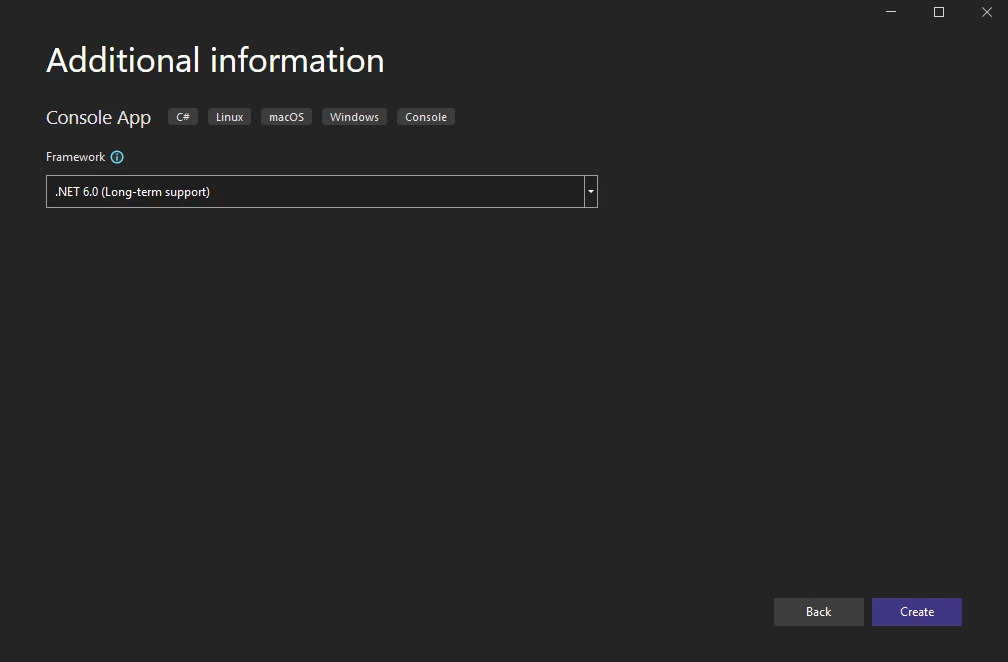 Sélectionnez un framework .NET
-
Cliquez sur Créer. Le projet console sera créé.
- Installez IronPDF:
- Utilisation du gestionnaire de packages NuGet de Visual Studio :
-
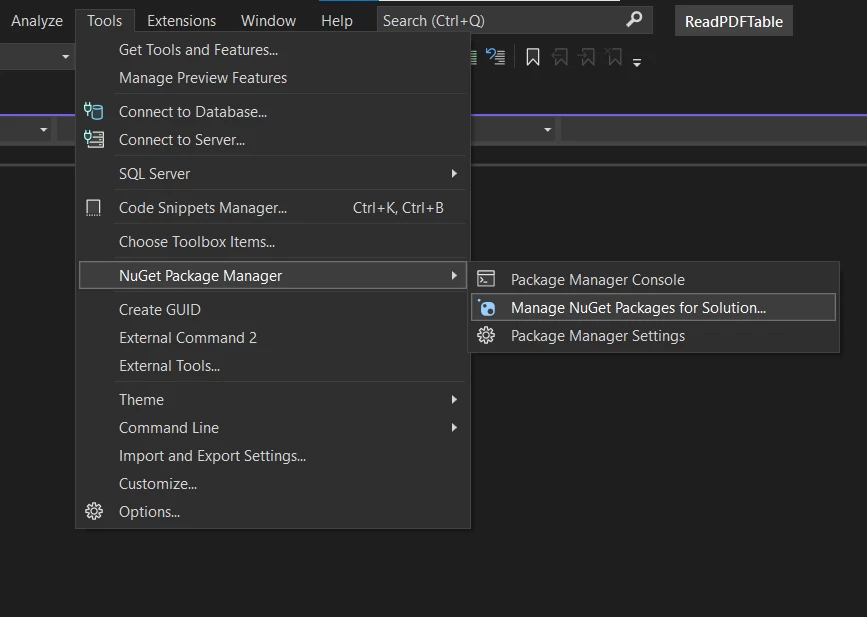
Faites un clic droit sur votre projet dans l'Explorateur de solutions et sélectionnez "Gérer les packages NuGet..."
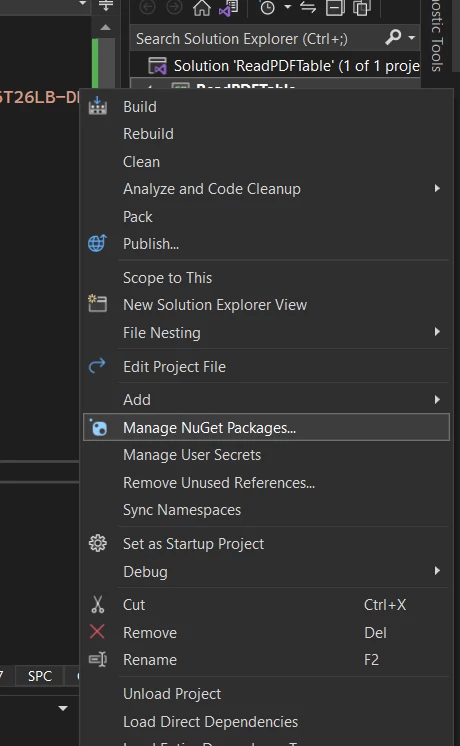 Outils & Gérer les packages NuGet
-
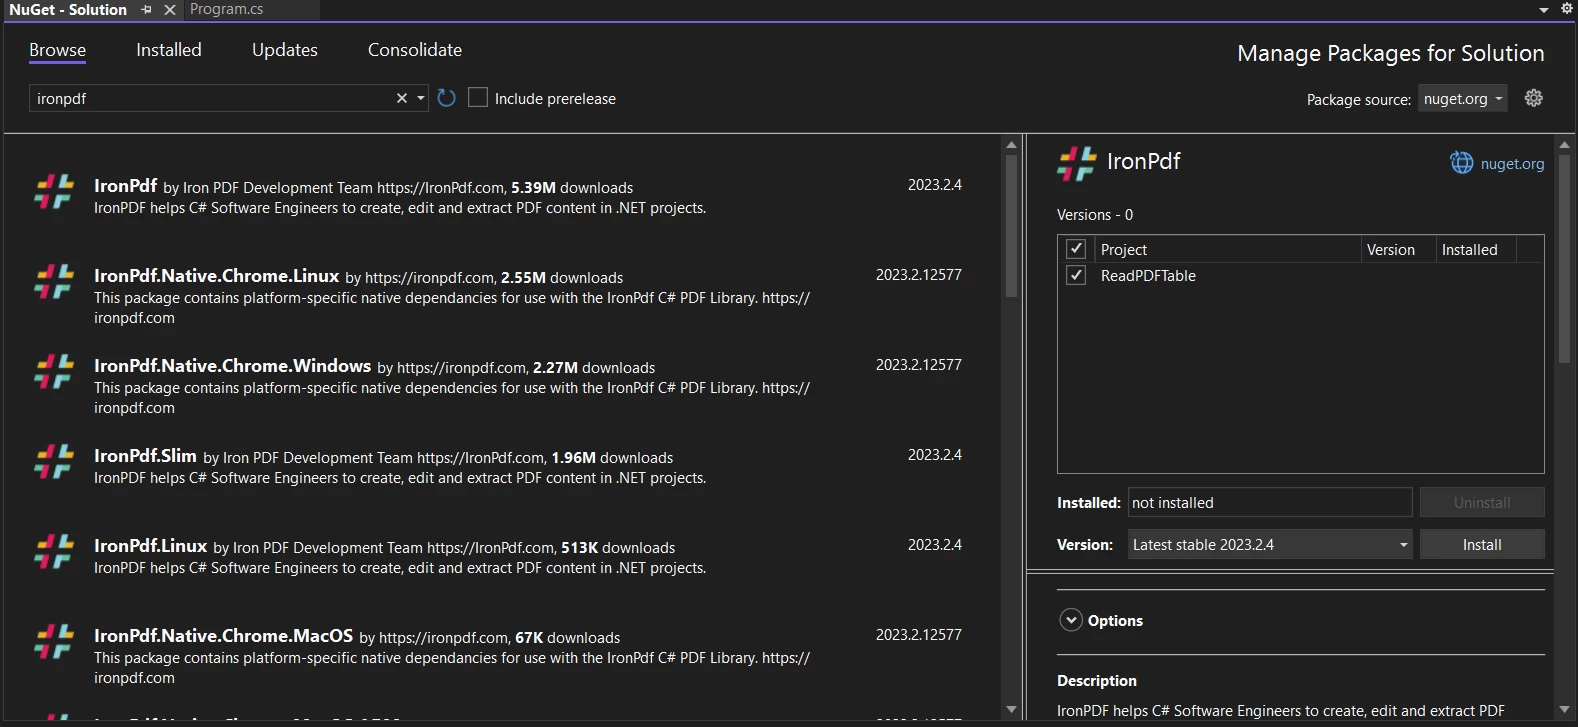
Dans le gestionnaire de packages NuGet, cherchez "IronPDF" et cliquez sur "Install".
 Outils & Gérer les packages NuGet
(Étape de démonstration) Créez un document PDF avec des données de table
Pour ce tutoriel, nous allons d'abord créer un PDF exemple contenant une table simple à partir d'une chaîne HTML. Cela nous donne une structure PDF connue pour démontrer le processus d'extraction. Dans un scénario réel, vous chargeriez vos fichiers PDF préexistants.
Ajoutez l'espace de noms IronPDF et définissez éventuellement votre clé de licence (IronPDF est gratuit pour le développement mais nécessite une licence pour le déploiement commercial sans filigrane) :
using IronPdf;
using System;       // For StringSplitOptions, Console
using System.IO;    // For StreamWriter

// Apply your license key if you have one. Otherwise, IronPDF runs in trial mode.
// License.LicenseKey = "YOUR-TRIAL/PURCHASED-LICENSE-KEY";
using IronPdf;
using System;       // For StringSplitOptions, Console
using System.IO;    // For StreamWriter

// Apply your license key if you have one. Otherwise, IronPDF runs in trial mode.
// License.LicenseKey = "YOUR-TRIAL/PURCHASED-LICENSE-KEY";
Imports IronPdf
Imports System ' For StringSplitOptions, Console
Imports System.IO ' For StreamWriter

' Apply your license key if you have one. Otherwise, IronPDF runs in trial mode.
' License.LicenseKey = "YOUR-TRIAL/PURCHASED-LICENSE-KEY";
Imports IronPdf
Imports System ' For StringSplitOptions, Console
Imports System.IO ' For StreamWriter

' Apply your license key if you have one. Otherwise, IronPDF runs in trial mode.
' License.LicenseKey = "YOUR-TRIAL/PURCHASED-LICENSE-KEY";
Voici la chaîne HTML pour notre table exemple :
string HTML = "<html>" +
        "<style>" +
            "table, th, td {" +
                "border:1px solid black;" +
            "}" +
        "</style>" +
        "<body>" +
            "<h1>A Simple table example</h1>" + // Corrected typo: h1 not h2
            "<table>" +
                "<tr>" +
                    "<th>Company</th>" +
                    "<th>Contact</th>" +
                    "<th>Country</th>" +
               "</tr>" +
                "<tr>" +
                    "<td>Alfreds Futterkiste</td>" +
                    "<td>Maria Anders</td>" +
                    "<td>Germany</td>" +
                "</tr>" +
                "<tr>" +
                    "<td>Centro comercial Moctezuma</td>" +
                    "<td>Francisco Chang</td>" +
                    "<td>Mexico</td>" +
                "</tr>" +
            "</table>" +
            "<p>To understand the example better, we have added borders to the table.</p>" +
        "</body>" +
        "</html>";
string HTML = "<html>" +
        "<style>" +
            "table, th, td {" +
                "border:1px solid black;" +
            "}" +
        "</style>" +
        "<body>" +
            "<h1>A Simple table example</h1>" + // Corrected typo: h1 not h2
            "<table>" +
                "<tr>" +
                    "<th>Company</th>" +
                    "<th>Contact</th>" +
                    "<th>Country</th>" +
               "</tr>" +
                "<tr>" +
                    "<td>Alfreds Futterkiste</td>" +
                    "<td>Maria Anders</td>" +
                    "<td>Germany</td>" +
                "</tr>" +
                "<tr>" +
                    "<td>Centro comercial Moctezuma</td>" +
                    "<td>Francisco Chang</td>" +
                    "<td>Mexico</td>" +
                "</tr>" +
            "</table>" +
            "<p>To understand the example better, we have added borders to the table.</p>" +
        "</body>" +
        "</html>";
HTML
Utilisez maintenant ChromePdfRenderer pour créer un PDF à partir de cet HTML :
var renderer = new ChromePdfRenderer();
PdfDocument pdfDocument = renderer.RenderHtmlAsPdf(HTML);
pdfDocument.SaveAs("table_example.pdf");
Console.WriteLine("Sample PDF 'table_example.pdf' created.");
var renderer = new ChromePdfRenderer();
PdfDocument pdfDocument = renderer.RenderHtmlAsPdf(HTML);
pdfDocument.SaveAs("table_example.pdf");
Console.WriteLine("Sample PDF 'table_example.pdf' created.");
Dim renderer = New ChromePdfRenderer()
Dim pdfDocument As PdfDocument = renderer.RenderHtmlAsPdf(HTML)
pdfDocument.SaveAs("table_example.pdf")
Console.WriteLine("Sample PDF 'table_example.pdf' created.")
Dim renderer = New ChromePdfRenderer()
Dim pdfDocument As PdfDocument = renderer.RenderHtmlAsPdf(HTML)
pdfDocument.SaveAs("table_example.pdf")
Console.WriteLine("Sample PDF 'table_example.pdf' created.")
La méthode SaveAs enregistre le PDF. Le table_example.pdf généré ressemblera à ceci (image conceptuelle basée sur HTML) :
 Rechercher IronPDF dans l'interface utilisateur du Package Manager NuGet
Pour extraire les données du tableau, nous chargeons d'abord le PDF (soit celui que nous venons de créer, soit un PDF existant) et utilisons la méthode ExtractAllText. Cette méthode récupère tout le contenu textuel des pages PDF.
// Load the PDF (if you just created it, it's already loaded in pdfDocument)
// If loading an existing PDF:
// PdfDocument pdfDocument = PdfDocument.FromFile("table_example.pdf");
// Or use the one created above:
string allText = pdfDocument.ExtractAllText();
// Load the PDF (if you just created it, it's already loaded in pdfDocument)
// If loading an existing PDF:
// PdfDocument pdfDocument = PdfDocument.FromFile("table_example.pdf");
// Or use the one created above:
string allText = pdfDocument.ExtractAllText();
' Load the PDF (if you just created it, it's already loaded in pdfDocument)
' If loading an existing PDF:
' PdfDocument pdfDocument = PdfDocument.FromFile("table_example.pdf");
' Or use the one created above:
Dim allText As String = pdfDocument.ExtractAllText()
' Load the PDF (if you just created it, it's already loaded in pdfDocument)
' If loading an existing PDF:
' PdfDocument pdfDocument = PdfDocument.FromFile("table_example.pdf");
' Or use the one created above:
Dim allText As String = pdfDocument.ExtractAllText()
La variable allText contient maintenant tout le contenu texte du PDF. Vous pouvez l'afficher pour voir l'extraction brute :
Console.WriteLine("\n--- Raw Extracted Text ---");
Console.WriteLine(allText);
Console.WriteLine("\n--- Raw Extracted Text ---");
Console.WriteLine(allText);
Imports Microsoft.VisualBasic
Console.WriteLine(vbLf & "--- Raw Extracted Text ---")
Console.WriteLine(allText)
Imports Microsoft.VisualBasic

Console.WriteLine(vbLf & "--- Raw Extracted Text ---")
Console.WriteLine(allText)
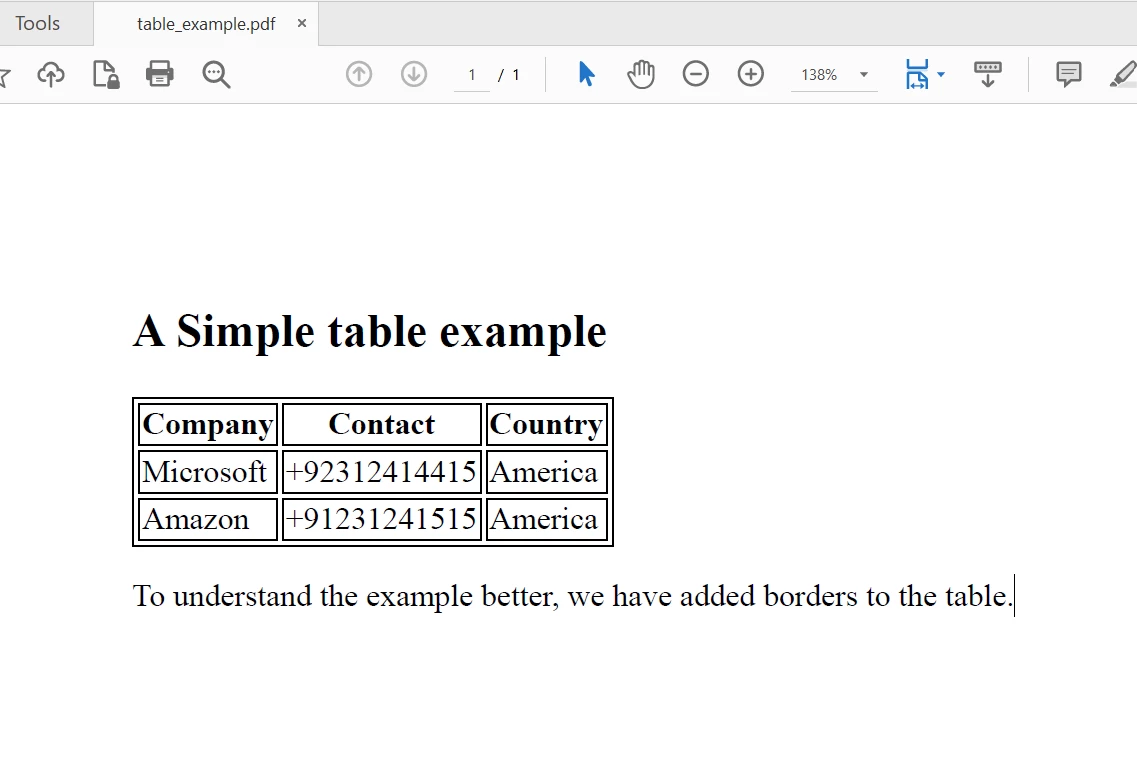 Le fichier PDF à partir duquel extraire du texte
Avec le texte brut extrait, le prochain défi est d'analyser cette chaîne pour identifier et structurer les données tabulaires. Cette étape dépend en grande partie de la cohérence et du format des tables dans vos PDF.
Stratégies de parsing générales :
- Identifiez les délimiteurs de ligne : Les caractères de nouvelle ligne (
\n ou \r\n) sont des séparateurs de ligne courants.
- Identifier les délimiteurs de colonnes : Les cellules à l'intérieur d'une ligne peuvent être séparées par plusieurs espaces, tabulations ou caractères connus spécifiques (comme '|' ou ';'). 3. Filtrer le contenu non tabulaire : La méthode ExtractAllText récupère tout le texte.
- Filtrez le contenu non-table : La méthode
ExtractAllText obtient tout le texte. La méthode C# String.Split est un outil essentiel.
La méthode String.Split de C# est un outil de base pour cela. Ce code divise le texte en lignes.
Console.WriteLine("\n--- Parsed Table Data (Simple Heuristic) ---");
string[] textLines = allText.Split(new[] { '\r', '\n' }, StringSplitOptions.RemoveEmptyEntries);
foreach (string line in textLines)
{
    // Simple filter: skip lines with a period, assuming they are not table data in this example
    // and skip lines that are too short or headers if identifiable
    if (line.Contains(".") || line.Contains("A Simple table example") || line.Length < 5)
    {
        continue;
    }
    else
    {
        // Further split line into cells based on expected delimiters (e.g., multiple spaces)
        // This part requires careful adaptation to your PDF's table structure
        // Example: string[] cells = line.Split(new[] { "  ", "\t" }, StringSplitOptions.None);
        Console.WriteLine(line); // For now, just print the filtered line
    }
}
Console.WriteLine("\n--- Parsed Table Data (Simple Heuristic) ---");
string[] textLines = allText.Split(new[] { '\r', '\n' }, StringSplitOptions.RemoveEmptyEntries);
foreach (string line in textLines)
{
    // Simple filter: skip lines with a period, assuming they are not table data in this example
    // and skip lines that are too short or headers if identifiable
    if (line.Contains(".") || line.Contains("A Simple table example") || line.Length < 5)
    {
        continue;
    }
    else
    {
        // Further split line into cells based on expected delimiters (e.g., multiple spaces)
        // This part requires careful adaptation to your PDF's table structure
        // Example: string[] cells = line.Split(new[] { "  ", "\t" }, StringSplitOptions.None);
        Console.WriteLine(line); // For now, just print the filtered line
    }
}
Imports Microsoft.VisualBasic
Console.WriteLine(vbLf & "--- Parsed Table Data (Simple Heuristic) ---")
Dim textLines() As String = allText.Split( { ControlChars.Cr, ControlChars.Lf }, StringSplitOptions.RemoveEmptyEntries)
For Each line As String In textLines
' Simple filter: skip lines with a period, assuming they are not table data in this example
' and skip lines that are too short or headers if identifiable
If line.Contains(".") OrElse line.Contains("A Simple table example") OrElse line.Length < 5 Then
Continue For
Else
' Further split line into cells based on expected delimiters (e.g., multiple spaces)
' This part requires careful adaptation to your PDF's table structure
' Example: string[] cells = line.Split(new[] { " ", "\t" }, StringSplitOptions.None);
Console.WriteLine(line) ' For now, just print the filtered line
End If
Next line
Imports Microsoft.VisualBasic

Console.WriteLine(vbLf & "--- Parsed Table Data (Simple Heuristic) ---")
Dim textLines() As String = allText.Split( { ControlChars.Cr, ControlChars.Lf }, StringSplitOptions.RemoveEmptyEntries)
For Each line As String In textLines
	' Simple filter: skip lines with a period, assuming they are not table data in this example
	' and skip lines that are too short or headers if identifiable
	If line.Contains(".") OrElse line.Contains("A Simple table example") OrElse line.Length < 5 Then
		Continue For
	Else
		' Further split line into cells based on expected delimiters (e.g., multiple spaces)
		' This part requires careful adaptation to your PDF's table structure
		' Example: string[] cells = line.Split(new[] { "  ", "\t" }, StringSplitOptions.None);
		Console.WriteLine(line) ' For now, just print the filtered line
	End If
Next line
La condition if est un filtre très basique pour le texte non-tabulaire de cet exemple spécifique. La condition if est un filtre très basique pour le texte non-table de cet exemple spécifique. Dans des scénarios réels, vous auriez besoin d'une logique plus robuste pour identifier et analyser avec précision les lignes et les cellules des tableaux.
Sortie du texte filtré simple :
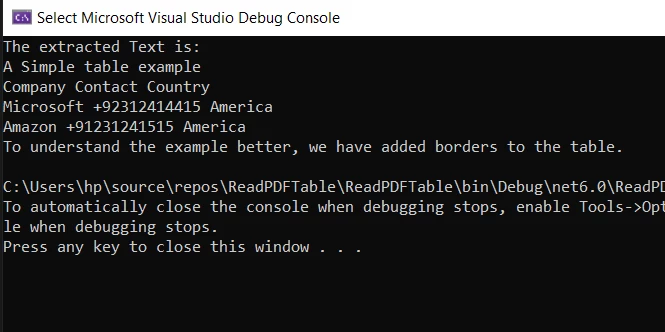 La console affiche les textes extraits
-
Idéal pour : PDFs basés sur du texte avec des structures de tables simples et cohérentes et des délimiteurs textuels clairs.
-
Limites : Cette méthode peut rencontrer des difficultés avec :
-
Limitations : Cette méthode peut avoir des difficultés avec :
- Des tables où les colonnes sont définies par l'espacement visuel plutôt que par des délimiteurs textuels.
- Des tables intégrées sous forme d'images (nécessitant un OCR).
- Des variations dans la génération de PDF entraînant un ordre d'extraction de texte incohérent.
- Variations dans la génération de PDF conduisant à un ordre d'extraction de texte incohérent.
Vous pouvez enregistrer les lignes filtrées (qui représentent idéalement des lignes de table) dans un fichier CSV :
using (StreamWriter file = new StreamWriter("parsed_table_data.csv", false))
{
    file.WriteLine("Company,Contact,Country"); // Write CSV Header
    foreach (string line in textLines)
    {
        if (line.Contains(".") || line.Contains("A Simple table example") || line.Length < 5)
        {
            continue;
        }
        else
        {
            // For a real CSV, you'd split 'line' into cells and join with commas
            // E.g., string[] cells = line.Split(new[] {"  "}, StringSplitOptions.RemoveEmptyEntries);
            // string csvLine = string.Join(",", cells);
            // file.WriteLine(csvLine);
            file.WriteLine(line.Replace("  ", ",").Trim()); // Basic replacement for this example
        }
    }
}
Console.WriteLine("\nFiltered table data saved to parsed_table_data.csv");
using (StreamWriter file = new StreamWriter("parsed_table_data.csv", false))
{
    file.WriteLine("Company,Contact,Country"); // Write CSV Header
    foreach (string line in textLines)
    {
        if (line.Contains(".") || line.Contains("A Simple table example") || line.Length < 5)
        {
            continue;
        }
        else
        {
            // For a real CSV, you'd split 'line' into cells and join with commas
            // E.g., string[] cells = line.Split(new[] {"  "}, StringSplitOptions.RemoveEmptyEntries);
            // string csvLine = string.Join(",", cells);
            // file.WriteLine(csvLine);
            file.WriteLine(line.Replace("  ", ",").Trim()); // Basic replacement for this example
        }
    }
}
Console.WriteLine("\nFiltered table data saved to parsed_table_data.csv");
Imports Microsoft.VisualBasic
Using file As New StreamWriter("parsed_table_data.csv", False)
file.WriteLine("Company,Contact,Country") ' Write CSV Header
For Each line As String In textLines
If line.Contains(".") OrElse line.Contains("A Simple table example") OrElse line.Length < 5 Then
Continue For
Else
' For a real CSV, you'd split 'line' into cells and join with commas
' E.g., string[] cells = line.Split(new[] {" "}, StringSplitOptions.RemoveEmptyEntries);
' string csvLine = string.Join(",", cells);
' file.WriteLine(csvLine);
file.WriteLine(line.Replace(" ", ",").Trim()) ' Basic replacement for this example
End If
Next line
End Using
Console.WriteLine(vbLf & "Filtered table data saved to parsed_table_data.csv")
Imports Microsoft.VisualBasic

Using file As New StreamWriter("parsed_table_data.csv", False)
	file.WriteLine("Company,Contact,Country") ' Write CSV Header
	For Each line As String In textLines
		If line.Contains(".") OrElse line.Contains("A Simple table example") OrElse line.Length < 5 Then
			Continue For
		Else
			' For a real CSV, you'd split 'line' into cells and join with commas
			' E.g., string[] cells = line.Split(new[] {"  "}, StringSplitOptions.RemoveEmptyEntries);
			' string csvLine = string.Join(",", cells);
			' file.WriteLine(csvLine);
			file.WriteLine(line.Replace("  ", ",").Trim()) ' Basic replacement for this example
		End If
	Next line
End Using
Console.WriteLine(vbLf & "Filtered table data saved to parsed_table_data.csv")
IronPDF offre des fonctionnalités qui peuvent aider : IronPDF propose des fonctionnalités qui peuvent aider :
- Utilisation des capacités d'IronOCR pour les tableaux scannés : Si des tableaux se trouvent dans les images (par exemple, des PDF scannés),
ExtractAllText() seul ne les capturera pas. Pour un guide détaillé, visitez la documentation IronOCR (https://ironsoftware.com/csharp/ocr/).
// Conceptual OCR usage (refer to IronOCR's documentation for detailed implementation)
// Install Package IronOcr
using IronOcr;
using (var ocrInput = new OcrInput("scanned_pdf_with_table.pdf"))
{
     ocrInput.TargetDPI = 300; // Good DPI for OCR accuracy
     var ocrResult = new IronOcr().Read(ocrInput);
     string ocrExtractedText = ocrResult.Text;
     // Now, apply parsing logic to 'ocrExtractedText'
     Console.WriteLine("\n--- OCR Extracted Text for Table Parsing ---");
     Console.WriteLine(ocrExtractedText);
}
// Conceptual OCR usage (refer to IronOCR's documentation for detailed implementation)
// Install Package IronOcr
using IronOcr;
using (var ocrInput = new OcrInput("scanned_pdf_with_table.pdf"))
{
     ocrInput.TargetDPI = 300; // Good DPI for OCR accuracy
     var ocrResult = new IronOcr().Read(ocrInput);
     string ocrExtractedText = ocrResult.Text;
     // Now, apply parsing logic to 'ocrExtractedText'
     Console.WriteLine("\n--- OCR Extracted Text for Table Parsing ---");
     Console.WriteLine(ocrExtractedText);
}
' Conceptual OCR usage (refer to IronOCR's documentation for detailed implementation)
' Install Package IronOcr
Imports Microsoft.VisualBasic
Imports IronOcr
Using ocrInput As New OcrInput("scanned_pdf_with_table.pdf")
ocrInput.TargetDPI = 300 ' Good DPI for OCR accuracy
Dim ocrResult = (New IronOcr()).Read(ocrInput)
Dim ocrExtractedText As String = ocrResult.Text
' Now, apply parsing logic to 'ocrExtractedText'
Console.WriteLine(vbLf & "--- OCR Extracted Text for Table Parsing ---")
Console.WriteLine(ocrExtractedText)
End Using
' Conceptual OCR usage (refer to IronOCR's documentation for detailed implementation)
' Install Package IronOcr
Imports Microsoft.VisualBasic
Imports IronOcr
Using ocrInput As New OcrInput("scanned_pdf_with_table.pdf")
	 ocrInput.TargetDPI = 300 ' Good DPI for OCR accuracy
	 Dim ocrResult = (New IronOcr()).Read(ocrInput)
	 Dim ocrExtractedText As String = ocrResult.Text
	 ' Now, apply parsing logic to 'ocrExtractedText'
	 Console.WriteLine(vbLf & "--- OCR Extracted Text for Table Parsing ---")
	 Console.WriteLine(ocrExtractedText)
End Using
Pour des conseils détaillés, consultez la documentation d'IronOCR (https://ironsoftware.com/csharp/ocr/). Après OCR, vous analyserez la chaîne de texte résultante.
-
Extraction de texte basée sur les coordonnées (Avancé) : Bien qu'IronPDF's ExtractAllText() fournisse le flux de texte, certains scénarios peuvent bénéficier de connaître les coordonnées x,y de chaque extrait de texte. * Conversion de PDF vers un autre format : IronPDF peut convertir les PDF en formats structurés comme HTML.
-
Conversion de PDF en un Autre Format : IronPDF peut convertir des PDFs en formats structurés comme HTML. * Reconnaissance de modèles et expressions régulières : Pour les tables avec des modèles très prévisibles mais des délimiteurs incohérents, des expressions régulières complexes appliquées au texte extrait peuvent parfois isoler les données de table.
PdfDocument pdfToConvert = PdfDocument.FromFile("your_document.pdf");
string htmlOutput = pdfToConvert.ToHtmlString();
// Then use an HTML parsing library (e.g., HtmlAgilityPack) to extract tables from htmlOutput.
PdfDocument pdfToConvert = PdfDocument.FromFile("your_document.pdf");
string htmlOutput = pdfToConvert.ToHtmlString();
// Then use an HTML parsing library (e.g., HtmlAgilityPack) to extract tables from htmlOutput.
Dim pdfToConvert As PdfDocument = PdfDocument.FromFile("your_document.pdf")
Dim htmlOutput As String = pdfToConvert.ToHtmlString()
' Then use an HTML parsing library (e.g., HtmlAgilityPack) to extract tables from htmlOutput.
Dim pdfToConvert As PdfDocument = PdfDocument.FromFile("your_document.pdf")
Dim htmlOutput As String = pdfToConvert.ToHtmlString()
' Then use an HTML parsing library (e.g., HtmlAgilityPack) to extract tables from htmlOutput.
- Reconnaissance de Motifs et Expressions Régulières : Pour les tableaux avec des motifs très prévisibles mais des délimiteurs incohérents, des expressions régulières complexes appliquées au texte extrait peuvent parfois isoler les données du tableau.
Pour de nombreux documents commerciaux courants avec des tables basées sur du texte, l'ExtractAllText d'IronPDF couplé à une logique d'analyse C# intelligente peut être très efficace. Pour les tables basées sur des images, ses capacités d'OCR sont essentielles. Pour de nombreux documents professionnels courants avec des tableaux basés sur du texte, le ExtractAllText d'IronPDF, associé à une logique de parsing intelligente en C#, peut être très efficace. Pour les tableaux basés sur des images, ses capacités OCR sont essentielles.
Résumé
Cet article a démontré comment extraire les données des tableaux d'un document PDF en C# en utilisant IronPDF, en se concentrant principalement sur l'utilisation de la méthode ExtractAllText() et du parsing de chaîne subséquent. IronPDF fournit un ensemble d'outils polyvalents pour les développeurs .NET, simplifiant de nombreuses tâches liées aux PDF, de la création et l'édition à l'extraction complète de données.
IronPDF fournit une boîte à outils polyvalente pour les développeurs .NET, simplifiant de nombreuses tâches liées aux PDF, de la création et de l'édition à l'extraction de données complète. Il propose des méthodes comme ExtractTextFromPage pour une extraction spécifique à la page et prend en charge les conversions de formats comme markdown ou DOCX en PDF.
IronPDF est gratuit pour le développement et propose une licence d'essai gratuite pour tester toutes ses fonctionnalités commerciales. Pour le déploiement en production, diverses options de licence sont disponibles.
Pour plus de détails et des cas d'utilisation avancés, explorez la documentation et les exemples officiels d'IronPDF (https://ironpdf.com/)


 Écran de démarrage de Visual Studio







