using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
USANDO IRONPDF
Cómo comparar eficientemente dos archivos PDF usando C# con IronPDF
**Cree objetos `PdfDocument` a partir de sus matrices de bytes y use `PdfDocument.Merge()` para combinarlos en un solo PDF sin guardarlo en disco.** Este método gestiona automáticamente la compleja estructura del PDF, lo que le permite combinar documentos almacenados en bases de datos o recibidos de API sin necesidad de escribir archivos temporales.
Trabajar con archivos PDF almacenados como matrices de bytes es común en las aplicaciones C# modernas. Ya sea que esté recuperando [documentos PDF](https://ironpdf.com/docs/) de una base de datos, recibiéndolos de servicios web o procesándolos en la memoria, la capacidad de [fusionar múltiples archivos PDF](https://ironpdf.com/how-to/merge-or-split-pdfs/) en uno sin guardarlos en el disco es esencial para los flujos de trabajo empresariales. [IronPDF](https://ironpdf.com) lo hace sencillo con una API intuitiva. En este artículo, aprenderá a fusionar matrices de bytes de PDF en C# y examinará diferentes enfoques, incluido el manejo de `MemoryStream` y patrones de bases de datos del mundo real.
## ¿Qué son las matrices de bytes PDF y por qué combinarlas?
Una matriz de bytes son datos binarios sin procesar que representan un archivo PDF en la memoria. Al trabajar con documentos PDF en C#, a menudo encontrará situaciones en las que los archivos existen como matrices de bytes en lugar de en el disco. Esto es particularmente común cuando se recuperan documentos de bases de datos donde los PDF se almacenan como columnas binarias o cuando se reciben documentos de API REST.
La [funcionalidad MemoryStream](https://ironpdf.com/how-to/pdf-memory-stream/) en .NET , documentada en la [referencia de Microsoft MemoryStream](https://learn.microsoft.com/en-us/dotnet/api/system.io.memorystream) , hace que el manejo de estas matrices de bytes sea eficiente, especialmente cuando se combina con una gestión de memoria adecuada para documentos grandes. En lugar de escribir archivos temporales, puede cargar, procesar y guardar archivos PDF completamente en la memoria, lo que es más rápido, más limpio y evita problemas de permisos del sistema de archivos.
### ¿Por qué no se pueden simplemente concatenar matrices de bytes PDF?
La simple concatenación de dos matrices de bytes PDF no funcionará. A diferencia de los archivos de texto simple, los archivos PDF tienen estructuras internas complejas con encabezados, tablas de referencias cruzadas y convenciones de formato específicas. La [especificación PDF ISO 32000](https://www.adobe.com/devnet/pdf/pdf_reference.html) define reglas complejas sobre la estructura del documento, incluidos metadatos, incrustación de fuentes y capas de cifrado. Unir los bytes directamente produce un archivo corrupto. Se necesita una biblioteca PDF adecuada para analizar esas matrices de bytes y combinarlas correctamente, preservando la integridad estructural.
IronPDF gestiona toda esta complejidad internamente. Puede [fusionar documentos PDF](https://ironpdf.com/examples/merge-pdfs/) con solo unas pocas líneas de código conservando las fuentes, las imágenes y el formato exactamente como aparecieron en los archivos de origen.
### ¿Cuándo debería utilizar la fusión de matrices de bytes?
Este enfoque funciona bien cuando:
- Los documentos se almacenan en una base de datos SQL Server o PostgreSQL como columnas binarias
- Su aplicación recibe datos PDF de una API externa o un microservicio
- Está procesando cargas de archivos en ASP.NET sin guardarlos en el disco
- Se ejecuta en un entorno de nube como Azure Functions o AWS Lambda, donde el almacenamiento de archivos temporales está restringido.
Al trabajar con Azure Blob Storage o servicios en la nube similares, la manipulación de matrices de bytes se vuelve esencial porque se descargan los bytes sin procesar, se los procesa y se carga el resultado, todo sin tocar el sistema de archivos.
## ¿Cómo agregar la biblioteca PDF a su proyecto?
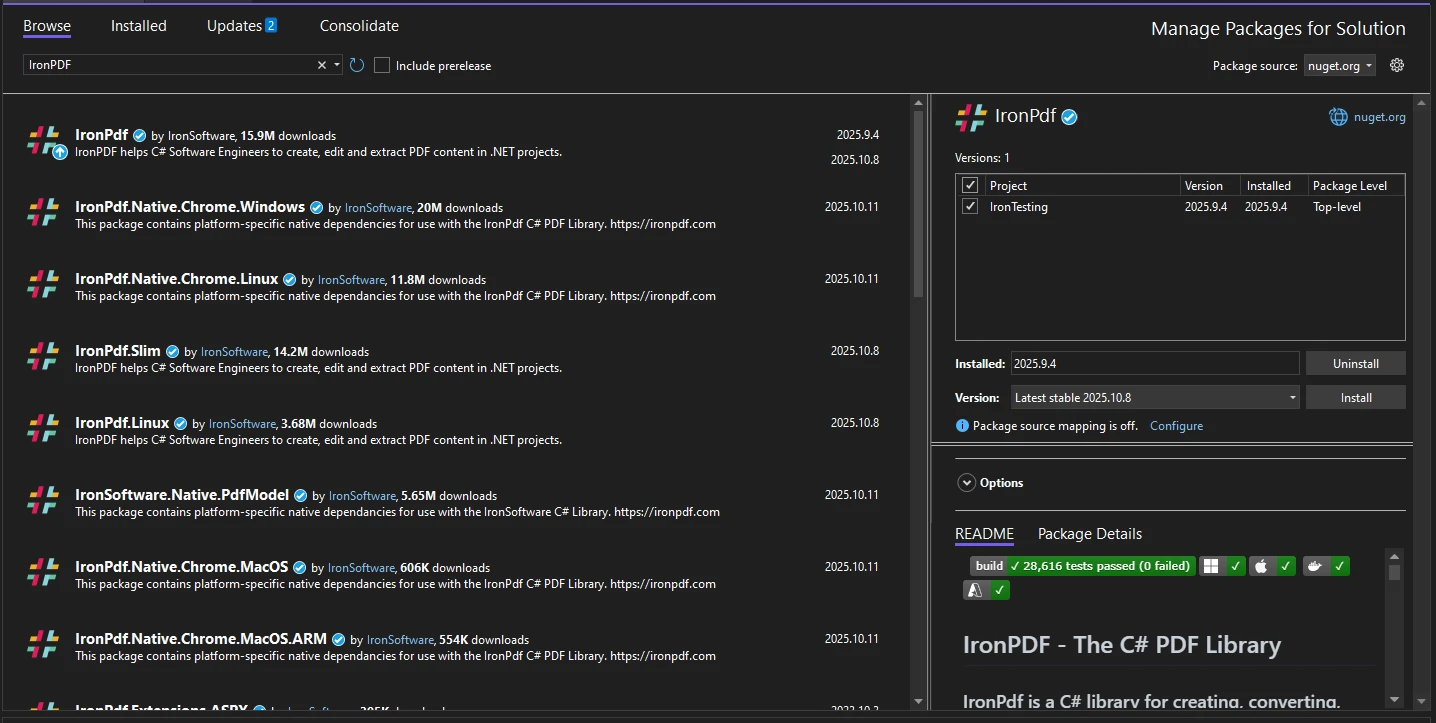
Para comenzar, es necesario agregar el paquete NuGet IronPDF a su proyecto. El paquete está disponible en [NuGet](https://www.nuget.org/packages/IronPdf) . Puede instalarlo utilizando la Consola del Administrador de paquetes o la CLI de .NET :
```bash
:ProductInstall
```
```bash
:InstallCmd dotnet add package IronPdf
```
Para conocer las opciones de instalación detalladas, incluida [la implementación de Docker](https://ironpdf.com/get-started/ironpdf-docker/) o [la configuración de Linux](https://ironpdf.com/get-started/linux/) , consulte la [guía de instalación avanzada](https://ironpdf.com/get-started/advanced-installation-nuget/) . Si está implementando en un entorno mínimo, [IronPDF Slim](https://ironpdf.com/troubleshooting/ironpdf-slim/) reduce significativamente el espacio de implementación.
Una vez instalado, agregue los siguientes espacios de nombres en la parte superior de su archivo C#:
```csharp
using IronPdf;
using System.IO;
using System.Collections.Generic;
```
IronPDF es compatible con las plataformas [Windows, macOS y Linux](https://ironpdf.com/get-started/installation-overview/) . Se integra con [ASP.NET Core](https://learn.microsoft.com/en-us/aspnet/core/introduction-to-aspnet-core) , Blazor, aplicaciones de consola y entornos de nube sin ninguna configuración adicional.
!!!--LIBRARY_GET_STARTED_WITH_PRODUCT_TRIAL_BLOCK--!!!
## ¿Cómo fusionar dos matrices de bytes PDF en C#?
A continuación se muestra un ejemplo completo que demuestra cómo fusionar dos matrices de bytes PDF en un solo documento PDF:
```csharp
// Simulate two PDF byte arrays (in practice, these come from a database or API)
byte[] pdfBytes1 = File.ReadAllBytes("document1.pdf");
byte[] pdfBytes2 = File.ReadAllBytes("document2.pdf");

// Create PdfDocument objects from byte arrays
var pdf1 = new PdfDocument(pdfBytes1);
var pdf2 = new PdfDocument(pdfBytes2);

// Merge the two PDF documents
PdfDocument combinedPdf = PdfDocument.Merge(pdf1, pdf2);

// Convert the combined PDF back to a byte array
byte[] mergedPdfBytes = combinedPdf.BinaryData;

// Optionally save the merged PDF to disk
File.WriteAllBytes("merged.pdf", mergedPdfBytes);
```
La clase `PdfDocument` acepta matrices de bytes sin procesar directamente en su constructor. Una vez que tenga dos instancias `PdfDocument`, `PdfDocument.Merge()` las combina en un solo documento. Luego, la propiedad `BinaryData` le brinda el resultado como una matriz de bytes, lista para almacenarse nuevamente en una base de datos o transmitirse a través de una API.
La [API de PdfDocument](https://ironpdf.com/object-reference/api/) proporciona una amplia funcionalidad más allá de la simple fusión, incluida [la manipulación de páginas](https://ironpdf.com/how-to/add-copy-delete-pages-pdf/) , [la extracción de texto](https://ironpdf.com/how-to/extract-text-and-images/) y [el manejo de formularios](https://ironpdf.com/how-to/edit-forms/) . Una vez que tenga un documento fusionado, puede aplicar cualquiera de estas operaciones antes de extraer la matriz de bytes final.
### ¿Cómo se ve la salida fusionada?
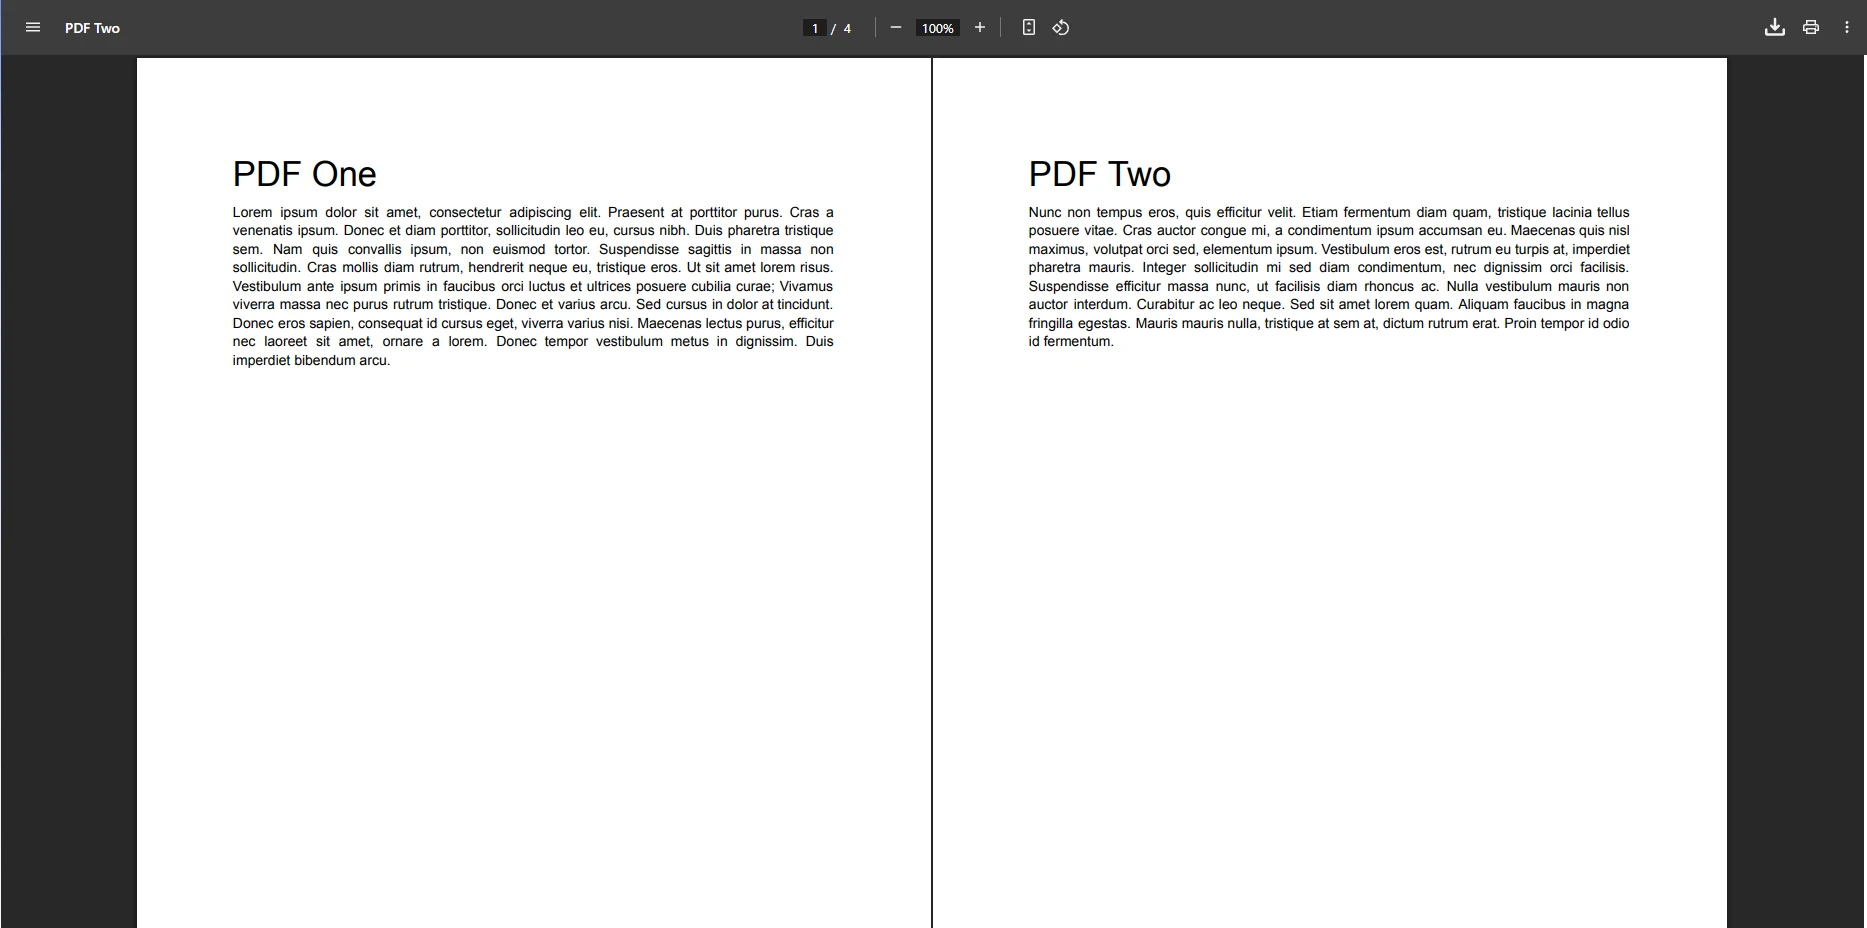
El resultado es un único PDF que contiene todas las páginas de ambos documentos de origen en el orden en que se pasaron a `Merge()`. Se conservan la numeración de páginas, las fuentes, las imágenes y el contenido incrustado. El documento fusionado se comporta de forma idéntica a cualquier otro PDF: puedes paginarlo, anotarlo, firmarlo o comprimirlo utilizando los mismos métodos de IronPDF que aplicarías a cualquier documento.
### ¿Cómo funciona el proceso de fusión internamente?
Cuando pasa una matriz de bytes al constructor `PdfDocument`, IronPDF analiza los datos binarios y crea una representación en memoria de la estructura PDF. Luego, el método `PdfDocument.Merge()` combina varios documentos agregando páginas de cada fuente en secuencia, reconstruyendo la tabla de referencias cruzadas y resolviendo cualquier conflicto de nombres de fuentes o recursos entre los documentos.
Por eso no se pueden concatenar matrices de bytes: la tabla de referencias cruzadas del primer PDF apunta a desplazamientos dentro de ese archivo. Tras la concatenación, esos desplazamientos no son válidos porque el segundo archivo los ha desplazado. IronPDF reconstruye toda la estructura correctamente, dando como resultado un PDF válido y bien formado.
## ¿Cómo fusionar más de dos archivos PDF a la vez?
IronPDF proporciona una sobrecarga `List` para fusionar cualquier cantidad de documentos en una sola operación. Esto es más eficiente que encadenar múltiples fusiones de dos documentos:
```csharp
// Load four PDFs as byte arrays
List<byte[]> pdfByteArrays = new List<byte[]>
{
File.ReadAllBytes("example1.pdf"),
File.ReadAllBytes("example2.pdf"),
File.ReadAllBytes("example3.pdf"),
File.ReadAllBytes("example4.pdf")
};
// Convert each byte array to a PdfDocument
List<PdfDocument> pdfsToMerge = new List<PdfDocument>();
for (int i = 0; i < pdfByteArrays.Count; i++)
{
pdfsToMerge.Add(new PdfDocument(pdfByteArrays[i]));
}
// Merge all documents in one call
PdfDocument combinedPdf = PdfDocument.Merge(pdfsToMerge);
byte[] finalPdfBytes = combinedPdf.BinaryData;
// Apply compression if the result is large
if (finalPdfBytes.Length > 1024 * 1024 * 10) // 10 MB
{
combinedPdf.CompressImages(90);
finalPdfBytes = combinedPdf.BinaryData;
}
```
Este enfoque se adapta a cualquier número de documentos. Cada PDF se carga en un objeto `PdfDocument`, se agrega a una lista y luego se fusiona en una sola llamada. Para archivos de salida grandes, [la compresión PDF](https://ironpdf.com/how-to/pdf-compression/) reduce el tamaño final sin perder calidad significativa.
### ¿Cuándo debería utilizar MemoryStream para fusionar PDF?
El enfoque `MemoryStream` le brinda más control al integrarse con otras bibliotecas .NET que trabajan con transmisiones en lugar de matrices de bytes. También es útil cuando ya tienes una transmisión disponible (por ejemplo, desde una respuesta HTTP o un SDK de almacenamiento de blobs):
```csharp
using (var stream1 = new MemoryStream(pdfBytes1))
using (var stream2 = new MemoryStream(pdfBytes2))
{
var pdf1 = new PdfDocument(stream1);
var pdf2 = new PdfDocument(stream2);
var merged = PdfDocument.Merge(pdf1, pdf2);
// Add metadata to the merged document
merged.MetaData.Author = "Your Application";
merged.MetaData.Title = "Merged Document";
merged.MetaData.CreationDate = DateTime.Now;
byte[] result = merged.BinaryData;
}
```
Puede enriquecer el documento fusionado [configurando metadatos](https://ironpdf.com/how-to/metadata/) , [agregando marcas de agua](https://ironpdf.com/how-to/custom-watermark/) o [aplicando firmas digitales](https://ironpdf.com/how-to/signing/) antes de extraer los bytes finales. Para escenarios de cumplimiento, considere [la conversión de PDF/A](https://ironpdf.com/how-to/pdfa/) para archivo a largo plazo o [la conformidad con PDF/UA](https://ironpdf.com/how-to/pdfua/) para requisitos de accesibilidad.
El procesamiento basado en secuencias proporciona una mejor gestión de la memoria para archivos PDF más grandes y se integra perfectamente con los SDK de almacenamiento en la nube. Este enfoque es especialmente práctico para [patrones asincrónicos](https://ironpdf.com/examples/async/) en servicios de alto rendimiento.
## ¿Cómo fusionar archivos PDF recuperados de una base de datos?
Un patrón común en el mundo real implica obtener matrices de bytes de PDF de una base de datos SQL y combinarlas a pedido. A continuación se muestra un ejemplo listo para producción con manejo de errores:
```csharp
public string MergePdfDocumentsFromDatabase(List<int> documentIds)
{
List<PdfDocument> documents = new List<PdfDocument>();
try
{
foreach (int id in documentIds)
{
// Fetch PDF byte array from database
byte[] pdfData = GetPdfFromDatabase(id); // Replace with your data access logic
if (pdfData == null || pdfData.Length == 0)
{
Console.WriteLine($"Warning: Document {id} is empty or not found");
continue;
}
documents.Add(new PdfDocument(pdfData));
}
if (documents.Count == 0)
{
return "Error: No valid documents found to merge";
}
// Merge all documents
PdfDocument mergedDocument = PdfDocument.Merge(documents);
// Add page numbers to the footer
mergedDocument.AddHtmlFooters(new HtmlHeaderFooter()
{
HtmlFragment = "<center>Page {page} of {total-pages}</center>",
DrawDividerLine = true
});
// Save back to the database
byte[] resultBytes = mergedDocument.BinaryData;
SaveMergedPdfToDatabase(resultBytes);
return "Document successfully combined and saved.";
}
catch (Exception ex)
{
Console.WriteLine($"Error merging PDFs: {ex.Message}");
return $"Merge failed: {ex.Message}";
}
}
```
Este patrón maneja con elegancia los registros faltantes o nulos omitiéndolos y continuando con los documentos válidos. El resultado fusionado obtiene [números de página agregados a través de encabezados y pies de página HTML](https://ironpdf.com/examples/html-headers-and-footers/) antes de volver a escribirse en la base de datos. Para una navegación más avanzada, puede [agregar marcadores](https://ironpdf.com/how-to/bookmarks/) para ayudar a los lectores a navegar por un documento combinado largo.
### ¿Qué hace que el patrón de base de datos sea efectivo?
El patrón anterior funciona para facturas, informes, contratos o cualquier documento almacenado como columnas binarias. Ventajas clave:
- **Sin archivos temporales** : todo el flujo de trabajo ocurre en la memoria, lo que evita el acceso al sistema de archivos y reduce la superficie de ataque.
- **Omisión elegante** : los registros no válidos o faltantes no cancelan toda la fusión, sino que se registran y se omiten.
- **Enriquecimiento antes de guardar** : la adición de pies de página o metadatos al documento fusionado ocurre antes de que se extraiga la matriz de bytes final, por lo que el resultado está completo y listo para usar.
- **Escritura única en la base de datos** : el resultado fusionado se escribe una sola vez, lo que simplifica las transacciones de la base de datos.
## ¿Cómo manejar errores y casos extremos?
### ¿Cuáles son los escenarios de error más comunes?
Al crear flujos de trabajo de combinación de PDF, conviene tener cuidado con varios modos de error:
1. **Matrices de bytes nulas o vacías** : el problema más común. Siempre verifique `pdfData != null && pdfData.Length > 0` antes de construir un `PdfDocument`.
2. **Datos PDF corruptos o no válidos** : si la matriz de bytes se truncó durante el almacenamiento de la base de datos o la transmisión de API, el constructor lanzará un error. Envuelva en un try-catch y registre el ID del documento.
3. **PDF cifrados sin contraseñas** : intentar fusionar un PDF protegido con contraseña sin proporcionarla genera una excepción. Utilice [el manejo de PDF protegido con contraseña](https://ironpdf.com/how-to/pdf-permissions-passwords/) de IronPDF para proporcionar credenciales.
4. **Presión de memoria con muchos archivos grandes** : cargar docenas de PDF grandes simultáneamente puede agotar la memoria disponible. Procesarlos en lotes y desechar los objetos `PdfDocument` después de fusionarlos.
A continuación se muestra un patrón confiable con validación de entrada:
```csharp
public bool TryMergePdfByteArrays(byte[] pdfBytes1, byte[] pdfBytes2, out byte[] mergedBytes)
{
mergedBytes = null;
try
{
if (pdfBytes1 == null || pdfBytes1.Length == 0)
throw new ArgumentException("First PDF byte array is null or empty");
if (pdfBytes2 == null || pdfBytes2.Length == 0)
throw new ArgumentException("Second PDF byte array is null or empty");
using var pdf1 = new PdfDocument(pdfBytes1);
using var pdf2 = new PdfDocument(pdfBytes2);
if (pdf1.PageCount == 0)
throw new InvalidOperationException("First PDF has no pages");
if (pdf2.PageCount == 0)
throw new InvalidOperationException("Second PDF has no pages");
var mergedPdf = PdfDocument.Merge(pdf1, pdf2);
mergedBytes = mergedPdf.BinaryData;
return true;
}
catch (Exception ex)
{
Console.WriteLine($"PDF merge failed: {ex.Message}");
return false;
}
}
```
Las declaraciones `using` garantizan que los objetos `PdfDocument` se eliminen correctamente, liberando recursos no administrados incluso si ocurre una excepción. El patrón `TryXxx` devuelve un indicador de éxito booleano en lugar de lanzar una excepción, lo que facilita la llamada desde un código de nivel superior que maneja varios documentos.
### ¿Cómo puedes prevenir errores comunes?
Varios hábitos reducen el riesgo de fallos de producción:
- **Validar antes de cargar** : verificar que las matrices de bytes no sean nulas y tengan una longitud mínima plausible (los encabezados de PDF tienen al menos unos cientos de bytes).
- **Utilice `using` para su eliminación** : los documentos IronPDF contienen recursos nativos. Deshágase de ellos siempre, ya sea con declaraciones `using` o llamadas explícitas `Dispose()`.
- **Habilitar [registro personalizado](https://ironpdf.com/how-to/custom-logging/)** : registre el ID del documento, la longitud de la matriz de bytes y el recuento de páginas cada vez que se fusionen documentos de una base de datos. Esto hace que la depuración de problemas de producción sea mucho más sencilla.
- **Manejar archivos PDF cifrados de forma explícita** : comprobar si un documento requiere una contraseña antes de fusionarlo. Intentar leer un documento cifrado sin credenciales genera una excepción en lugar de devolver páginas vacías.
- **Establecer tiempos de espera para documentos complejos** : los archivos PDF muy grandes o complejos pueden tardar tiempo en procesarse. Considere [operaciones asincrónicas](https://ironpdf.com/how-to/async/) y valores de tiempo de espera apropiados para escenarios de gran volumen.
<table class="content__data-table" data-content-table>
<caption>Comparación del enfoque de fusión de PDF</caption>
<thead>
<tr>
<th>Acercarse</th>
<th>Mejor para</th>
<th>Uso de la memoria</th>
<th>Flexibilidad</th>
</tr>
</thead>
<tbody>
<tr>
<td>Matriz de bytes directa (dos archivos)</td>
<td>Fusión simple de dos documentos</td>
<td>Bajo</td>
<td>Básico</td>
</tr>
<tr>
<td>`List<PdfDocument>` overload</td>
<td>Fusión por lotes de muchos archivos</td>
<td>Medio</td>
<td>Alto</td>
</tr>
<tr>
<td>Constructor de MemoryStream</td>
<td>Integraciones basadas en stream</td>
<td>Bajo</td>
<td>Alto</td>
</tr>
<tr>
<td>Patrón de búsqueda de base de datos</td>
<td>Flujos de trabajo de documentos de producción</td>
<td>Medio</td>
<td>Muy alto</td>
</tr>
</tbody>
</table>
## ¿Cómo empezar a combinar archivos PDF en producción?
IronPDF ofrece una [prueba gratuita](https://ironpdf.com/licensing/) con todas las funciones para que pueda probar la fusión de PDF en su aplicación real antes de comprometerse con una licencia. La prueba incluye la API completa (combinar, dividir, convertir, anotar, firmar y más) sin restricciones de funciones durante la evaluación.
Para uso en producción, [las opciones de licencia](https://ironpdf.com/licensing/) varían desde licencias para un solo desarrollador hasta licencias de sitio empresarial que cubren implementaciones ilimitadas. Las organizaciones que ejecutan flujos de trabajo de gran volumen pueden explorar [las licencias OEM](https://ironpdf.com/licensing/) para escenarios redistribuibles.
Más allá de la fusión, IronPDF cubre todo el ciclo de vida del procesamiento de PDF: [conversión de HTML a PDF](https://ironpdf.com/how-to/html-file-to-pdf/) , [edición de PDF](https://ironpdf.com/tutorials/csharp-edit-pdf-complete-tutorial/) , [creación y llenado de formularios](https://ironpdf.com/how-to/create-forms/) , [extracción de texto](https://ironpdf.com/how-to/extract-text-and-images/) , [firmas digitales](https://ironpdf.com/how-to/signing/) y [gestión de seguridad](https://ironpdf.com/tutorials/csharp-pdf-security-complete-tutorial/) . Una vez que el flujo de trabajo de combinación funcione, estas funciones se integrarán sin dependencias adicionales.
Visita la [página de tutoriales de IronPDF](https://ironpdf.com/tutorials/) para explorar tutoriales completos para cada capacidad principal, o consulta la [referencia de API](https://ironpdf.com/object-reference/api/) para obtener documentación detallada sobre cada clase y método.
!!!--LIBRARY_NUGET_INSTALL_BLOCK--!!!
Cree objetos PdfDocument a partir de sus matrices de bytes y use PdfDocument.Merge() para combinarlos en un solo PDF sin guardarlo en disco. Este método gestiona automáticamente la compleja estructura del PDF, lo que le permite combinar documentos almacenados en bases de datos o recibidos de API sin necesidad de escribir archivos temporales.
Trabajar con archivos PDF almacenados como matrices de bytes es común en las aplicaciones C# modernas. Ya sea que esté recuperando documentos PDF de una base de datos, recibiéndolos de servicios web o procesándolos en la memoria, la capacidad de fusionar múltiples archivos PDF en uno sin guardarlos en el disco es esencial para los flujos de trabajo empresariales. IronPDF lo hace sencillo con una API intuitiva. En este artículo, aprenderá a fusionar matrices de bytes de PDF en C# y examinará diferentes enfoques, incluido el manejo de MemoryStream y patrones de bases de datos del mundo real.
¿Qué son las matrices de bytes PDF y por qué combinarlas?
Una matriz de bytes son datos binarios sin procesar que representan un archivo PDF en la memoria. Al trabajar con documentos PDF en C#, a menudo encontrará situaciones en las que los archivos existen como matrices de bytes en lugar de en el disco. Esto es particularmente común cuando se recuperan documentos de bases de datos donde los PDF se almacenan como columnas binarias o cuando se reciben documentos de API REST.
La funcionalidad MemoryStream en .NET , documentada en la referencia de Microsoft MemoryStream , hace que el manejo de estas matrices de bytes sea eficiente, especialmente cuando se combina con una gestión de memoria adecuada para documentos grandes. En lugar de escribir archivos temporales, puede cargar, procesar y guardar archivos PDF completamente en la memoria, lo que es más rápido, más limpio y evita problemas de permisos del sistema de archivos.
¿Por qué no se pueden simplemente concatenar matrices de bytes PDF?
La simple concatenación de dos matrices de bytes PDF no funcionará. A diferencia de los archivos de texto simple, los archivos PDF tienen estructuras internas complejas con encabezados, tablas de referencias cruzadas y convenciones de formato específicas. La especificación PDF ISO 32000 define reglas complejas sobre la estructura del documento, incluidos metadatos, incrustación de fuentes y capas de cifrado. Unir los bytes directamente produce un archivo corrupto. Se necesita una biblioteca PDF adecuada para analizar esas matrices de bytes y combinarlas correctamente, preservando la integridad estructural.
IronPDF gestiona toda esta complejidad internamente. Puede fusionar documentos PDF con solo unas pocas líneas de código conservando las fuentes, las imágenes y el formato exactamente como aparecieron en los archivos de origen.
¿Cuándo debería utilizar la fusión de matrices de bytes?
Este enfoque funciona bien cuando:
Los documentos se almacenan en una base de datos SQL Server o PostgreSQL como columnas binarias
Su aplicación recibe datos PDF de una API externa o un microservicio
Está procesando cargas de archivos en ASP.NET sin guardarlos en el disco
Se ejecuta en un entorno de nube como Azure Functions o AWS Lambda, donde el almacenamiento de archivos temporales está restringido.
Al trabajar con Azure Blob Storage o servicios en la nube similares, la manipulación de matrices de bytes se vuelve esencial porque se descargan los bytes sin procesar, se los procesa y se carga el resultado, todo sin tocar el sistema de archivos.
¿Cómo agregar la biblioteca PDF a su proyecto?
Para comenzar, es necesario agregar el paquete NuGet IronPDF a su proyecto. El paquete está disponible en NuGet . Puede instalarlo utilizando la Consola del Administrador de paquetes o la CLI de .NET :
IronPDF es compatible con las plataformas Windows, macOS y Linux . Se integra con ASP.NET Core , Blazor, aplicaciones de consola y entornos de nube sin ninguna configuración adicional.
Primer Paso:
¿Cómo fusionar dos matrices de bytes PDF en C#?
A continuación se muestra un ejemplo completo que demuestra cómo fusionar dos matrices de bytes PDF en un solo documento PDF:
// Simulate two PDF byte arrays (in practice, these come from a database or API)byte[] pdfBytes1 = File.ReadAllBytes("document1.pdf");byte[] pdfBytes2 = File.ReadAllBytes("document2.pdf");// Create PdfDocument objects from byte arraysvar pdf1 = new PdfDocument(pdfBytes1);var pdf2 = new PdfDocument(pdfBytes2);// Merge the two PDF documentsPdfDocument combinedPdf = PdfDocument.Merge(pdf1, pdf2);// Convert the combined PDF back to a byte arraybyte[] mergedPdfBytes = combinedPdf.BinaryData;// Optionally save the merged PDF to diskFile.WriteAllBytes("merged.pdf", mergedPdfBytes);
// Simulate two PDF byte arrays (in practice, these come from a database or API)
byte[] pdfBytes1 = File.ReadAllBytes("document1.pdf");
byte[] pdfBytes2 = File.ReadAllBytes("document2.pdf");

// Create PdfDocument objects from byte arrays
var pdf1 = new PdfDocument(pdfBytes1);
var pdf2 = new PdfDocument(pdfBytes2);

// Merge the two PDF documents
PdfDocument combinedPdf = PdfDocument.Merge(pdf1, pdf2);

// Convert the combined PDF back to a byte array
byte[] mergedPdfBytes = combinedPdf.BinaryData;

// Optionally save the merged PDF to disk
File.WriteAllBytes("merged.pdf", mergedPdfBytes);
ImportsSystem.IO' Simulate two PDF byte arrays (in practice, these come from a database or API)Dim pdfBytes1 AsByte() = File.ReadAllBytes("document1.pdf")Dim pdfBytes2 AsByte() = File.ReadAllBytes("document2.pdf")' Create PdfDocument objects from byte arraysDim pdf1 As New PdfDocument(pdfBytes1)Dim pdf2 As New PdfDocument(pdfBytes2)' Merge the two PDF documentsDim combinedPdf AsPdfDocument = PdfDocument.Merge(pdf1, pdf2)' Convert the combined PDF back to a byte arrayDim mergedPdfBytes AsByte() = combinedPdf.BinaryData' Optionally save the merged PDF to diskFile.WriteAllBytes("merged.pdf", mergedPdfBytes)
Imports System.IO

' Simulate two PDF byte arrays (in practice, these come from a database or API)
Dim pdfBytes1 As Byte() = File.ReadAllBytes("document1.pdf")
Dim pdfBytes2 As Byte() = File.ReadAllBytes("document2.pdf")

' Create PdfDocument objects from byte arrays
Dim pdf1 As New PdfDocument(pdfBytes1)
Dim pdf2 As New PdfDocument(pdfBytes2)

' Merge the two PDF documents
Dim combinedPdf As PdfDocument = PdfDocument.Merge(pdf1, pdf2)

' Convert the combined PDF back to a byte array
Dim mergedPdfBytes As Byte() = combinedPdf.BinaryData

' Optionally save the merged PDF to disk
File.WriteAllBytes("merged.pdf", mergedPdfBytes)
La clase PdfDocument acepta matrices de bytes sin procesar directamente en su constructor. Una vez que tenga dos instancias PdfDocument, PdfDocument.Merge() las combina en un solo documento. Luego, la propiedad BinaryData le brinda el resultado como una matriz de bytes, lista para almacenarse nuevamente en una base de datos o transmitirse a través de una API.
El resultado es un único PDF que contiene todas las páginas de ambos documentos de origen en el orden en que se pasaron a Merge(). Se conservan la numeración de páginas, las fuentes, las imágenes y el contenido incrustado. El documento fusionado se comporta de forma idéntica a cualquier otro PDF: puedes paginarlo, anotarlo, firmarlo o comprimirlo utilizando los mismos métodos de IronPDF que aplicarías a cualquier documento.
¿Cómo funciona el proceso de fusión internamente?
Cuando pasa una matriz de bytes al constructor PdfDocument, IronPDF analiza los datos binarios y crea una representación en memoria de la estructura PDF. Luego, el método PdfDocument.Merge() combina varios documentos agregando páginas de cada fuente en secuencia, reconstruyendo la tabla de referencias cruzadas y resolviendo cualquier conflicto de nombres de fuentes o recursos entre los documentos.
Por eso no se pueden concatenar matrices de bytes: la tabla de referencias cruzadas del primer PDF apunta a desplazamientos dentro de ese archivo. Tras la concatenación, esos desplazamientos no son válidos porque el segundo archivo los ha desplazado. IronPDF reconstruye toda la estructura correctamente, dando como resultado un PDF válido y bien formado.
¿Cómo fusionar más de dos archivos PDF a la vez?
IronPDF proporciona una sobrecarga List para fusionar cualquier cantidad de documentos en una sola operación. Esto es más eficiente que encadenar múltiples fusiones de dos documentos:
// Load four PDFs as byte arraysList<byte[]> pdfByteArrays = new List<byte[]>{File.ReadAllBytes("example1.pdf"),File.ReadAllBytes("example2.pdf"),File.ReadAllBytes("example3.pdf"),File.ReadAllBytes("example4.pdf")};// Convert each byte array to a PdfDocumentList<PdfDocument> pdfsToMerge = new List<PdfDocument>();for (int i = 0; i < pdfByteArrays.Count; i++){ pdfsToMerge.Add(new PdfDocument(pdfByteArrays[i]));}// Merge all documents in one callPdfDocument combinedPdf = PdfDocument.Merge(pdfsToMerge);byte[] finalPdfBytes = combinedPdf.BinaryData;// Apply compression if the result is largeif (finalPdfBytes.Length > 1024 * 1024 * 10) // 10 MB{ combinedPdf.CompressImages(90); finalPdfBytes = combinedPdf.BinaryData;}
// Load four PDFs as byte arrays
List<byte[]> pdfByteArrays = new List<byte[]>
{
    File.ReadAllBytes("example1.pdf"),
    File.ReadAllBytes("example2.pdf"),
    File.ReadAllBytes("example3.pdf"),
    File.ReadAllBytes("example4.pdf")
};

// Convert each byte array to a PdfDocument
List<PdfDocument> pdfsToMerge = new List<PdfDocument>();
for (int i = 0; i < pdfByteArrays.Count; i++)
{
    pdfsToMerge.Add(new PdfDocument(pdfByteArrays[i]));
}

// Merge all documents in one call
PdfDocument combinedPdf = PdfDocument.Merge(pdfsToMerge);
byte[] finalPdfBytes = combinedPdf.BinaryData;

// Apply compression if the result is large
if (finalPdfBytes.Length > 1024 * 1024 * 10) // 10 MB
{
    combinedPdf.CompressImages(90);
    finalPdfBytes = combinedPdf.BinaryData;
}
ImportsSystem.IO' Load four PDFs as byte arraysDim pdfByteArrays As New List(OfByte()) From {File.ReadAllBytes("example1.pdf"),File.ReadAllBytes("example2.pdf"),File.ReadAllBytes("example3.pdf"),File.ReadAllBytes("example4.pdf")}' Convert each byte array to a PdfDocumentDim pdfsToMerge As New List(OfPdfDocument)()For i AsInteger = 0 To pdfByteArrays.Count - 1 pdfsToMerge.Add(New PdfDocument(pdfByteArrays(i)))Next' Merge all documents in one callDim combinedPdf AsPdfDocument = PdfDocument.Merge(pdfsToMerge)Dim finalPdfBytes AsByte() = combinedPdf.BinaryData' Apply compression if the result is largeIf finalPdfBytes.Length > 1024 * 1024 * 10 Then ' 10 MB combinedPdf.CompressImages(90) finalPdfBytes = combinedPdf.BinaryDataEnd If
Imports System.IO

' Load four PDFs as byte arrays
Dim pdfByteArrays As New List(Of Byte()) From {
    File.ReadAllBytes("example1.pdf"),
    File.ReadAllBytes("example2.pdf"),
    File.ReadAllBytes("example3.pdf"),
    File.ReadAllBytes("example4.pdf")
}

' Convert each byte array to a PdfDocument
Dim pdfsToMerge As New List(Of PdfDocument)()
For i As Integer = 0 To pdfByteArrays.Count - 1
    pdfsToMerge.Add(New PdfDocument(pdfByteArrays(i)))
Next

' Merge all documents in one call
Dim combinedPdf As PdfDocument = PdfDocument.Merge(pdfsToMerge)
Dim finalPdfBytes As Byte() = combinedPdf.BinaryData

' Apply compression if the result is large
If finalPdfBytes.Length > 1024 * 1024 * 10 Then ' 10 MB
    combinedPdf.CompressImages(90)
    finalPdfBytes = combinedPdf.BinaryData
End If
Este enfoque se adapta a cualquier número de documentos. Cada PDF se carga en un objeto PdfDocument, se agrega a una lista y luego se fusiona en una sola llamada. Para archivos de salida grandes, la compresión PDF reduce el tamaño final sin perder calidad significativa.
¿Cuándo debería utilizar MemoryStream para fusionar PDF?
El enfoque MemoryStream le brinda más control al integrarse con otras bibliotecas .NET que trabajan con transmisiones en lugar de matrices de bytes. También es útil cuando ya tienes una transmisión disponible (por ejemplo, desde una respuesta HTTP o un SDK de almacenamiento de blobs):
using (var stream1 = new MemoryStream(pdfBytes1))using (var stream2 = new MemoryStream(pdfBytes2)){ var pdf1 = new PdfDocument(stream1); var pdf2 = new PdfDocument(stream2); var merged = PdfDocument.Merge(pdf1, pdf2); // Add metadata to the merged document merged.MetaData.Author = "Your Application"; merged.MetaData.Title = "Merged Document"; merged.MetaData.CreationDate = DateTime.Now; byte[] result = merged.BinaryData;}
using (var stream1 = new MemoryStream(pdfBytes1))
using (var stream2 = new MemoryStream(pdfBytes2))
{
    var pdf1 = new PdfDocument(stream1);
    var pdf2 = new PdfDocument(stream2);

    var merged = PdfDocument.Merge(pdf1, pdf2);

    // Add metadata to the merged document
    merged.MetaData.Author = "Your Application";
    merged.MetaData.Title = "Merged Document";
    merged.MetaData.CreationDate = DateTime.Now;

    byte[] result = merged.BinaryData;
}
ImportsSystem.IOUsing stream1 As New MemoryStream(pdfBytes1)Using stream2 As New MemoryStream(pdfBytes2) Dim pdf1 = New PdfDocument(stream1) Dim pdf2 = New PdfDocument(stream2) Dim merged = PdfDocument.Merge(pdf1, pdf2) ' Add metadata to the merged document merged.MetaData.Author = "Your Application" merged.MetaData.Title = "Merged Document" merged.MetaData.CreationDate = DateTime.Now Dim result AsByte() = merged.BinaryDataEndUsingEndUsing
Imports System.IO

Using stream1 As New MemoryStream(pdfBytes1)
    Using stream2 As New MemoryStream(pdfBytes2)
        Dim pdf1 = New PdfDocument(stream1)
        Dim pdf2 = New PdfDocument(stream2)

        Dim merged = PdfDocument.Merge(pdf1, pdf2)

        ' Add metadata to the merged document
        merged.MetaData.Author = "Your Application"
        merged.MetaData.Title = "Merged Document"
        merged.MetaData.CreationDate = DateTime.Now

        Dim result As Byte() = merged.BinaryData
    End Using
End Using
El procesamiento basado en secuencias proporciona una mejor gestión de la memoria para archivos PDF más grandes y se integra perfectamente con los SDK de almacenamiento en la nube. Este enfoque es especialmente práctico para patrones asincrónicos en servicios de alto rendimiento.
¿Cómo fusionar archivos PDF recuperados de una base de datos?
Un patrón común en el mundo real implica obtener matrices de bytes de PDF de una base de datos SQL y combinarlas a pedido. A continuación se muestra un ejemplo listo para producción con manejo de errores:
public stringMergePdfDocumentsFromDatabase(List<int> documentIds){ List<PdfDocument> documents = new List<PdfDocument>(); try { foreach (int id in documentIds) { // Fetch PDF byte array from database byte[] pdfData = GetPdfFromDatabase(id); // Replace with your data access logic if (pdfData == null || pdfData.Length == 0) {Console.WriteLine($"Warning: Document {id} is empty or not found"); continue; } documents.Add(new PdfDocument(pdfData)); } if (documents.Count == 0) { return "Error: No valid documents found to merge"; } // Merge all documents PdfDocument mergedDocument = PdfDocument.Merge(documents); // Add page numbers to the footer mergedDocument.AddHtmlFooters(new HtmlHeaderFooter() {HtmlFragment = "<center>Page {page} of {total-pages}</center>",DrawDividerLine = true }); // Save back to the database byte[] resultBytes = mergedDocument.BinaryData;SaveMergedPdfToDatabase(resultBytes); return "Document successfully combined and saved."; } catch (Exception ex) {Console.WriteLine($"Error merging PDFs: {ex.Message}"); return $"Merge failed: {ex.Message}"; }}
public string MergePdfDocumentsFromDatabase(List<int> documentIds)
{
    List<PdfDocument> documents = new List<PdfDocument>();

    try
    {
        foreach (int id in documentIds)
        {
            // Fetch PDF byte array from database
            byte[] pdfData = GetPdfFromDatabase(id); // Replace with your data access logic

            if (pdfData == null || pdfData.Length == 0)
            {
                Console.WriteLine($"Warning: Document {id} is empty or not found");
                continue;
            }

            documents.Add(new PdfDocument(pdfData));
        }

        if (documents.Count == 0)
        {
            return "Error: No valid documents found to merge";
        }

        // Merge all documents
        PdfDocument mergedDocument = PdfDocument.Merge(documents);

        // Add page numbers to the footer
        mergedDocument.AddHtmlFooters(new HtmlHeaderFooter()
        {
            HtmlFragment = "<center>Page {page} of {total-pages}</center>",
            DrawDividerLine = true
        });

        // Save back to the database
        byte[] resultBytes = mergedDocument.BinaryData;
        SaveMergedPdfToDatabase(resultBytes);

        return "Document successfully combined and saved.";
    }
    catch (Exception ex)
    {
        Console.WriteLine($"Error merging PDFs: {ex.Message}");
        return $"Merge failed: {ex.Message}";
    }
}
ImportsSystemPublic Function MergePdfDocumentsFromDatabase(documentIds AsList(OfInteger)) AsString Dim documents As New List(OfPdfDocument)()Try For Each id AsIntegerIn documentIds ' Fetch PDF byte array from database Dim pdfData AsByte() = GetPdfFromDatabase(id) ' Replace with your data access logic If pdfData Is NothingOrElse pdfData.Length = 0 ThenConsole.WriteLine($"Warning: Document {id} is empty or not found") Continue For End If documents.Add(New PdfDocument(pdfData)) Next If documents.Count = 0 Then Return "Error: No valid documents found to merge" End If ' Merge all documents Dim mergedDocument AsPdfDocument = PdfDocument.Merge(documents) ' Add page numbers to the footer mergedDocument.AddHtmlFooters(New HtmlHeaderFooter() With { .HtmlFragment = "<center>Page {page} of {total-pages}</center>", .DrawDividerLine = True }) ' Save back to the database Dim resultBytes AsByte() = mergedDocument.BinaryDataSaveMergedPdfToDatabase(resultBytes) Return "Document successfully combined and saved."Catch ex AsExceptionConsole.WriteLine($"Error merging PDFs: {ex.Message}") Return $"Merge failed: {ex.Message}"EndTryEnd Function
Imports System

Public Function MergePdfDocumentsFromDatabase(documentIds As List(Of Integer)) As String
    Dim documents As New List(Of PdfDocument)()

    Try
        For Each id As Integer In documentIds
            ' Fetch PDF byte array from database
            Dim pdfData As Byte() = GetPdfFromDatabase(id) ' Replace with your data access logic

            If pdfData Is Nothing OrElse pdfData.Length = 0 Then
                Console.WriteLine($"Warning: Document {id} is empty or not found")
                Continue For
            End If

            documents.Add(New PdfDocument(pdfData))
        Next

        If documents.Count = 0 Then
            Return "Error: No valid documents found to merge"
        End If

        ' Merge all documents
        Dim mergedDocument As PdfDocument = PdfDocument.Merge(documents)

        ' Add page numbers to the footer
        mergedDocument.AddHtmlFooters(New HtmlHeaderFooter() With {
            .HtmlFragment = "<center>Page {page} of {total-pages}</center>",
            .DrawDividerLine = True
        })

        ' Save back to the database
        Dim resultBytes As Byte() = mergedDocument.BinaryData
        SaveMergedPdfToDatabase(resultBytes)

        Return "Document successfully combined and saved."
    Catch ex As Exception
        Console.WriteLine($"Error merging PDFs: {ex.Message}")
        Return $"Merge failed: {ex.Message}"
    End Try
End Function
Este patrón maneja con elegancia los registros faltantes o nulos omitiéndolos y continuando con los documentos válidos. El resultado fusionado obtiene números de página agregados a través de encabezados y pies de página HTML antes de volver a escribirse en la base de datos. Para una navegación más avanzada, puede agregar marcadores para ayudar a los lectores a navegar por un documento combinado largo.
¿Qué hace que el patrón de base de datos sea efectivo?
El patrón anterior funciona para facturas, informes, contratos o cualquier documento almacenado como columnas binarias. Ventajas clave:
Sin archivos temporales : todo el flujo de trabajo ocurre en la memoria, lo que evita el acceso al sistema de archivos y reduce la superficie de ataque.
Omisión elegante : los registros no válidos o faltantes no cancelan toda la fusión, sino que se registran y se omiten.
Enriquecimiento antes de guardar : la adición de pies de página o metadatos al documento fusionado ocurre antes de que se extraiga la matriz de bytes final, por lo que el resultado está completo y listo para usar.
Escritura única en la base de datos : el resultado fusionado se escribe una sola vez, lo que simplifica las transacciones de la base de datos.
¿Cómo manejar errores y casos extremos?
¿Cuáles son los escenarios de error más comunes?
Al crear flujos de trabajo de combinación de PDF, conviene tener cuidado con varios modos de error:
Matrices de bytes nulas o vacías : el problema más común. Siempre verifique pdfData != null && pdfData.Length > 0 antes de construir un PdfDocument.
Datos PDF corruptos o no válidos : si la matriz de bytes se truncó durante el almacenamiento de la base de datos o la transmisión de API, el constructor lanzará un error. Envuelva en un try-catch y registre el ID del documento.
PDF cifrados sin contraseñas : intentar fusionar un PDF protegido con contraseña sin proporcionarla genera una excepción. Utilice el manejo de PDF protegido con contraseña de IronPDF para proporcionar credenciales.
Presión de memoria con muchos archivos grandes : cargar docenas de PDF grandes simultáneamente puede agotar la memoria disponible. Procesarlos en lotes y desechar los objetos PdfDocument después de fusionarlos.
A continuación se muestra un patrón confiable con validación de entrada:
public boolTryMergePdfByteArrays(byte[] pdfBytes1, byte[] pdfBytes2, out byte[] mergedBytes){ mergedBytes = null; try { if (pdfBytes1 == null || pdfBytes1.Length == 0) throw new ArgumentException("First PDF byte array is null or empty"); if (pdfBytes2 == null || pdfBytes2.Length == 0) throw new ArgumentException("Second PDF byte array is null or empty"); using var pdf1 = new PdfDocument(pdfBytes1); using var pdf2 = new PdfDocument(pdfBytes2); if (pdf1.PageCount == 0) throw new InvalidOperationException("First PDF has no pages"); if (pdf2.PageCount == 0) throw new InvalidOperationException("Second PDF has no pages"); var mergedPdf = PdfDocument.Merge(pdf1, pdf2); mergedBytes = mergedPdf.BinaryData; return true; } catch (Exception ex) {Console.WriteLine($"PDF merge failed: {ex.Message}"); return false; }}
public bool TryMergePdfByteArrays(byte[] pdfBytes1, byte[] pdfBytes2, out byte[] mergedBytes)
{
    mergedBytes = null;

    try
    {
        if (pdfBytes1 == null || pdfBytes1.Length == 0)
            throw new ArgumentException("First PDF byte array is null or empty");

        if (pdfBytes2 == null || pdfBytes2.Length == 0)
            throw new ArgumentException("Second PDF byte array is null or empty");

        using var pdf1 = new PdfDocument(pdfBytes1);
        using var pdf2 = new PdfDocument(pdfBytes2);

        if (pdf1.PageCount == 0)
            throw new InvalidOperationException("First PDF has no pages");

        if (pdf2.PageCount == 0)
            throw new InvalidOperationException("Second PDF has no pages");

        var mergedPdf = PdfDocument.Merge(pdf1, pdf2);
        mergedBytes = mergedPdf.BinaryData;

        return true;
    }
    catch (Exception ex)
    {
        Console.WriteLine($"PDF merge failed: {ex.Message}");
        return false;
    }
}
ImportsSystemPublic Function TryMergePdfByteArrays(pdfBytes1 AsByte(), pdfBytes2 AsByte(), ByRef mergedBytes AsByte()) AsBoolean mergedBytes = NothingTry If pdfBytes1 Is NothingOrElse pdfBytes1.Length = 0 ThenThrow New ArgumentException("First PDF byte array is null or empty") End If If pdfBytes2 Is NothingOrElse pdfBytes2.Length = 0 ThenThrow New ArgumentException("Second PDF byte array is null or empty") End IfUsing pdf1 As New PdfDocument(pdfBytes1)Using pdf2 As New PdfDocument(pdfBytes2) If pdf1.PageCount = 0 ThenThrow New InvalidOperationException("First PDF has no pages") End If If pdf2.PageCount = 0 ThenThrow New InvalidOperationException("Second PDF has no pages") End If Dim mergedPdf = PdfDocument.Merge(pdf1, pdf2) mergedBytes = mergedPdf.BinaryData Return TrueEndUsingEndUsingCatch ex AsExceptionConsole.WriteLine($"PDF merge failed: {ex.Message}") Return FalseEndTryEnd Function
Imports System

Public Function TryMergePdfByteArrays(pdfBytes1 As Byte(), pdfBytes2 As Byte(), ByRef mergedBytes As Byte()) As Boolean
    mergedBytes = Nothing

    Try
        If pdfBytes1 Is Nothing OrElse pdfBytes1.Length = 0 Then
            Throw New ArgumentException("First PDF byte array is null or empty")
        End If

        If pdfBytes2 Is Nothing OrElse pdfBytes2.Length = 0 Then
            Throw New ArgumentException("Second PDF byte array is null or empty")
        End If

        Using pdf1 As New PdfDocument(pdfBytes1)
            Using pdf2 As New PdfDocument(pdfBytes2)
                If pdf1.PageCount = 0 Then
                    Throw New InvalidOperationException("First PDF has no pages")
                End If

                If pdf2.PageCount = 0 Then
                    Throw New InvalidOperationException("Second PDF has no pages")
                End If

                Dim mergedPdf = PdfDocument.Merge(pdf1, pdf2)
                mergedBytes = mergedPdf.BinaryData

                Return True
            End Using
        End Using
    Catch ex As Exception
        Console.WriteLine($"PDF merge failed: {ex.Message}")
        Return False
    End Try
End Function
Las declaraciones using garantizan que los objetos PdfDocument se eliminen correctamente, liberando recursos no administrados incluso si ocurre una excepción. El patrón TryXxx devuelve un indicador de éxito booleano en lugar de lanzar una excepción, lo que facilita la llamada desde un código de nivel superior que maneja varios documentos.
¿Cómo puedes prevenir errores comunes?
Varios hábitos reducen el riesgo de fallos de producción:
Validar antes de cargar : verificar que las matrices de bytes no sean nulas y tengan una longitud mínima plausible (los encabezados de PDF tienen al menos unos cientos de bytes).
Utilice using para su eliminación : los documentos IronPDF contienen recursos nativos. Deshágase de ellos siempre, ya sea con declaraciones using o llamadas explícitas Dispose().
Habilitar registro personalizado : registre el ID del documento, la longitud de la matriz de bytes y el recuento de páginas cada vez que se fusionen documentos de una base de datos. Esto hace que la depuración de problemas de producción sea mucho más sencilla.
Manejar archivos PDF cifrados de forma explícita : comprobar si un documento requiere una contraseña antes de fusionarlo. Intentar leer un documento cifrado sin credenciales genera una excepción en lugar de devolver páginas vacías.
Establecer tiempos de espera para documentos complejos : los archivos PDF muy grandes o complejos pueden tardar tiempo en procesarse. Considere operaciones asincrónicas y valores de tiempo de espera apropiados para escenarios de gran volumen.
Comparación del enfoque de fusión de PDF
Acercarse
Mejor para
Uso de la memoria
Flexibilidad
Matriz de bytes directa (dos archivos)
Fusión simple de dos documentos
Bajo
Básico
List<PdfDocument> overload
Fusión por lotes de muchos archivos
Medio
Alto
Constructor de MemoryStream
Integraciones basadas en stream
Bajo
Alto
Patrón de búsqueda de base de datos
Flujos de trabajo de documentos de producción
Medio
Muy alto
¿Cómo empezar a combinar archivos PDF en producción?
IronPDF ofrece una prueba gratuita con todas las funciones para que pueda probar la fusión de PDF en su aplicación real antes de comprometerse con una licencia. La prueba incluye la API completa (combinar, dividir, convertir, anotar, firmar y más) sin restricciones de funciones durante la evaluación.
Para uso en producción, las opciones de licencia varían desde licencias para un solo desarrollador hasta licencias de sitio empresarial que cubren implementaciones ilimitadas. Las organizaciones que ejecutan flujos de trabajo de gran volumen pueden explorar las licencias OEM para escenarios redistribuibles.
Visita la página de tutoriales de IronPDF para explorar tutoriales completos para cada capacidad principal, o consulta la referencia de API para obtener documentación detallada sobre cada clase y método.
Instalar con NuGet
PM > Install-Package IronPdf
Install-Package IronPdf
Install IronPDF by running the command above in the NuGet Package Manager Console, or search for the package in the NuGet Package Manager.
Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.





 Instalar con NuGet