using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
PDF-WERKZEUGE
Wie man eine Webseite als PDF-Datei auf Mac und Windows speichert
IronPDF bietet umfassende PDF-Ansichtsmöglichkeiten in C# mit seiner intuitiven API und HTML-zu-PDF-Konvertierung mithilfe einer auf Chrome basierenden Rendering-Engine, während PDFSharp einfache Open-Source-PDF-Manipulation bietet, die erheblich komplexeren Code für Textextraktions- und Anzeigeaufgaben erfordert.
In der Softwareentwicklung ist der Umgang mit Daten in verschiedenen Formaten von entscheidender Bedeutung. PDF (Portable Document Format) ist ein weit verbreiteter Standard für den Dokumentenaustausch. In der C#-Programmierung ist das Anzeigen von PDFs unerlässlich für die Erstellung Professional Dokumente und die Verwaltung digitaler Inhalte . Die IronPDF Bibliothek bietet umfassende Werkzeuge zur PDF-Erstellung und -Bearbeitung.
Die Vielseitigkeit von C# macht es beliebt für die Entwicklung von Anwendungen in unterschiedlichsten Bereichen. PDF gewährleistet die Integrität der Dokumente und eine einheitliche Darstellung auf verschiedenen Plattformen. Durch die Integration von PDF-Anzeigefunktionen in Ihre Anwendungen können Sie die Benutzerfreundlichkeit verbessern , Arbeitsabläufe vereinfachen und effiziente Lösungen für die Dokumentenverwaltung bereitstellen. Für Anwendungen, die eine Texterkennung aus gescannten Dokumenten erfordern, können ergänzende OCR-Lösungen Ihre PDF-Verarbeitungskapazitäten verbessern. Die IronPDF Dokumentation bietet vollständige Implementierungsleitfäden. Bei der Arbeit mit vertraulichen Dokumenten ist der korrekte Umgang mit PDFs von entscheidender Bedeutung.
Dieser Artikel untersucht die Anzeige von PDFs mit C#, stellt zwei Bibliotheken vor - PDFSharp und IronPDF - und bietet Anleitungen zur Installation und Nutzung. Sie werden architektonische Unterschiede, Codekomplexität und Wartungsaspekte untersuchen, die Ihre Wahl zwischen diesen PDF-Generierungslösungen beeinflussen. Für Umgebungen, die Dokumentensicherheit erfordern, ist das Verständnis dieser Unterschiede von entscheidender Bedeutung. Die IronPDF Demos veranschaulichen reale Implementierungen, während die API-Referenz detaillierte Spezifikationen enthält.
Was ist PDFSharp und wie handhabt es die PDF-Anzeige?
PDFSharp ist eine Open-Source-Bibliothek für C#, die Entwicklern ein Toolkit für die PDF-Manipulation bietet. Im Gegensatz zur Chrome-basierten Rendering-Engine von IronPDF operiert PDFSharp auf einem Low-Level-Zeichenmodell, das direkte Kontrolle über PDF-Primitiven bietet. Die Bibliothek ermöglicht den Zugriff auf und die Bearbeitung von PDF-Dokumentstrukturen . Im Vergleich zu den umfangreichen Funktionen von IronPDF erfordert PDFSharp erheblich mehr manuellen Code für häufige Aufgaben.
PDFSharp zielt auf ältere .NET Framework-Versionen ab und kann auf Kompatibilitätsprobleme mit neueren .NET-Versionen und Cloud-Umgebungen stoßen. Die Bibliothek erfordert im Gegensatz zur automatischen Plattformerkennung von IronPDF eine manuelle Konfiguration für den plattformübergreifenden Einsatz. Speicherverbrauchsmuster unterscheiden sich, wobei PDFSharp möglicherweise mehr Ressourcen für komplexe Operationen konsumiert. Bei anspruchsvollen Anwendungsszenarien werden diese Unterschiede deutlich. Der Leitfaden zur Leistung von IronPDF bietet Optimierungsstrategien, die mit PDFSharp nicht verfügbar sind.
Warum beeinflusst die Architektur von PDFSharp die Leistung?
Die Low-Level-Architektur von PDFSharp beeinflusst die Leistung durch direkte PDF-Objektmanipulation, die mehr CPU-Zyklen erfordert. Die Bibliothek bietet keine Optimierung für Stapelverarbeitung, parallele Operationen oder asynchrone Arbeitsabläufe. Die Leistungsfähigkeit der Textextraktion verschlechtert sich bei komplexen Dokumenten aufgrund der manuellen Auswertung durch Bediener. Die Chrome-basierte Engine von IronPDF nutzt Browseroptimierungstechniken, was zu einem schnelleren Rendering und einer besseren Speichereffizienz führt. Für asynchrone Operationen bietet die Architektur von IronPDF erhebliche Vorteile.
Warum ist IronPDF die bessere Wahl zum Anzeigen von PDFs?
Installieren Sie IronPDF mithilfe des NuGet -Paket-Managers oder der Paket-Manager-Konsole:
PM > Install-Package IronPdf
Install-Package IronPdf
Dieser Befehl installiert IronPDF und seine Abhängigkeiten. Für Docker-Bereitstellungen oder Linux-Umgebungen werden möglicherweise zusätzliche Pakete benötigt. Die Kurzanleitung enthält Anweisungen zur Einrichtung.
Was macht das API-Design von IronPDF überlegen?
Die IronPDF-API folgt modernen .NET Mustern mit flüssigen Schnittstellen und asynchroner Unterstützung. Die Bibliothek bietet intuitive Methodennamen und vollständige IntelliSense Dokumentation. Fehlermeldungen liefern umsetzbare Lösungen und beschleunigen so die Entwicklung. Die API-Referenz enthält vollständige Methodendetails.
Wann sollte ich die Chrome-Rendering-Engine von IronPDF verwenden?
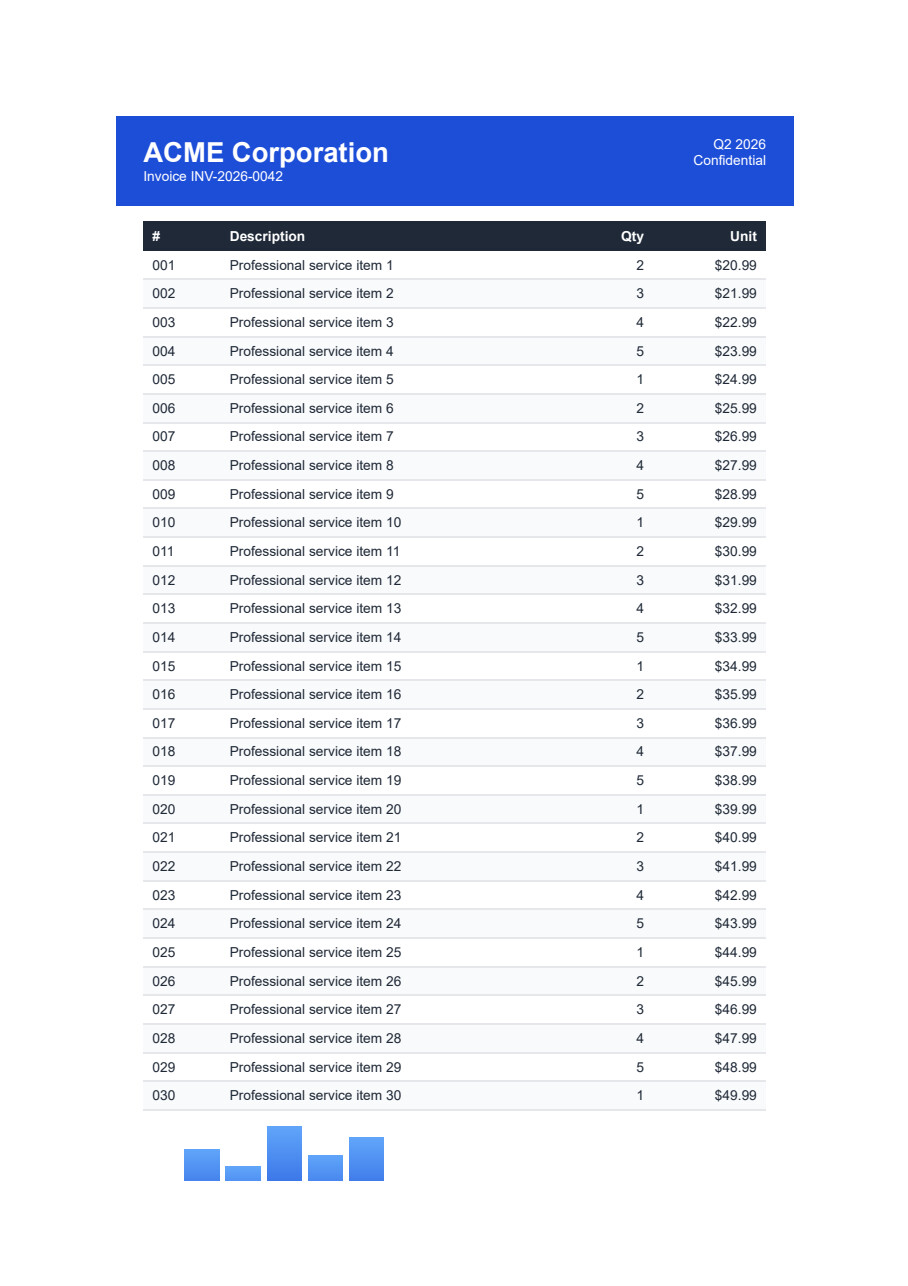
Verwenden Sie die Chrome-Engine von IronPDF zum Konvertieren responsiver HTML-Layouts, zum Rendern von JavaScript Inhalten oder zum Verarbeiten moderner CSS-Designs. Die Engine verarbeitet Webfonts, SVG-Grafiken und Canvas-Elemente automatisch. Es eignet sich ideal zum Generieren von Rechnungen aus HTML-Vorlagen oder zum Erstellen von Berichten mit Visualisierungen. Für die Darstellung von WebGL-Inhalten bietet die Engine GPU-Beschleunigung.
Wie kann ich mit PDFSharp PDF-Inhalte anzeigen?
In diesem Abschnitt wird die Anzeige von PDF-Dateien mit PDFSharp demonstriert. Die Textextraktion in PDFSharp ist aufgrund seiner Low-Level-Natur komplex, anders als die einfachen Methoden von IronPDF:
using System;using System.Text;using PdfSharp.Pdf;using PdfSharp.Pdf.IO;using PdfSharp.Pdf.Content;using PdfSharp.Pdf.Content.Objects;class Program{ static voidMain() { // Specify the path to the PDF file string pdfFilePath = "output.pdf"; // Open the PDF document in import mode // Note: PDFsharp requires specific open modes for different operations PdfDocument document = PdfReader.Open(pdfFilePath, PdfDocumentOpenMode.Import); // Create StringBuilder for extracted text // This approach is less efficient than IronPDF's built-in methods StringBuilder extractedText = new StringBuilder(); // Iterate through each page of the document for (int pageIndex = 0; pageIndex < document.PageCount; pageIndex++) { // Get the current page PdfPage page = document.Pages[pageIndex]; // Extract text using content reader (simplified approach) // Real implementation requires extensive operator parsing CObject content = ContentReader.ReadContent(page); // Parse content objects to extract text // This is where PDFsharp becomes significantly complexExtractText(content, extractedText); // Note: Actual text extraction requires parsing operators // This is a simplified representationConsole.WriteLine($"Page {pageIndex + 1} processed"); }Console.WriteLine("Extracted Text: " + extractedText.ToString());Console.ReadLine(); // Wait for user input before closing the console } static voidExtractText(CObject content, StringBuilder text) { // PDFsharp requires manual parsing of content streams // This is significantly more complex than shown here // Real implementation would need to handle: // - Text operators (Tj, TJ, ', ", etc.) // - Font encoding and character mapping // - Text positioning and transformation matrices // - Unicode mapping and glyph substitution // - Whitespace detection and word boundaries if (content is CArray array) { foreach (var item in array) {ExtractText(item, text); } } else if (content is CString str) { // Simplified text extraction - real implementation needs encoding handling text.Append(str.Value); } // Additional operators would need handling for complete extraction }}
using System;
using System.Text;
using PdfSharp.Pdf;
using PdfSharp.Pdf.IO;
using PdfSharp.Pdf.Content;
using PdfSharp.Pdf.Content.Objects;

class Program
{
    static void Main()
    {
        // Specify the path to the PDF file
        string pdfFilePath = "output.pdf";

        // Open the PDF document in import mode
        // Note: PDFsharp requires specific open modes for different operations
        PdfDocument document = PdfReader.Open(pdfFilePath, PdfDocumentOpenMode.Import);

        // Create StringBuilder for extracted text
        // This approach is less efficient than IronPDF's built-in methods
        StringBuilder extractedText = new StringBuilder();

        // Iterate through each page of the document
        for (int pageIndex = 0; pageIndex < document.PageCount; pageIndex++)
        {
            // Get the current page
            PdfPage page = document.Pages[pageIndex];

            // Extract text using content reader (simplified approach)
            // Real implementation requires extensive operator parsing
            CObject content = ContentReader.ReadContent(page);

            // Parse content objects to extract text
            // This is where PDFsharp becomes significantly complex
            ExtractText(content, extractedText);

            // Note: Actual text extraction requires parsing operators
            // This is a simplified representation
            Console.WriteLine($"Page {pageIndex + 1} processed");
        }

        Console.WriteLine("Extracted Text: " + extractedText.ToString());
        Console.ReadLine(); // Wait for user input before closing the console
    }

    static void ExtractText(CObject content, StringBuilder text)
    {
        // PDFsharp requires manual parsing of content streams
        // This is significantly more complex than shown here
        // Real implementation would need to handle:
        // - Text operators (Tj, TJ, ', ", etc.)
        // - Font encoding and character mapping
        // - Text positioning and transformation matrices
        // - Unicode mapping and glyph substitution
        // - Whitespace detection and word boundaries

        if (content is CArray array)
        {
            foreach (var item in array)
            {
                ExtractText(item, text);
            }
        }
        else if (content is CString str)
        {
            // Simplified text extraction - real implementation needs encoding handling
            text.Append(str.Value);
        }
        // Additional operators would need handling for complete extraction
    }
}
ImportsSystemImportsSystem.TextImportsPdfSharp.PdfImportsPdfSharp.Pdf.IOImportsPdfSharp.Pdf.ContentImportsPdfSharp.Pdf.Content.ObjectsModuleProgram Sub Main() ' Specify the path to the PDF file Dim pdfFilePath AsString = "output.pdf" ' Open the PDF document in import mode ' Note: PDFsharp requires specific open modes for different operations Dim document AsPdfDocument = PdfReader.Open(pdfFilePath, PdfDocumentOpenMode.Import) ' Create StringBuilder for extracted text ' This approach is less efficient than IronPDF's built-in methods Dim extractedText As New StringBuilder() ' Iterate through each page of the document For pageIndex AsInteger = 0 To document.PageCount - 1 ' Get the current page Dim page AsPdfPage = document.Pages(pageIndex) ' Extract text using content reader (simplified approach) ' Real implementation requires extensive operator parsing Dim content AsCObject = ContentReader.ReadContent(page) ' Parse content objects to extract text ' This is where PDFsharp becomes significantly complexExtractText(content, extractedText) ' Note: Actual text extraction requires parsing operators ' This is a simplified representationConsole.WriteLine($"Page {pageIndex + 1} processed") NextConsole.WriteLine("Extracted Text: " & extractedText.ToString())Console.ReadLine() ' Wait for user input before closing the console End Sub Sub ExtractText(content AsCObject, text AsStringBuilder) ' PDFsharp requires manual parsing of content streams ' This is significantly more complex than shown here ' Real implementation would need to handle: ' - Text operators (Tj, TJ, ', ", etc.) ' - Font encoding and character mapping ' - Text positioning and transformation matrices ' - Unicode mapping and glyph substitution ' - Whitespace detection and word boundaries IfTypeOf content IsCArrayThen For Each item InDirectCast(content, CArray)ExtractText(item, text) Next ElseIfTypeOf content IsCStringThen ' Simplified text extraction - real implementation needs encoding handling text.Append(DirectCast(content, CString).Value) End If ' Additional operators would need handling for complete extraction End SubEndModule
Imports System
Imports System.Text
Imports PdfSharp.Pdf
Imports PdfSharp.Pdf.IO
Imports PdfSharp.Pdf.Content
Imports PdfSharp.Pdf.Content.Objects

Module Program
    Sub Main()
        ' Specify the path to the PDF file
        Dim pdfFilePath As String = "output.pdf"

        ' Open the PDF document in import mode
        ' Note: PDFsharp requires specific open modes for different operations
        Dim document As PdfDocument = PdfReader.Open(pdfFilePath, PdfDocumentOpenMode.Import)

        ' Create StringBuilder for extracted text
        ' This approach is less efficient than IronPDF's built-in methods
        Dim extractedText As New StringBuilder()

        ' Iterate through each page of the document
        For pageIndex As Integer = 0 To document.PageCount - 1
            ' Get the current page
            Dim page As PdfPage = document.Pages(pageIndex)

            ' Extract text using content reader (simplified approach)
            ' Real implementation requires extensive operator parsing
            Dim content As CObject = ContentReader.ReadContent(page)

            ' Parse content objects to extract text
            ' This is where PDFsharp becomes significantly complex
            ExtractText(content, extractedText)

            ' Note: Actual text extraction requires parsing operators
            ' This is a simplified representation
            Console.WriteLine($"Page {pageIndex + 1} processed")
        Next

        Console.WriteLine("Extracted Text: " & extractedText.ToString())
        Console.ReadLine() ' Wait for user input before closing the console
    End Sub

    Sub ExtractText(content As CObject, text As StringBuilder)
        ' PDFsharp requires manual parsing of content streams
        ' This is significantly more complex than shown here
        ' Real implementation would need to handle:
        ' - Text operators (Tj, TJ, ', ", etc.)
        ' - Font encoding and character mapping
        ' - Text positioning and transformation matrices
        ' - Unicode mapping and glyph substitution
        ' - Whitespace detection and word boundaries

        If TypeOf content Is CArray Then
            For Each item In DirectCast(content, CArray)
                ExtractText(item, text)
            Next
        ElseIf TypeOf content Is CString Then
            ' Simplified text extraction - real implementation needs encoding handling
            text.Append(DirectCast(content, CString).Value)
        End If
        ' Additional operators would need handling for complete extraction
    End Sub
End Module
Dieser Code verwendet PDFSharp, um Text aus einer PDF-Datei zu lesen und zu extrahieren. Das Programm öffnet "output.pdf" im Importmodus und iteriert durch die Seiten, um Inhalte zu extrahieren. Im Gegensatz zur unkomplizierten API von IronPDF erfordert dieser Ansatz ein Verständnis der internen Funktionsweise von PDF. Die IronPDF Textextraktionsbeispiele demonstrieren einen einfacheren Ansatz.
Warum ist die Textextraktion mit PDFSharp komplexer?
Die Komplexität von PDFSharp rührt von seinem Low-Level-Ansatz her. Im Gegensatz zur High-Level-API von IronPDF erfordert PDFSharp, dass man die Interna von PDFs versteht, einschließlich Operatoren, Kodierung und Inhaltsströme:
// PDFsharp: Complex font handling and text positioningPdfDocument document = new PdfDocument();PdfPage page = document.AddPage();XGraphics gfx = XGraphics.FromPdfPage(page);// Must manually specify fonts and handle font embeddingXFont font = new XFont("Arial", 12, XFontStyle.Regular);// Manual text positioning with exact coordinatesgfx.DrawString("Hello World", font, XBrushes.Black, new XRect(0, 0, page.Width, page.Height),XStringFormats.Center);// Must handle coordinate transformations manuallygfx.TranslateTransform(100, 200);gfx.RotateTransform(45);gfx.DrawString("Rotated Text", font, XBrushes.Red, 0, 0);// IronPDF: Simple HTML approach with CSS stylingvar renderer = new ChromePdfRenderer();var doc = renderer.RenderHtmlAsPdf(@" <h1 style='text-align: center;'>Hello World</h1> <p style='transform: rotate(45deg); margin-left: 100px; margin-top: 200px; color: red;'> Rotated Text </p>");// IronPDF automatically handles fonts, positioning, and transformations
// PDFsharp: Complex font handling and text positioning
PdfDocument document = new PdfDocument();
PdfPage page = document.AddPage();
XGraphics gfx = XGraphics.FromPdfPage(page);

// Must manually specify fonts and handle font embedding
XFont font = new XFont("Arial", 12, XFontStyle.Regular);

// Manual text positioning with exact coordinates
gfx.DrawString("Hello World", font, XBrushes.Black,
    new XRect(0, 0, page.Width, page.Height),
    XStringFormats.Center);

// Must handle coordinate transformations manually
gfx.TranslateTransform(100, 200);
gfx.RotateTransform(45);
gfx.DrawString("Rotated Text", font, XBrushes.Red, 0, 0);

// IronPDF: Simple HTML approach with CSS styling
var renderer = new ChromePdfRenderer();
var doc = renderer.RenderHtmlAsPdf(@"
    <h1 style='text-align: center;'>Hello World</h1>
    <p style='transform: rotate(45deg); margin-left: 100px; margin-top: 200px; color: red;'>
        Rotated Text
    </p>");

// IronPDF automatically handles fonts, positioning, and transformations
' PDFsharp: Complex font handling and text positioningDim document As New PdfDocument()Dim page AsPdfPage = document.AddPage()Dim gfx AsXGraphics = XGraphics.FromPdfPage(page)' Must manually specify fonts and handle font embeddingDim font As New XFont("Arial", 12, XFontStyle.Regular)' Manual text positioning with exact coordinatesgfx.DrawString("Hello World", font, XBrushes.Black, New XRect(0, 0, page.Width, page.Height), XStringFormats.Center)' Must handle coordinate transformations manuallygfx.TranslateTransform(100, 200)gfx.RotateTransform(45)gfx.DrawString("Rotated Text", font, XBrushes.Red, 0, 0)' IronPDF: Simple HTML approach with CSS stylingDim renderer As New ChromePdfRenderer()Dim doc = renderer.RenderHtmlAsPdf(" <h1 style='text-align: center;'>Hello World</h1> <p style='transform: rotate(45deg); margin-left: 100px; margin-top: 200px; color: red;'> Rotated Text </p>")' IronPDF automatically handles fonts, positioning, and transformations
' PDFsharp: Complex font handling and text positioning
Dim document As New PdfDocument()
Dim page As PdfPage = document.AddPage()
Dim gfx As XGraphics = XGraphics.FromPdfPage(page)

' Must manually specify fonts and handle font embedding
Dim font As New XFont("Arial", 12, XFontStyle.Regular)

' Manual text positioning with exact coordinates
gfx.DrawString("Hello World", font, XBrushes.Black, New XRect(0, 0, page.Width, page.Height), XStringFormats.Center)

' Must handle coordinate transformations manually
gfx.TranslateTransform(100, 200)
gfx.RotateTransform(45)
gfx.DrawString("Rotated Text", font, XBrushes.Red, 0, 0)

' IronPDF: Simple HTML approach with CSS styling
Dim renderer As New ChromePdfRenderer()
Dim doc = renderer.RenderHtmlAsPdf("
    <h1 style='text-align: center;'>Hello World</h1>
    <p style='transform: rotate(45deg); margin-left: 100px; margin-top: 200px; color: red;'>
        Rotated Text
    </p>")

' IronPDF automatically handles fonts, positioning, and transformations
Was sind die Einschränkungen von PDFSharp für die Ansicht von PDFs?
Die Einschränkungen von PDFSharp werden offensichtlich, wenn man sich mit modernen PDF-Anforderungen befasst:
Keine HTML-zu-PDF-Konvertierung : HTML kann nicht direkt konvertiert werden.
Extraktion komplexer Texte : Erfordert Kenntnisse der PDF-Operatoren
Eingeschränkte Bildunterstützung : Manuelle Skalierung und Positionierung erforderlich
Keine integrierte OCR: Verfügt nicht über OCR-Funktionen.
Fehlende erweiterte Funktionen : Keine digitalen Signaturen oder PDF/A-Konformität
Wie handhabt PDFSharp Speicher und Leistung?
PDFSharp lädt ganze PDFs in den Speicher, was bei großen Dateien potenziell Probleme verursachen kann. Die Streamverarbeitung wird nicht vollständig unterstützt, was die Skalierbarkeit einschränkt. Im Gegensatz zur verbesserten Rendering-Pipeline von IronPDF fehlen PDFSharp eingebaute Caching-Mechanismen. Der Leitfaden zur Leistungsoptimierung bietet Strategien, die mit PDFSharp nicht verfügbar sind.
Wie vereinfacht IronPDF die PDF-Anzeige in C#?
Zum Anzeigen von PDFs mit IronPDF sind nur wenige Codezeilen erforderlich. Die Bibliothek verwaltet Basis-URLs und Asset-Codierung automatisch:
using IronPdf;using System;using System.Collections.Generic;class Program{ static voidMain() { // Load the PDF document with error handling var pdf = PdfDocument.FromFile("output.pdf"); // Extract all the text content from the PDF string text = pdf.ExtractAllText(); // Print the extracted text to the consoleConsole.WriteLine("Full document text:");Console.WriteLine(text); // Additional extraction options demonstrating IronPDF's versatility // Extract text from specific pages with formatting preserved string pageText = pdf.ExtractTextFromPage(0);Console.WriteLine($"\nPage 1 text: {pageText}"); // Extract all images and save them var images = pdf.ExtractAllImages(); for (int i = 0; i < images.Count; i++) { images[i].SaveAs($"extracted_image_{i}.png"); } // Access complete metadata string author = pdf.MetaData.Author; string title = pdf.MetaData.Title; string subject = pdf.MetaData.Subject; DateTime creationDate = pdf.MetaData.CreationDate;Console.WriteLine($"\nDocument Info:");Console.WriteLine($"Title: {title}");Console.WriteLine($"Author: {author}");Console.WriteLine($"Created: {creationDate}"); // Search for specific text var searchResults = pdf.Search("invoice"); foreach (var result in searchResults) {Console.WriteLine($"Found '{result.Text}' on page {result.PageIndex}"); } // Extract form field data var form = pdf.Form; foreach (var field in form.Fields) {Console.WriteLine($"Field: {field.Name} = {field.Value}"); } }}
using IronPdf;
using System;
using System.Collections.Generic;

class Program
{
    static void Main()
    {
        // Load the PDF document with error handling
        var pdf = PdfDocument.FromFile("output.pdf");

        // Extract all the text content from the PDF
        string text = pdf.ExtractAllText();

        // Print the extracted text to the console
        Console.WriteLine("Full document text:");
        Console.WriteLine(text);

        // Additional extraction options demonstrating IronPDF's versatility

        // Extract text from specific pages with formatting preserved
        string pageText = pdf.ExtractTextFromPage(0);
        Console.WriteLine($"\nPage 1 text: {pageText}");

        // Extract all images and save them
        var images = pdf.ExtractAllImages();
        for (int i = 0; i < images.Count; i++)
        {
            images[i].SaveAs($"extracted_image_{i}.png");
        }

        // Access complete metadata
        string author = pdf.MetaData.Author;
        string title = pdf.MetaData.Title;
        string subject = pdf.MetaData.Subject;
        DateTime creationDate = pdf.MetaData.CreationDate;

        Console.WriteLine($"\nDocument Info:");
        Console.WriteLine($"Title: {title}");
        Console.WriteLine($"Author: {author}");
        Console.WriteLine($"Created: {creationDate}");

        // Search for specific text
        var searchResults = pdf.Search("invoice");
        foreach (var result in searchResults)
        {
            Console.WriteLine($"Found '{result.Text}' on page {result.PageIndex}");
        }

        // Extract form field data
        var form = pdf.Form;
        foreach (var field in form.Fields)
        {
            Console.WriteLine($"Field: {field.Name} = {field.Value}");
        }
    }
}
ImportsIronPdfImportsSystemImportsSystem.Collections.GenericClass ProgramShared Sub Main() ' Load the PDF document with error handling Dim pdf = PdfDocument.FromFile("output.pdf") ' Extract all the text content from the PDF Dim text AsString = pdf.ExtractAllText() ' Print the extracted text to the consoleConsole.WriteLine("Full document text:")Console.WriteLine(text) ' Additional extraction options demonstrating IronPDF's versatility ' Extract text from specific pages with formatting preserved Dim pageText AsString = pdf.ExtractTextFromPage(0)Console.WriteLine(vbCrLf & "Page 1 text: " & pageText) ' Extract all images and save them Dim images = pdf.ExtractAllImages() For i AsInteger = 0 To images.Count - 1 images(i).SaveAs($"extracted_image_{i}.png") Next ' Access complete metadata Dim author AsString = pdf.MetaData.Author Dim title AsString = pdf.MetaData.Title Dim subject AsString = pdf.MetaData.Subject Dim creationDate AsDateTime = pdf.MetaData.CreationDateConsole.WriteLine(vbCrLf & "Document Info:")Console.WriteLine("Title: " & title)Console.WriteLine("Author: " & author)Console.WriteLine("Created: " & creationDate) ' Search for specific text Dim searchResults = pdf.Search("invoice") For Each result In searchResultsConsole.WriteLine($"Found '{result.Text}' on page {result.PageIndex}") Next ' Extract form field data Dim form = pdf.Form For Each field Inform.FieldsConsole.WriteLine($"Field: {field.Name} = {field.Value}") Next End SubEnd Class
Imports IronPdf
Imports System
Imports System.Collections.Generic

Class Program
    Shared Sub Main()
        ' Load the PDF document with error handling
        Dim pdf = PdfDocument.FromFile("output.pdf")

        ' Extract all the text content from the PDF
        Dim text As String = pdf.ExtractAllText()

        ' Print the extracted text to the console
        Console.WriteLine("Full document text:")
        Console.WriteLine(text)

        ' Additional extraction options demonstrating IronPDF's versatility

        ' Extract text from specific pages with formatting preserved
        Dim pageText As String = pdf.ExtractTextFromPage(0)
        Console.WriteLine(vbCrLf & "Page 1 text: " & pageText)

        ' Extract all images and save them
        Dim images = pdf.ExtractAllImages()
        For i As Integer = 0 To images.Count - 1
            images(i).SaveAs($"extracted_image_{i}.png")
        Next

        ' Access complete metadata
        Dim author As String = pdf.MetaData.Author
        Dim title As String = pdf.MetaData.Title
        Dim subject As String = pdf.MetaData.Subject
        Dim creationDate As DateTime = pdf.MetaData.CreationDate

        Console.WriteLine(vbCrLf & "Document Info:")
        Console.WriteLine("Title: " & title)
        Console.WriteLine("Author: " & author)
        Console.WriteLine("Created: " & creationDate)

        ' Search for specific text
        Dim searchResults = pdf.Search("invoice")
        For Each result In searchResults
            Console.WriteLine($"Found '{result.Text}' on page {result.PageIndex}")
        Next

        ' Extract form field data
        Dim form = pdf.Form
        For Each field In form.Fields
            Console.WriteLine($"Field: {field.Name} = {field.Value}")
        Next
    End Sub
End Class
Dieser Code verwendet IronPDF, um Text aus "output.pdf" mit der ExtractAllText Methode zu extrahieren. Die Implementierung erledigt die PDF-Komplexität automatisch und bietet klare Vorteile gegenüber der manuellen Analyse, die bei PDFSharp erforderlich ist. Ihre Anwendung kann dieses Feature sofort verwenden, ohne die Interna von PDFs verstehen zu müssen. Das vollständige Tutorial enthält weitere Beispiele.
Welche erweiterten PDF-Anzeigefunktionen bietet IronPDF ?
IronPDF bietet umfassende Werkzeuge zur PDF-Analyse:
// Advanced PDF analysis with IronPDFvar pdf = PdfDocument.FromFile("complex-document.pdf");// Extract structured content with detailed informationforeach (var page in pdf.Pages){ // Get page dimensions for layout analysis var width = page.Width; var height = page.Height; var rotation = page.Rotation; // Extract form fields with type information var formFields = page.GetFormFields(); foreach (var field in formFields) {Console.WriteLine($"Field: {field.Name}, Type: {field.Type}, Value: {field.Value}"); } // Extract annotations with properties var annotations = page.GetAnnotations(); foreach (var annotation in annotations) {Console.WriteLine($"Annotation: {annotation.Title} - {annotation.Content}"); } // Extract hyperlinks with destinations var links = page.GetLinks(); foreach (var link in links) {Console.WriteLine($"Link: {link.Text} -> {link.Url}"); }}// Advanced search functionality with contextvar searchResults = pdf.Search("invoice", SearchOptions.CaseInsensitive | SearchOptions.WholeWord);foreach (var result in searchResults){Console.WriteLine($"Found on page {result.PageIndex} at position {result.Position}: {result.Text}"); // Get surrounding text for context string context = pdf.ExtractTextFromPage(result.PageIndex) .Substring(Math.Max(0, result.Position - 50), 100);Console.WriteLine($"Context: ...{context}...");}// Extract tables as structured datavar tables = pdf.ExtractTables();foreach (var table in tables){ for (int row = 0; row < table.RowCount; row++) { for (int col = 0; col < table.ColumnCount; col++) {Console.Write($"{table[row, col]}\t"); }Console.WriteLine(); }}
// Advanced PDF analysis with IronPDF
var pdf = PdfDocument.FromFile("complex-document.pdf");

// Extract structured content with detailed information
foreach (var page in pdf.Pages)
{
    // Get page dimensions for layout analysis
    var width = page.Width;
    var height = page.Height;
    var rotation = page.Rotation;

    // Extract form fields with type information
    var formFields = page.GetFormFields();
    foreach (var field in formFields)
    {
        Console.WriteLine($"Field: {field.Name}, Type: {field.Type}, Value: {field.Value}");
    }

    // Extract annotations with properties
    var annotations = page.GetAnnotations();
    foreach (var annotation in annotations)
    {
        Console.WriteLine($"Annotation: {annotation.Title} - {annotation.Content}");
    }

    // Extract hyperlinks with destinations
    var links = page.GetLinks();
    foreach (var link in links)
    {
        Console.WriteLine($"Link: {link.Text} -> {link.Url}");
    }
}

// Advanced search functionality with context
var searchResults = pdf.Search("invoice", SearchOptions.CaseInsensitive | SearchOptions.WholeWord);
foreach (var result in searchResults)
{
    Console.WriteLine($"Found on page {result.PageIndex} at position {result.Position}: {result.Text}");
    // Get surrounding text for context
    string context = pdf.ExtractTextFromPage(result.PageIndex)
        .Substring(Math.Max(0, result.Position - 50), 100);
    Console.WriteLine($"Context: ...{context}...");
}

// Extract tables as structured data
var tables = pdf.ExtractTables();
foreach (var table in tables)
{
    for (int row = 0; row < table.RowCount; row++)
    {
        for (int col = 0; col < table.ColumnCount; col++)
        {
            Console.Write($"{table[row, col]}\t");
        }
        Console.WriteLine();
    }
}
' Advanced PDF analysis with IronPDFDim pdf = PdfDocument.FromFile("complex-document.pdf")' Extract structured content with detailed informationFor Each page In pdf.Pages ' Get page dimensions for layout analysis Dim width = page.Width Dim height = page.Height Dim rotation = page.Rotation ' Extract form fields with type information Dim formFields = page.GetFormFields() For Each field In formFieldsConsole.WriteLine($"Field: {field.Name}, Type: {field.Type}, Value: {field.Value}") Next ' Extract annotations with properties Dim annotations = page.GetAnnotations() For Each annotation In annotationsConsole.WriteLine($"Annotation: {annotation.Title} - {annotation.Content}") Next ' Extract hyperlinks with destinations Dim links = page.GetLinks() For Each link In linksConsole.WriteLine($"Link: {link.Text} -> {link.Url}") NextNext' Advanced search functionality with contextDim searchResults = pdf.Search("invoice", SearchOptions.CaseInsensitiveOrSearchOptions.WholeWord)For Each result In searchResultsConsole.WriteLine($"Found on page {result.PageIndex} at position {result.Position}: {result.Text}") ' Get surrounding text for context Dim context AsString = pdf.ExtractTextFromPage(result.PageIndex).Substring(Math.Max(0, result.Position - 50), 100)Console.WriteLine($"Context: ...{context}...")Next' Extract tables as structured dataDim tables = pdf.ExtractTables()For Each table In tables For row AsInteger = 0 To table.RowCount - 1 For col AsInteger = 0 To table.ColumnCount - 1Console.Write($"{table(row, col)}" & vbTab) NextConsole.WriteLine() NextNext
' Advanced PDF analysis with IronPDF
Dim pdf = PdfDocument.FromFile("complex-document.pdf")

' Extract structured content with detailed information
For Each page In pdf.Pages
    ' Get page dimensions for layout analysis
    Dim width = page.Width
    Dim height = page.Height
    Dim rotation = page.Rotation

    ' Extract form fields with type information
    Dim formFields = page.GetFormFields()
    For Each field In formFields
        Console.WriteLine($"Field: {field.Name}, Type: {field.Type}, Value: {field.Value}")
    Next

    ' Extract annotations with properties
    Dim annotations = page.GetAnnotations()
    For Each annotation In annotations
        Console.WriteLine($"Annotation: {annotation.Title} - {annotation.Content}")
    Next

    ' Extract hyperlinks with destinations
    Dim links = page.GetLinks()
    For Each link In links
        Console.WriteLine($"Link: {link.Text} -> {link.Url}")
    Next
Next

' Advanced search functionality with context
Dim searchResults = pdf.Search("invoice", SearchOptions.CaseInsensitive Or SearchOptions.WholeWord)
For Each result In searchResults
    Console.WriteLine($"Found on page {result.PageIndex} at position {result.Position}: {result.Text}")
    ' Get surrounding text for context
    Dim context As String = pdf.ExtractTextFromPage(result.PageIndex).Substring(Math.Max(0, result.Position - 50), 100)
    Console.WriteLine($"Context: ...{context}...")
Next

' Extract tables as structured data
Dim tables = pdf.ExtractTables()
For Each table In tables
    For row As Integer = 0 To table.RowCount - 1
        For col As Integer = 0 To table.ColumnCount - 1
            Console.Write($"{table(row, col)}" & vbTab)
        Next
        Console.WriteLine()
    Next
Next
Budgetbeschränkungen verhindern die kommerzielle Lizenzierung
Wie bewältigt IronPDF die Verarbeitung großer PDF-Dateien?
IronPDF zeichnet sich durch seine Fähigkeit zur Verarbeitung im Unternehmensmaßstab dank integrierter Optimierung aus. Die Bibliothek unterstützt Parallelverarbeitung , Stapelverarbeitung und speichereffizientes Streaming. Asynchrone Methoden ermöglichen nicht-blockierende Operationen in Webanwendungen. Die Chrome-Engine von IronPDF verarbeitet gleichzeitige Anfragen effizient und eignet sich daher für Microservices und serverlose Funktionen.
Welche PDF-Bibliothek sollte ich für mein C#-Projekt wählen?
Sowohl PDFSharp als auch IronPDF bieten Funktionen für Entwickler, die nach vielseitigen Lösungen suchen. PDFSharp bietet ein leichtgewichtiges Toolkit für grundlegende PDF-Aufgaben. Im Gegensatz dazu ist IronPDF für die vollständige PDF-Bearbeitung konzipiert. Seine fortschrittlichen Funktionen machen es effektiv für anspruchsvolle PDF-Anwendungen.
Betrachten Sie das folgende Codebeispiel, das die saubere Architektur von IronPDF veranschaulicht:
Dieser Ansatz bietet klare Vorteile durch die Nutzung vorhandener HTML/CSS-Kenntnisse und die Wahrung der Trennung der Zuständigkeiten. Die Bibliothek übernimmt die Komplexität für Sie durch ihre vollständige API.
Obwohl beide Bibliotheken ihre Vorzüge haben, zeichnet sich IronPDF durch seinen großen Funktionsumfang und seine Einfachheit aus. Leistungsvergleiche zeigen, dass IronPDF große Dokumente effizient verarbeitet. Für Teams, die Wert auf langfristige Wartbarkeit legen, bietet IronPDF eine vollständige Dokumentation , Professional Support und umfangreiche Codebeispiele .
IronPDF ist für Entwicklungszwecke kostenlos und beinhaltet eine kostenlose Testversion zur Erkundung erweiterter Funktionen. Mehr Informationen zum Anzeigen von PDF-Inhalten finden Sie im Leitfaden zum Extrahieren von Text und Bildern . Weitere Beispiele finden Sie unter IronPDF HTML zu PDF Codebeispiele . Ihre Anwendung profitiert sofort von der modernen Architektur und den umfassenden Funktionen von IronPDF.
Hinweis:: PDFSharp ist ein eingetragenes Warenzeichen des jeweiligen Besitzers. Diese Seite ist nicht mit PDFSharp verbunden, unterstützt oder sponsert sie. Alle Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Inhaber. Vergleiche dienen nur zu Informationszwecken und spiegeln öffentlich zugängliche Informationen zum Zeitpunkt des Schreibens wider.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.