


更新済み 2026年8月16日
ABCpdf vs IronPDF: .NET PDFライブラリのPDF生成とHTML変換の比較
.NETでのPDF生成にABCpdfとIronPDFのどちらを選ぶべきか?HTMLレンダリングエンジン、機能、使いやすさを比較して、プロジェクトに最適なライブラリを見つけましょう。
もっと読む

C#でHTMLをPDFに変換する主な方法は7つあり、すべての方法が同じ結果を生むわけではありません。2ページの請求書で7つのエンジンをベンチマークしたところ、正しくレンダリングされたのは3つだけでした。他の4つのうち3つは、計算された合計があるべき場所に0.00という金額を印刷し、4つ目は合計ブロックを完全に削除しましたが、エラーや警告は発生しませんでした。これらのエンジンは、最新のCSSのサポート、JavaScriptの実行、負荷時のパフォーマンス、コンテナサイズにおいて異なります。これらの違いは、成功したレンダリングが正しいコンテンツを意味するとは限らないことを示すため、出力を確認した後にのみ明らかになります。このガイドでは、7つのアプローチすべての動作コードと、それぞれのベンチマークデータを提供しており、すべて単一のマシンで測定されています。
ライブラリは主に2つのカテゴリに分かれ、以下の結果を大きく説明しています。ブラウザグレードのレンダラーは完全なChromiumエンジンを使用します。IronPDF(2026.8.1)はパッケージ内にChromiumを含み、PuppeteerSharp(25.8.0)とPlaywright .NET(1.62.0)はDevToolsプロトコルを介して外部ブラウザを制御します。これらの3つは、CSS Grid、Webフォント、キャンバスベースのチャートを含むChromeの出力を再現しますが、より多くのメモリと大きなコンテナを必要とします。レイアウトエンジンライブラリ、例えばiText 9 with pdfHTML(iText Core 9.7.0上の6.3.3)、HtmlRenderer with PdfSharp(1.6.1)、およびAspose.HTML(25.7.0)は独自のレイアウトエンジンを使用し、はるかに小さく、しばしば高速ですが、最新のJavaScriptをサポートしていません。wkhtmltopdf(0.12.6)は中間的なケースで、ES5をサポートするがES6をサポートしない古いQt(4.8.5)WebKitエンジンを使用しています。このガイドのすべてのベンチマークは、4つの同時実行レベルで同じ2ページの請求書を処理し、各PDFを精度のためにレビューしたものに基づいています。
短縮版:IronPDFがリードするところ2026年9月3日に測定、5回のパス、8,960回のタイムレンダリング、.NET 10を実行するアイドル状態の24コアWindows 11デスクトップで。完全な方法と生データは以下にあり、ハーネスはダウンロード可能です。
| 選択する内容 | 勝者 | 測定結果 | 代替案のコスト |
|---|---|---|---|
| 正しいドキュメント | IronPDF | 合計が計算され、チャートが描かれ、グリッドが保持される | 7つのうち4つが誤ったドキュメントを返し、エラーを出さなかった |
| 正しいレンダリングのスループット | IronPDF | 8並列で44.02レンダリング/秒 | 同じマシンでPlaywrightの2.1倍、PuppeteerSharpの2.8倍 |
| メガバイトあたりの作業量 | IronPDF | 持続的なレンダリング/秒あたり27.0 MB | Playwrightは54.3 MB、PuppeteerSharpは82.9 MB |
| 正しいレンダリングのコールドスタート | IronPDF | 最初のPDFまで486 ms | PuppeteerSharpは639 ms、Playwrightは720 ms、Aspose.HTMLは1,096 ms |
| 操作する内容 | IronPDF | ChromiumがNuGetパッケージ内に含まれる | ブラウザエンジンはイメージ、ビルド時のダウンロード、プロセスプール、パッチの頻度を追加する |
| 次に統合する内容 | IronPDF | 同じパッケージでマージ、フォーム、署名、PDF/A、暗号化 | ブラウザエンジンはレンダリングして停止するため、次のステップは2番目の依存関係となる |
上記の速度数値は、ドキュメントを誤ったエンジンに属します。 iText 9は54.30レンダリング/秒、HtmlRendererは327.09を記録し、どちらもページのJavaScriptを実行せずに行いました。スループットの数値は、生成されたドキュメントがなければほとんど意味がないため、ここにあるすべての表には精度の列があります。
IronPDFは正しいレンダリングあたりのスループットでリードしています。 ドキュメントを再現したエンジンの中で、IronPDFは同じマシン、同じドキュメント、同じ待機条件で44.02レンダリング/秒を維持し、3つの中で最もメガバイトあたりの作業量を返し、最も早く最初のPDFに到達しました。
上記のどれよりも重要な発見: 7つのライブラリのうち4つは、完成したように見えるが間違ったPDFを生成しました。そのうち3つでは、請求書の合計が0.00ではなく2313.30と表示されました。4つ目のHtmlRendererは、支払額、合計、チャートを黙って削除しました。いずれの場合も例外は発生せず、出力には何も表示されませんでした。
このガイドでは、.NETでHTMLをPDFに変換する7つの方法を紹介し、それぞれのコードサンプルと定量的なベンチマークを提供します。
使用するには、パッケージをインストールし、レンダラーにHTML文字列を提供し、結果のPDFを保存します。
using IronPdf;

License.LicenseKey = "YOUR-TRIAL-KEY";
var pdf = new ChromePdfRenderer().RenderHtmlAsPdf("<h1>Invoice INV-2026-0814</h1>");
pdf.SaveAs("invoice.pdf");Imports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY"
Dim pdf = New ChromePdfRenderer().RenderHtmlAsPdf("<h1>Invoice INV-2026-0814</h1>")
pdf.SaveAs("invoice.pdf")Imports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY"
Dim pdf = New ChromePdfRenderer().RenderHtmlAsPdf("<h1>Invoice INV-2026-0814</h1>")
pdf.SaveAs("invoice.pdf")
IronPDFの購入または30日間のトライアル登録後、アプリケーションの開始時にライセンスキーを入力します。
IronPdf.License.LicenseKey = "KEY";IronPdf.License.LicenseKey = "KEY";Imports IronPdf
IronPdf.License.LicenseKey = "KEY"Imports IronPdf
IronPdf.License.LicenseKey = "KEY"無料トライアルで今日からプロジェクトにIronPDFを使用し始めましょう。
 NuGet でインストール
上記のクイックスタートは、このガイド全体で使用されるテスト請求書から次の出力を生成します。
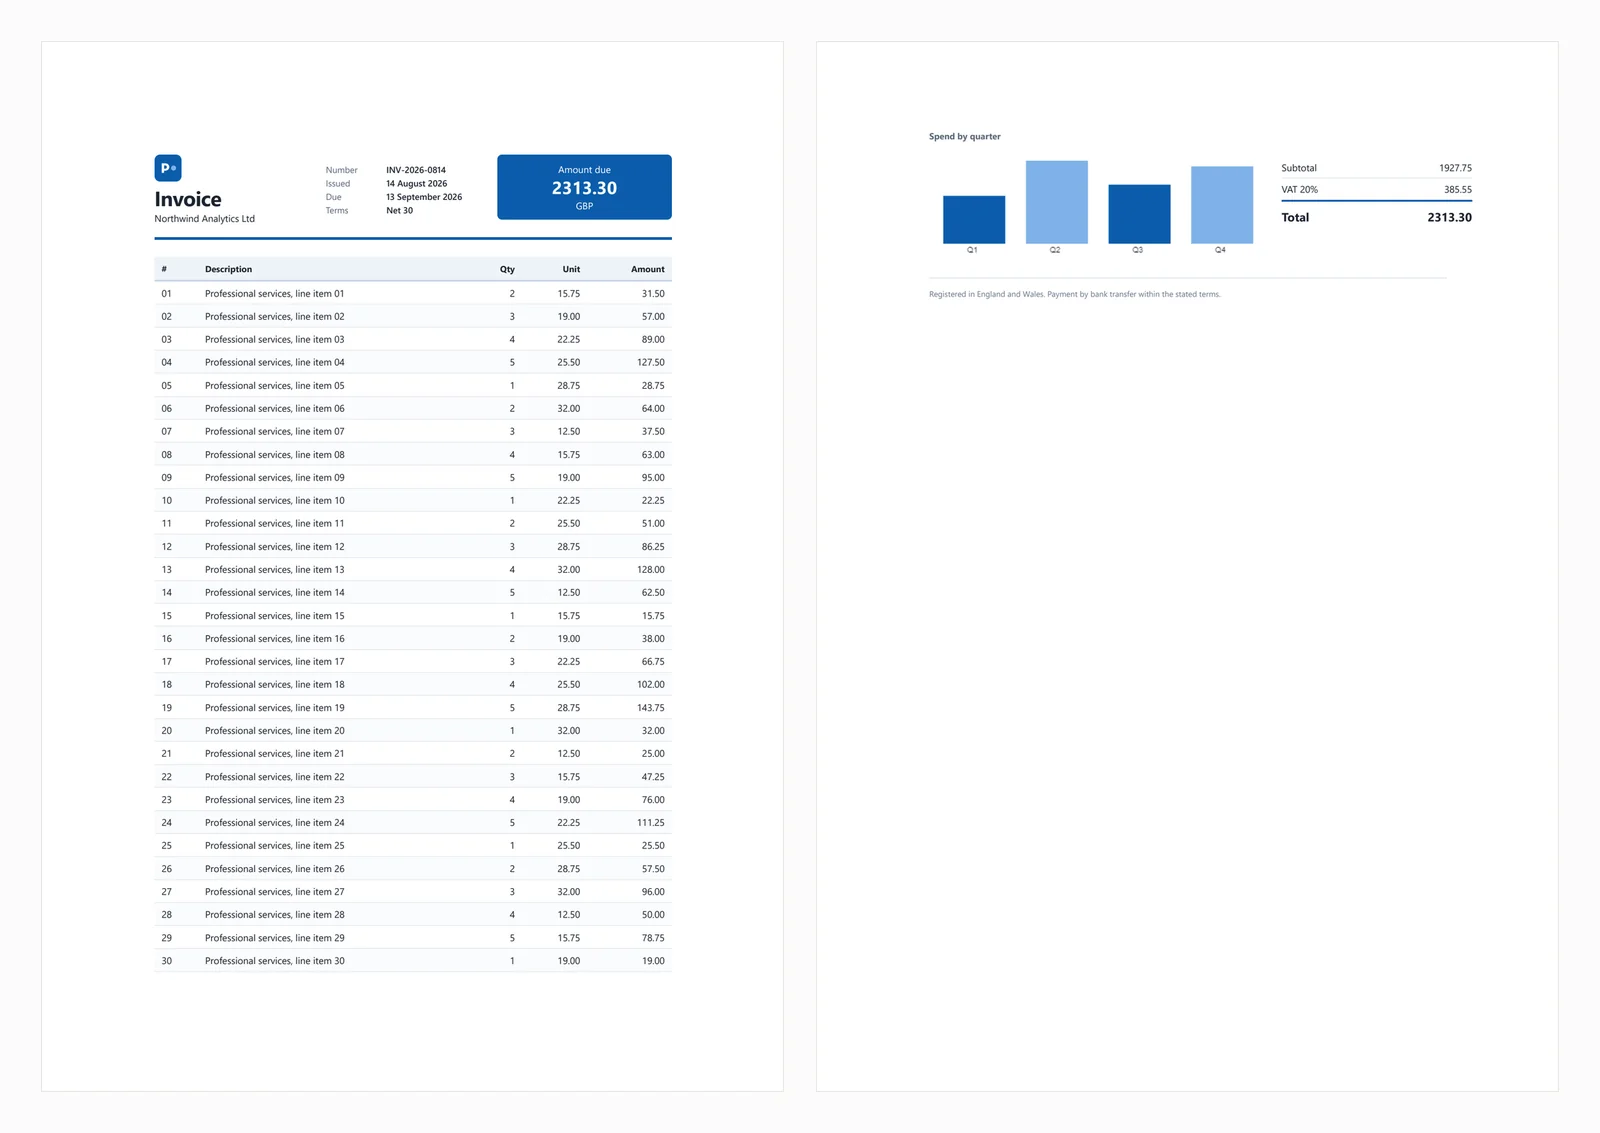
テストドキュメントには、CSS Gridのマストヘッド、ゼブラストライプの30行のテーブル、インラインSVG、canvas要素にレンダリングされた棒グラフ、ロード時にJavaScriptで計算された合計が含まれています。計算された合計はテストにおいて重要であり、JavaScriptサポートのないエンジンは、完全に見えるが支払額が0.00と表示される請求書を生成します。この動作は以下のライブラリのうち3つで見られ、4つ目は合計ブロックを完全に削除します。
一般的な失敗シナリオは以下のセクションで説明されています。
IronPDFは、アプリケーション内で動作するChromiumレンダラーであり、NuGetを介して別途ブラウザをインストールする必要がありません。この違いは主にデプロイメントに影響し、ガイドの後半で説明されています。
インストール:
HTML文字列から:
// IronPDF 2026.8.1
using IronPdf;
License.LicenseKey = "YOUR-TRIAL-KEY"; // trial keys are free
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
var renderer = new ChromePdfRenderer();
renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4;
renderer.RenderingOptions.PrintHtmlBackgrounds = true;
using PdfDocument pdf = renderer.RenderHtmlAsPdf(html);
pdf.SaveAs("invoice.pdf");// IronPDF 2026.8.1
using IronPdf;
License.LicenseKey = "YOUR-TRIAL-KEY"; // trial keys are free
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
var renderer = new ChromePdfRenderer();
renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4;
renderer.RenderingOptions.PrintHtmlBackgrounds = true;
using PdfDocument pdf = renderer.RenderHtmlAsPdf(html);
pdf.SaveAs("invoice.pdf");' IronPDF 2026.8.1
Imports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY" ' trial keys are free
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim renderer As New ChromePdfRenderer()
renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4
renderer.RenderingOptions.PrintHtmlBackgrounds = True
Using pdf As PdfDocument = renderer.RenderHtmlAsPdf(html)
pdf.SaveAs("invoice.pdf")
End Using' IronPDF 2026.8.1
Imports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY" ' trial keys are free
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim renderer As New ChromePdfRenderer()
renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4
renderer.RenderingOptions.PrintHtmlBackgrounds = True
Using pdf As PdfDocument = renderer.RenderHtmlAsPdf(html)
pdf.SaveAs("invoice.pdf")
End UsingライブURLから:
// IronPDF 2026.8.1 - only the render call changes.
using IronPdf;

License.LicenseKey = "YOUR-TRIAL-KEY";

var renderer = new ChromePdfRenderer();

using PdfDocument pdf = renderer.RenderUrlAsPdf("https://ironpdf.com/");
pdf.SaveAs("page.pdf");
// IronPDF 2026.8.1 - only the render call changes.
using IronPdf;
License.LicenseKey = "YOUR-TRIAL-KEY";
var renderer = new ChromePdfRenderer();
using PdfDocument pdf = renderer.RenderUrlAsPdf("https://ironpdf.com/");
pdf.SaveAs("page.pdf");Imports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY"
Dim renderer = New ChromePdfRenderer()
Using pdf As PdfDocument = renderer.RenderUrlAsPdf("https://ironpdf.com/")
pdf.SaveAs("page.pdf")
End UsingImports IronPdf
License.LicenseKey = "YOUR-TRIAL-KEY"
Dim renderer = New ChromePdfRenderer()
Using pdf As PdfDocument = renderer.RenderUrlAsPdf("https://ironpdf.com/")
pdf.SaveAs("page.pdf")
End Using推奨使用法: ヘッドレスブラウザのインフラストラクチャ(プロセスライフサイクル、クラッシュリカバリ、コンテナ設定など)を管理せずに、ブラウザに正確なPDFレンダリングが必要な場合は、IronPDFを選択してください。
トレードオフ: パッケージ内にChromiumを同梱しているため、単一のコールドレンダリングでピークメモリは342 MB、8つの同時レンダリングで1,187 MBに達します。また、価格は$999から始まり、他の6つのうち4つは無料です。サイドプロジェクトや低ボリュームの内部ツールには、そのコストを正当化するのは難しいです。
パフォーマンス: コールドスタート486 ms、8つの同時レンダリングでの中央値レイテンシ161 ms、持続レンダリング44.02回/秒、プロセスツリー全体でのピークメモリ使用量1,187 MB。テスト請求書は、チャートと合計を含めて正確にレンダリングされました。
PuppeteerSharpは、Puppeteerの.NETポートです。Chromiumビルドをダウンロードし、DevToolsプロトコルを介して制御し、PDFを生成します。無料で、MITライセンスで、積極的にメンテナンスされており、ここではPuppeteerSharp (25.8.0)で測定されています。
インストール:
HTML文字列から:
// PuppeteerSharp 25.8.0
using PuppeteerSharp;
using PuppeteerSharp.Media;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// First run downloads roughly 150 MB of Chromium. Pre-fetch this at build time.
await new BrowserFetcher().DownloadAsync();
await using IBrowser browser = await Puppeteer.LaunchAsync(new LaunchOptions { Headless = true });
await using IPage page = await browser.NewPageAsync();
await page.SetContentAsync(html, new SetContentOptions
{
WaitUntil = new[] { WaitUntilNavigation.Load }
});
await page.PdfAsync("invoice.pdf", new PdfOptions
{
Format = PaperFormat.A4,
PrintBackground = true
});// PuppeteerSharp 25.8.0
using PuppeteerSharp;
using PuppeteerSharp.Media;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// First run downloads roughly 150 MB of Chromium. Pre-fetch this at build time.
await new BrowserFetcher().DownloadAsync();
await using IBrowser browser = await Puppeteer.LaunchAsync(new LaunchOptions { Headless = true });
await using IPage page = await browser.NewPageAsync();
await page.SetContentAsync(html, new SetContentOptions
{
WaitUntil = new[] { WaitUntilNavigation.Load }
});
await page.PdfAsync("invoice.pdf", new PdfOptions
{
Format = PaperFormat.A4,
PrintBackground = true
});' PuppeteerSharp 25.8.0
Imports PuppeteerSharp
Imports PuppeteerSharp.Media
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' First run downloads roughly 150 MB of Chromium. Pre-fetch this at build time.
Await (New BrowserFetcher()).DownloadAsync()
Await Using browser As IBrowser = Await Puppeteer.LaunchAsync(New LaunchOptions With {.Headless = True})
Await Using page As IPage = Await browser.NewPageAsync()
Await page.SetContentAsync(html, New SetContentOptions With {.WaitUntil = {WaitUntilNavigation.Load}})
Await page.PdfAsync("invoice.pdf", New PdfOptions With {
.Format = PaperFormat.A4,
.PrintBackground = True
})
End Using
End Using' PuppeteerSharp 25.8.0
Imports PuppeteerSharp
Imports PuppeteerSharp.Media
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' First run downloads roughly 150 MB of Chromium. Pre-fetch this at build time.
Await (New BrowserFetcher()).DownloadAsync()
Await Using browser As IBrowser = Await Puppeteer.LaunchAsync(New LaunchOptions With {.Headless = True})
Await Using page As IPage = Await browser.NewPageAsync()
Await page.SetContentAsync(html, New SetContentOptions With {.WaitUntil = {WaitUntilNavigation.Load}})
Await page.PdfAsync("invoice.pdf", New PdfOptions With {
.Format = PaperFormat.A4,
.PrintBackground = True
})
End Using
End UsingライブURLから:
// PuppeteerSharp 25.8.0 - GoToAsync replaces SetContentAsync.
await using IPage page = await browser.NewPageAsync();

await page.GoToAsync("https://ironpdf.com/", new NavigationOptions
{
    WaitUntil = new[] { WaitUntilNavigation.Networkidle0 }
});

await page.PdfAsync("page.pdf", new PdfOptions { Format = PaperFormat.A4, PrintBackground = true });
// PuppeteerSharp 25.8.0 - GoToAsync replaces SetContentAsync.
await using IPage page = await browser.NewPageAsync();
await page.GoToAsync("https://ironpdf.com/", new NavigationOptions
{
WaitUntil = new[] { WaitUntilNavigation.Networkidle0 }
});
await page.PdfAsync("page.pdf", new PdfOptions { Format = PaperFormat.A4, PrintBackground = true });' PuppeteerSharp 25.8.0 - GoToAsync replaces SetContentAsync.
Await Using page As IPage = Await browser.NewPageAsync()
Await page.GoToAsync("https://ironpdf.com/", New NavigationOptions With {
.WaitUntil = {WaitUntilNavigation.Networkidle0}
})
Await page.PdfAsync("page.pdf", New PdfOptions With {.Format = PaperFormat.A4, .PrintBackground = True})' PuppeteerSharp 25.8.0 - GoToAsync replaces SetContentAsync.
Await Using page As IPage = Await browser.NewPageAsync()
Await page.GoToAsync("https://ironpdf.com/", New NavigationOptions With {
.WaitUntil = {WaitUntilNavigation.Networkidle0}
})
Await page.PdfAsync("page.pdf", New PdfOptions With {.Format = PaperFormat.A4, .PrintBackground = True})推奨使用法: 予算制約が優先事項であり、ブラウザプロセスの管理に慣れている場合は、PuppeteerSharpを選択してください。同じエンジンを使用しているため、Chromeと同一の出力を提供します。
トレードオフ: ブラウザプロセスの管理(ライフサイクル、クラッシュ後の孤立プロセスの処理、サンドボックスの設定など)はあなたの責任です。初回実行時に約150 MBのChromiumをダウンロードし、アウトバウンドネットワークアクセスのないコンテナでは失敗する可能性があるため、ビルド時にブラウザを事前に取得してください。負荷がかかると、PuppeteerSharpは測定されたオプションの中で最も多くのプロセスを生成し、16の同時レンダリングで40に達します。
パフォーマンス: コールドスタート639 ms、8つの同時レンダリングでの中央値レイテンシ507 ms、持続レンダリング15.60回/秒、プロセスツリー全体でのピークメモリ使用量1,293 MB。テスト請求書は正しくレンダリングされました。
.NET用Playwrightは、Microsoftのブラウザ自動化ライブラリです。Puppeteerに似たアプローチを使用しますが、異なるAPI、より効率的なページ分離、類似のデプロイメント考慮事項を提供します。
インストール:
2つ目のコマンドはブラウザバイナリをインストールします。
これを省略することが、CIでの最初のPlaywrightビルドが失敗する最も一般的な原因です。
HTML文字列から:
// Microsoft.Playwright 1.62.0
using Microsoft.Playwright;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// Run "playwright install chromium" first, or call the installer in code.
Microsoft.Playwright.Program.Main(new[] { "install", "chromium" });
using IPlaywright playwright = await Playwright.CreateAsync();
await using IBrowser browser = await playwright.Chromium.LaunchAsync();
IPage page = await browser.NewPageAsync();
await page.SetContentAsync(html, new PageSetContentOptions { WaitUntil = WaitUntilState.Load });
await page.PdfAsync(new PagePdfOptions
{
Path = "invoice.pdf",
Format = "A4",
PrintBackground = true
});// Microsoft.Playwright 1.62.0
using Microsoft.Playwright;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// Run "playwright install chromium" first, or call the installer in code.
Microsoft.Playwright.Program.Main(new[] { "install", "chromium" });
using IPlaywright playwright = await Playwright.CreateAsync();
await using IBrowser browser = await playwright.Chromium.LaunchAsync();
IPage page = await browser.NewPageAsync();
await page.SetContentAsync(html, new PageSetContentOptions { WaitUntil = WaitUntilState.Load });
await page.PdfAsync(new PagePdfOptions
{
Path = "invoice.pdf",
Format = "A4",
PrintBackground = true
});' Microsoft.Playwright 1.62.0
Imports Microsoft.Playwright
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' Run "playwright install chromium" first, or call the installer in code.
Microsoft.Playwright.Program.Main(New String() {"install", "chromium"})
Using playwright As IPlaywright = Await Playwright.CreateAsync()
Await Using browser As IBrowser = Await playwright.Chromium.LaunchAsync()
Dim page As IPage = Await browser.NewPageAsync()
Await page.SetContentAsync(html, New PageSetContentOptions With {.WaitUntil = WaitUntilState.Load})
Await page.PdfAsync(New PagePdfOptions With {
.Path = "invoice.pdf",
.Format = "A4",
.PrintBackground = True
})
End Using
End Using' Microsoft.Playwright 1.62.0
Imports Microsoft.Playwright
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' Run "playwright install chromium" first, or call the installer in code.
Microsoft.Playwright.Program.Main(New String() {"install", "chromium"})
Using playwright As IPlaywright = Await Playwright.CreateAsync()
Await Using browser As IBrowser = Await playwright.Chromium.LaunchAsync()
Dim page As IPage = Await browser.NewPageAsync()
Await page.SetContentAsync(html, New PageSetContentOptions With {.WaitUntil = WaitUntilState.Load})
Await page.PdfAsync(New PagePdfOptions With {
.Path = "invoice.pdf",
.Format = "A4",
.PrintBackground = True
})
End Using
End UsingライブURLから:
// Microsoft.Playwright 1.62.0 - GotoAsync replaces SetContentAsync.
IPage page = await browser.NewPageAsync();

await page.GotoAsync("https://ironpdf.com/", new PageGotoOptions
{
    WaitUntil = WaitUntilState.NetworkIdle
});

await page.PdfAsync(new PagePdfOptions { Path = "page.pdf", Format = "A4", PrintBackground = true });
// Microsoft.Playwright 1.62.0 - GotoAsync replaces SetContentAsync.
IPage page = await browser.NewPageAsync();
await page.GotoAsync("https://ironpdf.com/", new PageGotoOptions
{
WaitUntil = WaitUntilState.NetworkIdle
});
await page.PdfAsync(new PagePdfOptions { Path = "page.pdf", Format = "A4", PrintBackground = true });' Microsoft.Playwright 1.62.0 - GotoAsync replaces SetContentAsync.
Dim page As IPage = Await browser.NewPageAsync()
Await page.GotoAsync("https://ironpdf.com/", New PageGotoOptions With {
.WaitUntil = WaitUntilState.NetworkIdle
})
Await page.PdfAsync(New PagePdfOptions With {.Path = "page.pdf", .Format = "A4", .PrintBackground = True})' Microsoft.Playwright 1.62.0 - GotoAsync replaces SetContentAsync.
Dim page As IPage = Await browser.NewPageAsync()
Await page.GotoAsync("https://ironpdf.com/", New PageGotoOptions With {
.WaitUntil = WaitUntilState.NetworkIdle
})
Await page.PdfAsync(New PagePdfOptions With {.Path = "page.pdf", .Format = "A4", .PrintBackground = True})推奨使用法: ブラウザ品質のレンダリングを無料で必要とし、そのAPIを好む場合、またはテストにPlaywrightを既に使用しており、追加の依存関係を避けたい場合は、.NET用Playwrightを選択してください。
トレードオフ: Playwrightは、Puppeteerと同様の考慮事項を共有しており、イメージ内のブラウザバイナリ、プロセス監視、Dockerfileでのインストールステップを含みます。ここで測定された中で最も安定したエンジンですが、埋め込みエンジンの半分強のスループットを提供します。
パフォーマンス: コールドスタート720 ms、8つの同時レンダリングでの中央値レイテンシー381 ms、持続的なレンダリング20.68回/秒、プロセスツリー全体でのピークメモリ使用量1,122 MB。テスト請求書は正しくレンダリングされました。
pdfHTMLを使用したiText 9は、HTML変換アドオンを備えたPDFライブラリです。ブラウザの代わりに独自のレイアウトエンジンを使用し、サポートされている機能内で迅速かつ予測可能な結果を提供し、それ以外のものについては静かです。2つのパッケージは別々にバージョン管理されています。pdfHTML (6.3.3)はiText Core (9.7.0)上で動作するアドオンであり、ここで測定されたペアリングです。
インストール:
注意: itext7.*パッケージは廃止され、itext.*に名前が変更されましたが、上位のチュートリアルではまだ誤っています。itext.pdfhtmlをインストールし、itext7.pdfhtmlではありません。パッケージ名にはバージョン番号が含まれていないため、itext.pdfhtmlはiText 9の現在のpdfHTMLリリースに解決されます。
HTML文字列から:
// itext.pdfhtml 6.3.3 - AGPL or commercial licence.
// Note the package rename: itext7.pdfhtml is deprecated in favour of itext.pdfhtml.
using iText.Html2pdf;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
using var output = new FileStream("invoice.pdf", FileMode.Create);
HtmlConverter.ConvertToPdf(html, output);
// No JavaScript engine and no canvas, so anything the page computes or draws
// at load time will be missing from the result.// itext.pdfhtml 6.3.3 - AGPL or commercial licence.
// Note the package rename: itext7.pdfhtml is deprecated in favour of itext.pdfhtml.
using iText.Html2pdf;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
using var output = new FileStream("invoice.pdf", FileMode.Create);
HtmlConverter.ConvertToPdf(html, output);
// No JavaScript engine and no canvas, so anything the page computes or draws
// at load time will be missing from the result.// itext.pdfhtml 6.3.3 - AGPL or commercial licence.
// Note the package rename: itext7.pdfhtml is deprecated in favour of itext.pdfhtml.
Imports iText.Html2pdf
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Using output As New FileStream("invoice.pdf", FileMode.Create)
HtmlConverter.ConvertToPdf(html, output)
End Using
' No JavaScript engine and no canvas, so anything the page computes or draws
' at load time will be missing from the result.// itext.pdfhtml 6.3.3 - AGPL or commercial licence.
// Note the package rename: itext7.pdfhtml is deprecated in favour of itext.pdfhtml.
Imports iText.Html2pdf
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Using output As New FileStream("invoice.pdf", FileMode.Create)
HtmlConverter.ConvertToPdf(html, output)
End Using
' No JavaScript engine and no canvas, so anything the page computes or draws
' at load time will be missing from the result.ライブURLから: iTextはURLを直接受け入れません。HTMLを手動で取得し、ベースURIを設定して相対アセットが正しく解決されるようにします。
// itext.pdfhtml 6.3.3 - there is no URL method, so fetch the HTML yourself.
using iText.Html2pdf;

using var client = new HttpClient();
string html = await client.GetStringAsync("https://ironpdf.com/");

// The base URI is what lets relative images, CSS and links resolve.
var properties = new ConverterProperties();
properties.SetBaseUri("https://ironpdf.com/");

using var output = new FileStream("page.pdf", FileMode.Create);
HtmlConverter.ConvertToPdf(html, output, properties);
// itext.pdfhtml 6.3.3 - there is no URL method, so fetch the HTML yourself.
using iText.Html2pdf;
using var client = new HttpClient();
string html = await client.GetStringAsync("https://ironpdf.com/");
// The base URI is what lets relative images, CSS and links resolve.
var properties = new ConverterProperties();
properties.SetBaseUri("https://ironpdf.com/");
using var output = new FileStream("page.pdf", FileMode.Create);
HtmlConverter.ConvertToPdf(html, output, properties);' itext.pdfhtml 6.3.3 - there is no URL method, so fetch the HTML yourself.
Imports iText.Html2pdf
Using client As New HttpClient()
Dim html As String = Await client.GetStringAsync("https://ironpdf.com/")
' The base URI is what lets relative images, CSS and links resolve.
Dim properties As New ConverterProperties()
properties.SetBaseUri("https://ironpdf.com/")
Using output As New FileStream("page.pdf", FileMode.Create)
HtmlConverter.ConvertToPdf(html, output, properties)
End Using
End Using' itext.pdfhtml 6.3.3 - there is no URL method, so fetch the HTML yourself.
Imports iText.Html2pdf
Using client As New HttpClient()
Dim html As String = Await client.GetStringAsync("https://ironpdf.com/")
' The base URI is what lets relative images, CSS and links resolve.
Dim properties As New ConverterProperties()
properties.SetBaseUri("https://ironpdf.com/")
Using output As New FileStream("page.pdf", FileMode.Create)
HtmlConverter.ConvertToPdf(html, output, properties)
End Using
End Using推奨使用法: 他のPDFタスクに既にiTextを使用している場合や、HTML変換とともに高度なPDF操作が必要で、複数のライブラリを避けたい場合は、iTextを選択してください。
トレードオフ: iTextはAGPLまたは有料ライセンスのみで利用可能です。AGPLはアプリケーション全体のオープンソース化を要求するため、クローズドソフトウェアを出荷するほとんどのチームにとって有料オプションが必要です。技術的には、iTextはJavaScriptを実行せず、以下の忠実度ベンチマークで示されるように、ブラウザと比較してより限定的なCSSサポートを提供します。
パフォーマンス: コールドスタート489 ms、8つの同時レンダリングでの中央値レイテンシー144 ms、持続的なレンダリング54.30回/秒、単一プロセスでのピークメモリ使用量332 MB。請求書の合計は0.00であり、チャートはレンダリングされませんでした。
HtmlRenderer with PdfSharpは、純粋なマネージドC#で実装されており、ネイティブバイナリやブラウザ依存性がなく、追加のコンテナインストールも不要です。提示されたオプションの中で最も小さく、最も高速ですが、CSSのサポートは約2011年の標準に限られています。
インストール:
HTML文字列から:
// HtmlRenderer.PdfSharp 1.6.1 - pure managed, no native binaries at all.
using TheArtOfDev.HtmlRenderer.PdfSharp;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
PdfSharp.Pdf.PdfDocument pdf = PdfGenerator.GeneratePdf(html, PdfSharp.PageSize.A4);
pdf.Save("invoice.pdf");
// There is no URL method. Fetch the markup with HttpClient and pass the string.
// CSS support stops well short of Flexbox and Grid, and there is no JavaScript.// HtmlRenderer.PdfSharp 1.6.1 - pure managed, no native binaries at all.
using TheArtOfDev.HtmlRenderer.PdfSharp;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
PdfSharp.Pdf.PdfDocument pdf = PdfGenerator.GeneratePdf(html, PdfSharp.PageSize.A4);
pdf.Save("invoice.pdf");
// There is no URL method. Fetch the markup with HttpClient and pass the string.
// CSS support stops well short of Flexbox and Grid, and there is no JavaScript.' HtmlRenderer.PdfSharp 1.6.1 - pure managed, no native binaries at all.
Imports TheArtOfDev.HtmlRenderer.PdfSharp
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim pdf As PdfSharp.Pdf.PdfDocument = PdfGenerator.GeneratePdf(html, PdfSharp.PageSize.A4)
pdf.Save("invoice.pdf")
' There is no URL method. Fetch the markup with HttpClient and pass the string.
' CSS support stops well short of Flexbox and Grid, and there is no JavaScript.' HtmlRenderer.PdfSharp 1.6.1 - pure managed, no native binaries at all.
Imports TheArtOfDev.HtmlRenderer.PdfSharp
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim pdf As PdfSharp.Pdf.PdfDocument = PdfGenerator.GeneratePdf(html, PdfSharp.PageSize.A4)
pdf.Save("invoice.pdf")
' There is no URL method. Fetch the markup with HttpClient and pass the string.
' CSS support stops well short of Flexbox and Grid, and there is no JavaScript.ライブURLから: 直接URL入力のメソッドはありません。HTMLを手動で取得し、文字列として渡します。
推奨使用: ネイティブバイナリが厳しく禁止されている環境、例えば規制された環境やエアギャップ環境でのみHtmlRenderer with PdfSharpを選択し、ロード時に何も計算しないテンプレートにのみ使用してください。これは、iText 9およびAspose.HTMLと並んで、ネイティブバイナリを出荷しない3つのオプションの1つであり、この請求書ではマストヘッド、合計ブロック、チャートが削除されました。
トレードオフ: HtmlRendererはJavaScript、Flexbox、またはCSS Gridをサポートしていません。固定されたシンプルなテンプレートには十分かもしれませんが、その23 msの中央値のレイテンシーは、単一プロセスで無類です。しかし、現代のブラウザ向けに設計されたHTMLは正しくレンダリングされません。テストでは、CSS Gridのマストヘッド、合計ブロック、チャートが省略され、2ページが1ページに圧縮され、コンテンツが重なりました。
HtmlRendererは測定された中で最も高速なエンジンですが、現代のCSSをレンダリングできません。両方の要因を考慮して決定してください。
パフォーマンス: 157 msのコールドスタート、8つの同時レンダリングで23 msの中央値のレイテンシー、327.09の持続的なレンダリング毎秒、166 MBのピークメモリ使用量、単一プロセス。出力はマストヘッド、合計、チャートが欠けた単一ページでした。
wkhtmltopdfは古いQt WebKitエンジンに基づくコマンドラインツールで、.NETと一般的にDinkToPdfを介して統合されています。エンジン自体のNuGetインストールはないため、アプリケーションと共にバイナリとして出荷する必要があります。DinkToPdfはラッパーとして機能しますが、代替手段も存在します。
HTML文字列から:
// wkhtmltopdf 0.12.6 via DinkToPdf. The engine is archived; the native
// libwkhtmltox binaries must be shipped alongside your application.
using DinkToPdf;
using DinkToPdf.Contracts;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
IConverter converter = new SynchronizedConverter(new PdfTools());
var document = new HtmlToPdfDocument
{
GlobalSettings = { PaperSize = PaperKind.A4, Out = "invoice.pdf" },
Objects = { new ObjectSettings { HtmlContent = html } }
};
converter.Convert(document);// wkhtmltopdf 0.12.6 via DinkToPdf. The engine is archived; the native
// libwkhtmltox binaries must be shipped alongside your application.
using DinkToPdf;
using DinkToPdf.Contracts;
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
IConverter converter = new SynchronizedConverter(new PdfTools());
var document = new HtmlToPdfDocument
{
GlobalSettings = { PaperSize = PaperKind.A4, Out = "invoice.pdf" },
Objects = { new ObjectSettings { HtmlContent = html } }
};
converter.Convert(document);' wkhtmltopdf 0.12.6 via DinkToPdf. The engine is archived; the native
' libwkhtmltox binaries must be shipped alongside your application.
Imports DinkToPdf
Imports DinkToPdf.Contracts
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim converter As IConverter = New SynchronizedConverter(New PdfTools())
Dim document = New HtmlToPdfDocument() With {
.GlobalSettings = New GlobalSettings With {.PaperSize = PaperKind.A4, .Out = "invoice.pdf"},
.Objects = {New ObjectSettings With {.HtmlContent = html}}
}
converter.Convert(document)' wkhtmltopdf 0.12.6 via DinkToPdf. The engine is archived; the native
' libwkhtmltox binaries must be shipped alongside your application.
Imports DinkToPdf
Imports DinkToPdf.Contracts
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
Dim converter As IConverter = New SynchronizedConverter(New PdfTools())
Dim document = New HtmlToPdfDocument() With {
.GlobalSettings = New GlobalSettings With {.PaperSize = PaperKind.A4, .Out = "invoice.pdf"},
.Objects = {New ObjectSettings With {.HtmlContent = html}}
}
converter.Convert(document)ライブURLから:
// wkhtmltopdf 0.12.6 via DinkToPdf - swap HtmlContent for Page.
var document = new HtmlToPdfDocument
{
    GlobalSettings = { PaperSize = PaperKind.A4, Out = "page.pdf" },
    Objects = { new ObjectSettings { Page = "https://ironpdf.com/" } }
};

converter.Convert(document);
// wkhtmltopdf 0.12.6 via DinkToPdf - swap HtmlContent for Page.
var document = new HtmlToPdfDocument
{
GlobalSettings = { PaperSize = PaperKind.A4, Out = "page.pdf" },
Objects = { new ObjectSettings { Page = "https://ironpdf.com/" } }
};
converter.Convert(document);' wkhtmltopdf 0.12.6 via DinkToPdf - swap HtmlContent for Page.
Dim document = New HtmlToPdfDocument With {
.GlobalSettings = New GlobalSettings With {.PaperSize = PaperKind.A4, .Out = "page.pdf"},
.Objects = {New ObjectSettings With {.Page = "https://ironpdf.com/"}}
}
converter.Convert(document)' wkhtmltopdf 0.12.6 via DinkToPdf - swap HtmlContent for Page.
Dim document = New HtmlToPdfDocument With {
.GlobalSettings = New GlobalSettings With {.PaperSize = PaperKind.A4, .Out = "page.pdf"},
.Objects = {New ObjectSettings With {.Page = "https://ironpdf.com/"}}
}
converter.Convert(document)プロジェクトの状況: wkhtmltopdfリポジトリは2023年1月にアーカイブされ、最後の安定版リリース(0.12.6)は2020年6月にQt (4.8.5)上で構築されました。そのレンダリングは約2013年のウェブ標準に固定されており、セキュリティ更新はもう受けていません。
推奨使用法: すでに本番環境で使用されており、ドキュメントが正しくレンダリングされ、テンプレートが静的である場合は、wkhtmltopdfの使用を続けてください。機能要件がない限り、移行は不要です。
トレードオフ: wkhtmltopdfはFlexboxや新しいCSS機能に依存するレイアウトをレンダリングできず、セキュリティパッチを受け取りません。
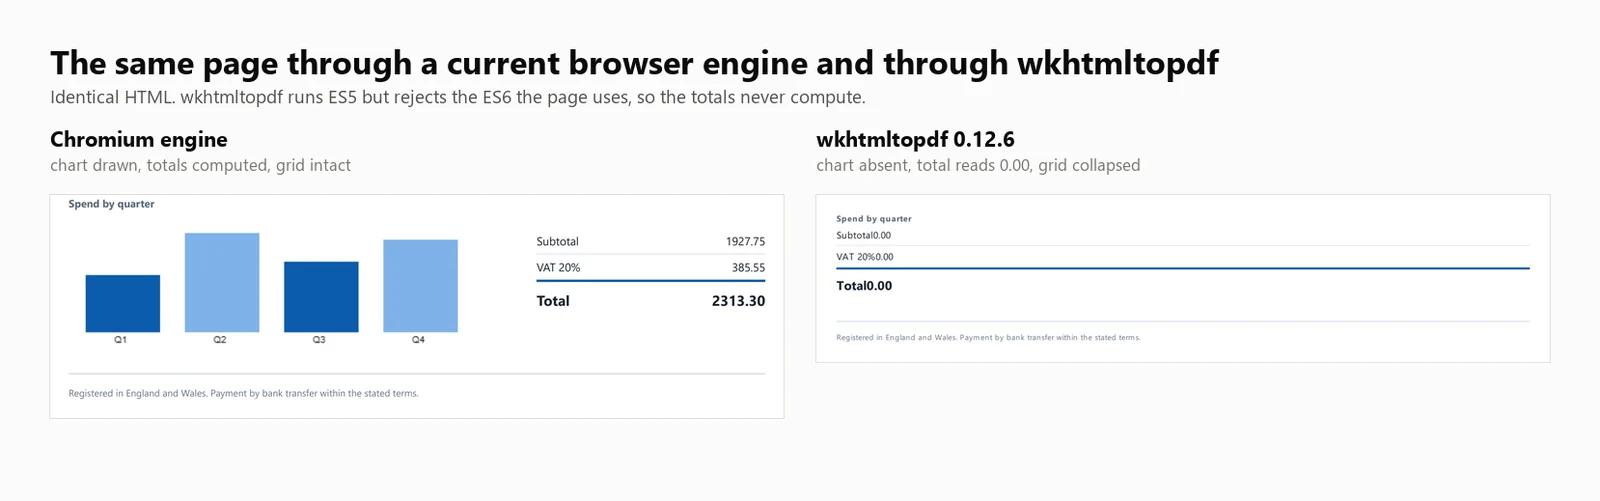
JavaScriptサポート: wkhtmltopdfはES5 JavaScriptを実行しますが、ES6はサポートしていません。このビルドでの直接テストでは、ES5は正常に実行され、ES6ではエラーが発生しました。なぜなら、document.querySelectorAll(...).forEachはQt (4.8.5)エンジンでサポートされていないからです。その結果、この呼び出しを使用するテスト請求書は、エラーなしで0.00のプレースホルダー合計を表示しました。ES5ベースラインに書かれたテンプレートは正しく計算され、最新のJavaScriptを使用するものはそうではありません。
パフォーマンス: コールドスタート424 ms、8つの同時レンダリングでの中央値遅延486 ms、持続的なレンダリングは毎秒16.03回、プロセスツリー全体でのピークメモリ使用量は482 MBでした。請求書の合計は0.00で、グラフはレンダリングされませんでした。
上記の数値は、wkhtmltopdf.exeをコマンドラインツールとして実行し、1レンダリングあたり1プロセスで得られたものです。DinkToPdfラッパーは同じエンジンをインプロセスで使用しますが、すべての呼び出しをSynchronizedConverterを通じて直列化し、同時実行性のスケーラビリティを制限します。
Aspose.HTML for .NETはブラウザではなく独自のレンダリングエンジンを持ち、Word、Excel、PowerPointもカバーするドキュメントスイート内にあります。すでに1つのベンダーから購入しているチームにとっては、複数のライブラリを統合し、別々の更新を追跡する代わりに、1つのサポート契約と1つの購入注文で済むことを意味します。
インストール:
HTML文字列から:
// Aspose.HTML for .NET 25.7.0 - commercial licence, applied from a .lic file.
using Aspose.Html;
using Aspose.Html.Converters;
using Aspose.Html.Saving;
new License().SetLicense("Aspose.HTMLProductFamily.lic");
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// The second argument is the base URL relative assets resolve against.
using var doc = new HTMLDocument(html, ".");
Converter.ConvertHTML(doc, new PdfSaveOptions(), "invoice.pdf");
// Its own rendering stack, not a browser: ES5 runs, ES6 throws, so anything the
// page computes with modern syntax is left at its initial value.// Aspose.HTML for .NET 25.7.0 - commercial licence, applied from a .lic file.
using Aspose.Html;
using Aspose.Html.Converters;
using Aspose.Html.Saving;
new License().SetLicense("Aspose.HTMLProductFamily.lic");
string html = @"<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>";
// The second argument is the base URL relative assets resolve against.
using var doc = new HTMLDocument(html, ".");
Converter.ConvertHTML(doc, new PdfSaveOptions(), "invoice.pdf");
// Its own rendering stack, not a browser: ES5 runs, ES6 throws, so anything the
// page computes with modern syntax is left at its initial value.// Aspose.HTML for .NET 25.7.0 - commercial licence, applied from a .lic file.
Imports Aspose.Html
Imports Aspose.Html.Converters
Imports Aspose.Html.Saving
Call New License().SetLicense("Aspose.HTMLProductFamily.lic")
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' The second argument is the base URL relative assets resolve against.
Using doc = New HTMLDocument(html, ".")
Converter.ConvertHTML(doc, New PdfSaveOptions(), "invoice.pdf")
End Using
' Its own rendering stack, not a browser: ES5 runs, ES6 throws, so anything the
' page computes with modern syntax is left at its initial value.// Aspose.HTML for .NET 25.7.0 - commercial licence, applied from a .lic file.
Imports Aspose.Html
Imports Aspose.Html.Converters
Imports Aspose.Html.Saving
Call New License().SetLicense("Aspose.HTMLProductFamily.lic")
Dim html As String = "<h1>Invoice INV-2026-0814</h1>
<p>Northwind Analytics Ltd — Net 30</p>
<table><tr><th>Item</th><th>Amount</th></tr>
<tr><td>Professional services</td><td>2313.30</td></tr></table>"
' The second argument is the base URL relative assets resolve against.
Using doc = New HTMLDocument(html, ".")
Converter.ConvertHTML(doc, New PdfSaveOptions(), "invoice.pdf")
End Using
' Its own rendering stack, not a browser: ES5 runs, ES6 throws, so anything the
' page computes with modern syntax is left at its initial value.ライブURLから:
// Aspose.HTML 25.7.0 - only the HTMLDocument constructor changes.
using Aspose.Html;
using Aspose.Html.Converters;
using Aspose.Html.Saving;

new License().SetLicense("Aspose.HTMLProductFamily.lic");

using var doc = new HTMLDocument("https://ironpdf.com/");
Converter.ConvertHTML(doc, new PdfSaveOptions(), "page.pdf");
// Aspose.HTML 25.7.0 - only the HTMLDocument constructor changes.
using Aspose.Html;
using Aspose.Html.Converters;
using Aspose.Html.Saving;
new License().SetLicense("Aspose.HTMLProductFamily.lic");
using var doc = new HTMLDocument("https://ironpdf.com/");
Converter.ConvertHTML(doc, new PdfSaveOptions(), "page.pdf");' Aspose.HTML 25.7.0 - only the HTMLDocument constructor changes.
Imports Aspose.Html
Imports Aspose.Html.Converters
Imports Aspose.Html.Saving
New License().SetLicense("Aspose.HTMLProductFamily.lic")
Using doc As New HTMLDocument("https://ironpdf.com/")
Converter.ConvertHTML(doc, New PdfSaveOptions(), "page.pdf")
End Using' Aspose.HTML 25.7.0 - only the HTMLDocument constructor changes.
Imports Aspose.Html
Imports Aspose.Html.Converters
Imports Aspose.Html.Saving
New License().SetLicense("Aspose.HTMLProductFamily.lic")
Using doc As New HTMLDocument("https://ironpdf.com/")
Converter.ConvertHTML(doc, New PdfSaveOptions(), "page.pdf")
End Using推奨使用法: 他の形式でAsposeを標準化しており、同じ契約の下でHTML変換を希望し、最新のJavaScriptに依存しないテンプレートを使用する場合にAspose.HTMLを選択してください。
トレードオフ: 無料のティアがない有料ライブラリであり、そのレンダリングはブラウザではなくレイアウトエンジンに属します。Aspose.HTMLはプロフェッショナルライセンスの下でベンチマークされ、その数値は以下のすべての表に表示されます。
パフォーマンス: コールドスタート1,096 ms、8つの同時レンダリングでの中央値遅延227 ms、持続レンダリング毎秒33.98、単一プロセスでのピークメモリ使用量334 MB。請求書の合計は0.00で、チャートはレンダリングされませんでした。
以下のすべての数値は、1台のマシン、1つのドキュメント、および単一の日付での5回のパスのキャンペーンから得られました。これら3つはここに記載されているため、数値はその価値に基づいて再現または却下することができます。
バージョン列は、記事が書かれたバージョンではなく、実行時にロードされたアセンブリからハーネスが読み取ったものです。そのため、固定バージョン以外のものに解決されるパッケージがここに表示されることがあります。
| ライブラリ | パッケージ | テストされたバージョン | 実行時に報告されたアセンブリ | エンジン |
|---|---|---|---|---|
| IronPDF | IronPdf | 2026.8.1 | 2026.8.0.1 | 埋め込みChromium |
| Playwright .NET | Microsoft.Playwright | 1.62.0 | 1.62.0.0 | 外部Chromium |
| PuppeteerSharp | PuppeteerSharp | 25.8.0 | 25.8.0.0 | 外部Chromium |
| iText 9 with pdfHTML | itext.pdfhtml | 6.3.3 | 6.3.3.0 on iText Core 9.7.0 | 独自のレイアウトエンジン |
| HtmlRenderer + PdfSharp | HtmlRenderer.PdfSharp | 1.6.1 | 1.6.1.0 | 独自のレイアウトエンジン |
| wkhtmltopdf | コマンドラインバイナリ | 0.12.6 | 0.12.6 | Qt 4.8.5上のQtWebKit 5.212 |
| Aspose.HTML | Aspose.HTML | 25.7.0 | 25.7.0.0 | 独自のレイアウトエンジン |
| 項目 | 値 |
|---|---|
| CPU | 24コア / 32スレッド x64 デスクトップ、3.2 GHz |
| メモリ | 64 GB |
| オペレーティングシステム | Windows 11 x64、ビルド 10.0.26200 |
| ランタイム | .NET 10.0.11、リリースビルド |
| マシン状態 | アイドル、他のアプリケーションは実行されていない |
| テスト日 | 2026年9月3日 |
| サンプルサイズ | 8,960回のタイムレンダリング: 7エンジン x 4同時実行レベル x 64レンダリング x 5パス |
| コールドスタート起動 | 105: 7エンジン x 3起動 x 5パス |
| 報告された数値 | 5パスの中央値、決してベストケースではない |
すべてのエンジンには、メモリ内で文字列として同一の10,260文字のHTMLドキュメントが渡されました。どのエンジンも他のエンジンが受け取らなかったファイルパス、URL、またはウォームドキャッシュを受け取っていません。このドキュメントは以下のダウンロードにあり、信頼に頼るのではなく差分を取ることができます。
Load、ネットワークアイドルではありません。PuppeteerSharpはSetContentのネットワークアイドル条件を廃止したため、Loadが3つのエンジンすべてが同一にサポートする唯一の条件です。MemoryStreamに書き込むため、他のエンジンが避けるディスクコストを支払いません。タイミングの境界: ストップウォッチはレンダーコールが行われたときに開始し、エンジンがPDFバイトを返すときに停止します。エンジンの構築とブラウザの起動は別途コールドスタートとして測定され、ディスクへの書き込みはどのエンジンにも要求されていません。スループットは、成功したレンダリングをバッチ全体の壁時計秒で割ったもので、個々のレンダー時間の合計ではありません。なぜなら、最初のものだけが負荷下でサービスが提供するものを説明するからです。
メモリの定義: ベンチマークプロセスから実際の親子系譜によって派生したすべてのプロセスを含むプロセスツリー全体で、100ミリ秒ごとにサンプリングされたピークワーキングセットの合計です。これは平均ではなくピークです。なぜなら、ピークがコンテナが最も忙しい1秒を生き延びるかどうかを決定するからです。ブラウザエンジンはほとんどのメモリを生成された子プロセスに保持するため、.NETプロセスのみを測定すると、最も多くのプロセスを生成するエンジンを優遇することになります。
失敗と見なされるもの: 500バイト未満を返すレンダリング。失敗はスループットの分子から除外され、別途報告されるため、エンジンが何も返さずに高いレートを投稿することはできません。これらのテーブルの背後にある35回の呼び出しの中で、どのエンジンもいかなるレベルでも単一の失敗を記録しませんでした。
以下の表におけるすべての速度とメモリの値は、実際の測定に基づいています。ライブラリが測定されていない場合、表にはこれが明示的に示されています。
| ライブラリ | コールドスタート | ウォーム p50 at 8 | スループット at 8 | ピークメモリ at 8 | テスト請求書のレンダリング | ライセンス |
|---|---|---|---|---|---|---|
| IronPDF (2026.8.1) | 486 ms | 161 ms | 44.02/s | 1,187 MB | 正しい | $999から |
| Playwright .NET (1.62.0) | 720 ms | 381 ms | 20.68/s | 1,122 MB | 正しい | MIT |
| PuppeteerSharp (25.8.0) | 639 ms | 507 ms | 15.60/s | 1,293 MB | 正しい | MIT |
| iText 9 pdfHTML (6.3.3) | 489 ms | 144 ms | 54.30/s | 332 MB | 合計 0.00、チャートなし | AGPLまたは有料 |
| HtmlRenderer + PdfSharp (1.6.1) | 157 ms | 23 ms | 327.09/s | 166 MB | マストヘッドなし、合計なし、チャートなし | 無料、BSD |
| wkhtmltopdf (0.12.6) | 424 ms | 486 ms | 16.03/s | 482 MB | 合計 0.00、チャートなし | LGPL、アーカイブ済み |
| Aspose.HTML (25.7.0) | 1,096 ms | 227 ms | 33.98/s | 334 MB | 合計 0.00、チャートなし | 有料 |
テスト環境: 24コア / 32スレッド x64 デスクトップCPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
スループットの数値をレンダリング精度とともに解釈します。測定された7つのエンジンのうち、4つは重要なレンダリング作業を省略しており、表の中で最も高速な結果であるiText 9の54.30/sとHtmlRendererの327.09/sは、そのグループに属しています。
以下のセクションでは、各サマリーテーブルエントリの詳細な数値を提供します。
すべてのエンジンは、上記で説明した同じ2ページの請求書をレンダリングしました。それをサンプルではなく測定器にするのは合計です。それらはプレースホルダー0.00値としてマークアップに含まれ、ロード時にJavaScriptで計算されるため、スクリプトを実行したエンジンはテキストレイヤーに2313.30を書き込み、実行しなかったエンジンは正規表現が見つけるプレースホルダーを残します。
using System.Text;

// The benchmark document. Two pages, a CSS Grid masthead, a 30-row table,
// an inline SVG mark, and a bar chart drawn on a canvas element.
//
// The totals ship as placeholder zeroes and are computed in JavaScript at load
// time, so the output itself records whether the engine ran the script. An
// engine with no script engine produces a clean invoice whose total reads 0.00.
static class TestDocument
{
    public static string Invoice()
    {
        var rows = new StringBuilder();
        for (int i = 1; i <= 30; i++)
        {
            decimal unit = 12.50m + (i % 7) * 3.25m;
            int qty = 1 + (i % 5);
            rows.Append($@"
      <tr>
        <td>{i:00}</td>
        <td>Professional services, line item {i:00}</td>
        <td class=""num"">{qty}</td>
        <td class=""num"">{unit:0.00}</td>
        <td class=""num"">{unit * qty:0.00}</td>
      </tr>");
        }

        return $@"<!DOCTYPE html>
<html lang=""en"">
<head>
<meta charset=""utf-8"">
<title>Invoice INV-2026-0814</title>
<style>
  body {{ font-family: 'Segoe UI', 'Helvetica Neue', Arial, sans-serif; color:#1c2430; padding:32px; font-size:12px; }}
  .masthead {{ display:grid; grid-template-columns: 1fr 1fr 220px; gap:20px;
               border-bottom:3px solid #0b5cab; padding-bottom:16px; margin-bottom:22px; }}
  .badge {{ background:#0b5cab; color:#fff; padding:10px 14px; border-radius:6px; text-align:center; }}
  table {{ width:100%; border-collapse:collapse; }}
  th {{ background:#eef3f9; text-align:left; padding:7px 9px; border-bottom:2px solid #c6d4e5; }}
  td {{ padding:6px 9px; border-bottom:1px solid #e7ecf3; }}
  tr:nth-child(even) td {{ background:#fafbfd; }}
  td.num, th.num {{ text-align:right; font-variant-numeric:tabular-nums; }}
  .chartwrap {{ margin-top:26px; display:grid; grid-template-columns:1fr 240px; gap:24px; }}
  .totals {{ list-style:none; padding:0; }}
  .totals li {{ display:flex; justify-content:space-between; padding:5px 0; border-bottom:1px solid #e7ecf3; }}
  .totals li.grand {{ font-weight:700; font-size:15px; border-top:2px solid #0b5cab; }}
</style>
</head>
<body>

<header class=""masthead"">
  <div>
    <svg width=""34"" height=""34"" viewBox=""0 0 34 34"">
      <rect width=""34"" height=""34"" rx=""7"" fill=""#0b5cab""/>
      <circle cx=""24"" cy=""17"" r=""3.2"" fill=""#7fb2e8""/>
    </svg>
    <h1>Invoice</h1>
  </div>
  <dl><dt>Number</dt><dd>INV-2026-0814</dd><dt>Terms</dt><dd>Net 30</dd></dl>
  <div class=""badge"">Amount due<span id=""badge-total"">0.00</span>GBP</div>
</header>

<table>
  <thead>
    <tr><th>#</th><th>Description</th><th class=""num"">Qty</th><th class=""num"">Unit</th><th class=""num"">Amount</th></tr>
  </thead>
  <tbody>{rows}
  </tbody>
</table>

<section class=""chartwrap"">
  <div>
    <strong>Spend by quarter</strong>
    <canvas id=""chart"" width=""420"" height=""140""></canvas>
  </div>
  <ul class=""totals"">
    <li><span>Subtotal</span><span id=""sub"">0.00</span></li>
    <li><span>VAT 20%</span><span id=""vat"">0.00</span></li>
    <li class=""grand""><span>Total</span><span id=""tot"">0.00</span></li>
  </ul>
</section>

<script>
  // Totals are computed here, not in the markup. An engine that skips
  // JavaScript leaves the placeholder zeroes in the output.
  var sub = 0;
  document.querySelectorAll('tbody tr').forEach(function (tr) {{
    sub += parseFloat(tr.lastElementChild.textContent);
  }});
  var vat = sub * 0.2, tot = sub + vat;
  var f = function (n) {{ return n.toFixed(2); }};
  document.getElementById('sub').textContent = f(sub);
  document.getElementById('vat').textContent = f(vat);
  document.getElementById('tot').textContent = f(tot);
  document.getElementById('badge-total').textContent = f(tot);

  // A canvas chart, the way a dashboard library would draw one.
  var data = [sub * 0.18, sub * 0.31, sub * 0.22, sub * 0.29];
  var c = document.getElementById('chart').getContext('2d');
  var max = Math.max.apply(null, data), bw = 78, gap = 26, base = 128;
  data.forEach(function (v, i) {{
    var h = Math.round((v / max) * 104);
    c.fillStyle = i % 2 ? '#7fb2e8' : '#0b5cab';
    c.fillRect(18 + i * (bw + gap), base - h, bw, h);
    c.fillStyle = '#1c2430';
    c.font = '10px sans-serif';
    c.fillText('Q' + (i + 1), 18 + i * (bw + gap) + 30, base + 11);
  }});
</script>

</body>
</html>";
    }
}
using System.Text;
// The benchmark document. Two pages, a CSS Grid masthead, a 30-row table,
// an inline SVG mark, and a bar chart drawn on a canvas element.
//
// The totals ship as placeholder zeroes and are computed in JavaScript at load
// time, so the output itself records whether the engine ran the script. An
// engine with no script engine produces a clean invoice whose total reads 0.00.
static class TestDocument
{
public static string Invoice()
{
var rows = new StringBuilder();
for (int i = 1; i <= 30; i++)
{
decimal unit = 12.50m + (i % 7) * 3.25m;
int qty = 1 + (i % 5);
rows.Append($@"
<tr>
<td>{i:00}</td>
<td>Professional services, line item {i:00}</td>
<td class=""num"">{qty}</td>
<td class=""num"">{unit:0.00}</td>
<td class=""num"">{unit * qty:0.00}</td>
</tr>");
}
return $@"<!DOCTYPE html>
<html lang=""en"">
<head>
<meta charset=""utf-8"">
<title>Invoice INV-2026-0814</title>
<style>
body {{ font-family: 'Segoe UI', 'Helvetica Neue', Arial, sans-serif; color:#1c2430; padding:32px; font-size:12px; }}
.masthead {{ display:grid; grid-template-columns: 1fr 1fr 220px; gap:20px;
border-bottom:3px solid #0b5cab; padding-bottom:16px; margin-bottom:22px; }}
.badge {{ background:#0b5cab; color:#fff; padding:10px 14px; border-radius:6px; text-align:center; }}
table {{ width:100%; border-collapse:collapse; }}
th {{ background:#eef3f9; text-align:left; padding:7px 9px; border-bottom:2px solid #c6d4e5; }}
td {{ padding:6px 9px; border-bottom:1px solid #e7ecf3; }}
tr:nth-child(even) td {{ background:#fafbfd; }}
td.num, th.num {{ text-align:right; font-variant-numeric:tabular-nums; }}
.chartwrap {{ margin-top:26px; display:grid; grid-template-columns:1fr 240px; gap:24px; }}
.totals {{ list-style:none; padding:0; }}
.totals li {{ display:flex; justify-content:space-between; padding:5px 0; border-bottom:1px solid #e7ecf3; }}
.totals li.grand {{ font-weight:700; font-size:15px; border-top:2px solid #0b5cab; }}
</style>
</head>
<body>
<header class=""masthead"">
<div>
<svg width=""34"" height=""34"" viewBox=""0 0 34 34"">
<rect width=""34"" height=""34"" rx=""7"" fill=""#0b5cab""/>
<circle cx=""24"" cy=""17"" r=""3.2"" fill=""#7fb2e8""/>
</svg>
<h1>Invoice</h1>
</div>
<dl><dt>Number</dt><dd>INV-2026-0814</dd><dt>Terms</dt><dd>Net 30</dd></dl>
<div class=""badge"">Amount due<span id=""badge-total"">0.00</span>GBP</div>
</header>
<table>
<thead>
<tr><th>#</th><th>Description</th><th class=""num"">Qty</th><th class=""num"">Unit</th><th class=""num"">Amount</th></tr>
</thead>
<tbody>{rows}
</tbody>
</table>
<section class=""chartwrap"">
<div>
<strong>Spend by quarter</strong>
<canvas id=""chart"" width=""420"" height=""140""></canvas>
</div>
<ul class=""totals"">
<li><span>Subtotal</span><span id=""sub"">0.00</span></li>
<li><span>VAT 20%</span><span id=""vat"">0.00</span></li>
<li class=""grand""><span>Total</span><span id=""tot"">0.00</span></li>
</ul>
</section>
<script>
// Totals are computed here, not in the markup. An engine that skips
// JavaScript leaves the placeholder zeroes in the output.
var sub = 0;
document.querySelectorAll('tbody tr').forEach(function (tr) {{
sub += parseFloat(tr.lastElementChild.textContent);
}});
var vat = sub * 0.2, tot = sub + vat;
var f = function (n) {{ return n.toFixed(2); }};
document.getElementById('sub').textContent = f(sub);
document.getElementById('vat').textContent = f(vat);
document.getElementById('tot').textContent = f(tot);
document.getElementById('badge-total').textContent = f(tot);
// A canvas chart, the way a dashboard library would draw one.
var data = [sub * 0.18, sub * 0.31, sub * 0.22, sub * 0.29];
var c = document.getElementById('chart').getContext('2d');
var max = Math.max.apply(null, data), bw = 78, gap = 26, base = 128;
data.forEach(function (v, i) {{
var h = Math.round((v / max) * 104);
c.fillStyle = i % 2 ? '#7fb2e8' : '#0b5cab';
c.fillRect(18 + i * (bw + gap), base - h, bw, h);
c.fillStyle = '#1c2430';
c.font = '10px sans-serif';
c.fillText('Q' + (i + 1), 18 + i * (bw + gap) + 30, base + 11);
}});
</script>
</body>
</html>";
}
}Imports System.Text
' The benchmark document. Two pages, a CSS Grid masthead, a 30-row table,
' an inline SVG mark, and a bar chart drawn on a canvas element.
'
' The totals ship as placeholder zeroes and are computed in JavaScript at load
' time, so the output itself records whether the engine ran the script. An
' engine with no script engine produces a clean invoice whose total reads 0.00.
Friend Module TestDocument
Public Function Invoice() As String
Dim rows = New StringBuilder()
For i As Integer = 1 To 30
Dim unit As Decimal = 12.5D + (i Mod 7) * 3.25D
Dim qty As Integer = 1 + (i Mod 5)
rows.AppendFormat(
" <tr>
<td>{0:00}</td>
<td>Professional services, line item {0:00}</td>
<td class=""num"">{1}</td>
<td class=""num"">{2:0.00}</td>
<td class=""num"">{3:0.00}</td>
</tr>", i, qty, unit, unit * qty)
Next
Return "<!DOCTYPE html>
<html lang=""en"">
<head>
<meta charset=""utf-8"">
<title>Invoice INV-2026-0814</title>
<style>
body { font-family: 'Segoe UI', 'Helvetica Neue', Arial, sans-serif; color:#1c2430; padding:32px; font-size:12px; }
.masthead { display:grid; grid-template-columns: 1fr 1fr 220px; gap:20px;
border-bottom:3px solid #0b5cab; padding-bottom:16px; margin-bottom:22px; }
.badge { background:#0b5cab; color:#fff; padding:10px 14px; border-radius:6px; text-align:center; }
table { width:100%; border-collapse:collapse; }
th { background:#eef3f9; text-align:left; padding:7px 9px; border-bottom:2px solid #c6d4e5; }
td { padding:6px 9px; border-bottom:1px solid #e7ecf3; }
tr:nth-child(even) td { background:#fafbfd; }
td.num, th.num { text-align:right; font-variant-numeric:tabular-nums; }
.chartwrap { margin-top:26px; display:grid; grid-template-columns:1fr 240px; gap:24px; }
.totals { list-style:none; padding:0; }
.totals li { display:flex; justify-content:space-between; padding:5px 0; border-bottom:1px solid #e7ecf3; }
.totals li.grand { font-weight:700; font-size:15px; border-top:2px solid #0b5cab; }
</style>
</head>
<body>
<header class=""masthead"">
<div>
<svg width=""34"" height=""34"" viewBox=""0 0 34 34"">
<rect width=""34"" height=""34"" rx=""7"" fill=""#0b5cab""/>
<circle cx=""24"" cy=""17"" r=""3.2"" fill=""#7fb2e8""/>
</svg>
<h1>Invoice</h1>
</div>
<dl><dt>Number</dt><dd>INV-2026-0814</dd><dt>Terms</dt><dd>Net 30</dd></dl>
<div class=""badge"">Amount due<span id=""badge-total"">0.00</span>GBP</div>
</header>
<table>
<thead>
<tr><th>#</th><th>Description</th><th class=""num"">Qty</th><th class=""num"">Unit</th><th class=""num"">Amount</th></tr>
</thead>
<tbody>" & rows.ToString() & "
</tbody>
</table>
<section class=""chartwrap"">
<div>
<strong>Spend by quarter</strong>
<canvas id=""chart"" width=""420"" height=""140""></canvas>
</div>
<ul class=""totals"">
<li><span>Subtotal</span><span id=""sub"">0.00</span></li>
<li><span>VAT 20%</span><span id=""vat"">0.00</span></li>
<li class=""grand""><span>Total</span><span id=""tot"">0.00</span></li>
</ul>
</section>
<script>
var sub = 0;
document.querySelectorAll('tbody tr').forEach(function (tr) {
sub += parseFloat(tr.lastElementChild.textContent);
});
var vat = sub * 0.2, tot = sub + vat;
var f = function (n) { return n.toFixed(2); };
document.getElementById('sub').textContent = f(sub);
document.getElementById('vat').textContent = f(vat);
document.getElementById('tot').textContent = f(tot);
document.getElementById('badge-total').textContent = f(tot);
var data = [sub * 0.18, sub * 0.31, sub * 0.22, sub * 0.29];
var c = document.getElementById('chart').getContext('2d');
var max = Math.max.apply(null, data), bw = 78, gap = 26, base = 128;
data.forEach(function (v, i) {
var h = Math.round((v / max) * 104);
c.fillStyle = i % 2 ? '#7fb2e8' : '#0b5cab';
c.fillRect(18 + i * (bw + gap), base - h, bw, h);
c.fillStyle = '#1c2430';
c.font = '10px sans-serif';
c.fillText('Q' + (i + 1), 18 + i * (bw + gap) + 30, base + 11);
});
</script>
</body>
</html>"
End Function
End ModuleImports System.Text
' The benchmark document. Two pages, a CSS Grid masthead, a 30-row table,
' an inline SVG mark, and a bar chart drawn on a canvas element.
'
' The totals ship as placeholder zeroes and are computed in JavaScript at load
' time, so the output itself records whether the engine ran the script. An
' engine with no script engine produces a clean invoice whose total reads 0.00.
Friend Module TestDocument
Public Function Invoice() As String
Dim rows = New StringBuilder()
For i As Integer = 1 To 30
Dim unit As Decimal = 12.5D + (i Mod 7) * 3.25D
Dim qty As Integer = 1 + (i Mod 5)
rows.AppendFormat(
" <tr>
<td>{0:00}</td>
<td>Professional services, line item {0:00}</td>
<td class=""num"">{1}</td>
<td class=""num"">{2:0.00}</td>
<td class=""num"">{3:0.00}</td>
</tr>", i, qty, unit, unit * qty)
Next
Return "<!DOCTYPE html>
<html lang=""en"">
<head>
<meta charset=""utf-8"">
<title>Invoice INV-2026-0814</title>
<style>
body { font-family: 'Segoe UI', 'Helvetica Neue', Arial, sans-serif; color:#1c2430; padding:32px; font-size:12px; }
.masthead { display:grid; grid-template-columns: 1fr 1fr 220px; gap:20px;
border-bottom:3px solid #0b5cab; padding-bottom:16px; margin-bottom:22px; }
.badge { background:#0b5cab; color:#fff; padding:10px 14px; border-radius:6px; text-align:center; }
table { width:100%; border-collapse:collapse; }
th { background:#eef3f9; text-align:left; padding:7px 9px; border-bottom:2px solid #c6d4e5; }
td { padding:6px 9px; border-bottom:1px solid #e7ecf3; }
tr:nth-child(even) td { background:#fafbfd; }
td.num, th.num { text-align:right; font-variant-numeric:tabular-nums; }
.chartwrap { margin-top:26px; display:grid; grid-template-columns:1fr 240px; gap:24px; }
.totals { list-style:none; padding:0; }
.totals li { display:flex; justify-content:space-between; padding:5px 0; border-bottom:1px solid #e7ecf3; }
.totals li.grand { font-weight:700; font-size:15px; border-top:2px solid #0b5cab; }
</style>
</head>
<body>
<header class=""masthead"">
<div>
<svg width=""34"" height=""34"" viewBox=""0 0 34 34"">
<rect width=""34"" height=""34"" rx=""7"" fill=""#0b5cab""/>
<circle cx=""24"" cy=""17"" r=""3.2"" fill=""#7fb2e8""/>
</svg>
<h1>Invoice</h1>
</div>
<dl><dt>Number</dt><dd>INV-2026-0814</dd><dt>Terms</dt><dd>Net 30</dd></dl>
<div class=""badge"">Amount due<span id=""badge-total"">0.00</span>GBP</div>
</header>
<table>
<thead>
<tr><th>#</th><th>Description</th><th class=""num"">Qty</th><th class=""num"">Unit</th><th class=""num"">Amount</th></tr>
</thead>
<tbody>" & rows.ToString() & "
</tbody>
</table>
<section class=""chartwrap"">
<div>
<strong>Spend by quarter</strong>
<canvas id=""chart"" width=""420"" height=""140""></canvas>
</div>
<ul class=""totals"">
<li><span>Subtotal</span><span id=""sub"">0.00</span></li>
<li><span>VAT 20%</span><span id=""vat"">0.00</span></li>
<li class=""grand""><span>Total</span><span id=""tot"">0.00</span></li>
</ul>
</section>
<script>
var sub = 0;
document.querySelectorAll('tbody tr').forEach(function (tr) {
sub += parseFloat(tr.lastElementChild.textContent);
});
var vat = sub * 0.2, tot = sub + vat;
var f = function (n) { return n.toFixed(2); };
document.getElementById('sub').textContent = f(sub);
document.getElementById('vat').textContent = f(vat);
document.getElementById('tot').textContent = f(tot);
document.getElementById('badge-total').textContent = f(tot);
var data = [sub * 0.18, sub * 0.31, sub * 0.22, sub * 0.29];
var c = document.getElementById('chart').getContext('2d');
var max = Math.max.apply(null, data), bw = 78, gap = 26, base = 128;
data.forEach(function (v, i) {
var h = Math.round((v / max) * 104);
c.fillStyle = i % 2 ? '#7fb2e8' : '#0b5cab';
c.fillRect(18 + i * (bw + gap), base - h, bw, h);
c.fillStyle = '#1c2430';
c.font = '10px sans-serif';
c.fillText('Q' + (i + 1), 18 + i * (bw + gap) + 30, base + 11);
});
</script>
</body>
</html>"
End Function
End ModuleWorkingSet64の高水位マークで、100 msごとにサンプリングされます。これは平均ではなくピークであり、ピークがコンテナが最も忙しい秒を生き延びるかどうかを決定します。using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Linq;
using System.Threading;
using System.Threading.Tasks;
const int TotalRenders = 64;
int[] levels = { 1, 4, 8, 16 };
string html = TestDocument.Invoice();
IEngine engine = Engines.Create("ironpdf");
await engine.InitAsync();
// Warm the engine so the sweep measures steady state rather than a cold start
// smeared across the first few results.
for (int i = 0; i < 5; i++) await engine.RenderAsync(html);
foreach (int concurrency in levels)
{
var sampler = new TreeMemorySampler();
var latencies = new List<double>(TotalRenders);
int failures = 0;
object gate = new();
GC.Collect();
GC.WaitForPendingFinalizers();
sampler.Start();
var wall = Stopwatch.StartNew();
using (var semaphore = new SemaphoreSlim(concurrency))
{
IEnumerable<Task> work = Enumerable.Range(0, TotalRenders).Select(async _ =>
{
await semaphore.WaitAsync();
var perRender = Stopwatch.StartNew();
try
{
byte[] pdf = await engine.RenderAsync(html);
perRender.Stop();
// An engine that returns quickly by returning nothing must not
// be rewarded with a throughput number.
if (pdf == null || pdf.Length < 500) lock (gate) failures++;
else lock (gate) latencies.Add(perRender.Elapsed.TotalMilliseconds);
}
catch
{
lock (gate) failures++;
}
finally { semaphore.Release(); }
});
await Task.WhenAll(work);
}
wall.Stop();
sampler.Stop();
latencies.Sort();
double throughput = (TotalRenders - failures) / wall.Elapsed.TotalSeconds;
Console.WriteLine(
$"C={concurrency,-2} {throughput,6:0.00} rend/s " +
$"p50 {Percentile(latencies, 50),6:0} ms " +
$"p95 {Percentile(latencies, 95),6:0} ms " +
$"peak {sampler.PeakBytes / 1024.0 / 1024.0,6:0} MB " +
$"procs {sampler.PeakProcessCount,2} fail {failures}");
}
await engine.DisposeAsync();
// Report percentiles rather than means. A mean hides the tail, and the tail is
// what your users experience.
static double Percentile(List<double> sorted, int p)
{
if (sorted.Count == 0) return -1;
double rank = (p / 100.0) * (sorted.Count - 1);
int low = (int)Math.Floor(rank);
int high = (int)Math.Ceiling(rank);
return low == high
? sorted[low]
: sorted[low] + (rank - low) * (sorted[high] - sorted[low]);
}using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Linq;
using System.Threading;
using System.Threading.Tasks;
const int TotalRenders = 64;
int[] levels = { 1, 4, 8, 16 };
string html = TestDocument.Invoice();
IEngine engine = Engines.Create("ironpdf");
await engine.InitAsync();
// Warm the engine so the sweep measures steady state rather than a cold start
// smeared across the first few results.
for (int i = 0; i < 5; i++) await engine.RenderAsync(html);
foreach (int concurrency in levels)
{
var sampler = new TreeMemorySampler();
var latencies = new List<double>(TotalRenders);
int failures = 0;
object gate = new();
GC.Collect();
GC.WaitForPendingFinalizers();
sampler.Start();
var wall = Stopwatch.StartNew();
using (var semaphore = new SemaphoreSlim(concurrency))
{
IEnumerable<Task> work = Enumerable.Range(0, TotalRenders).Select(async _ =>
{
await semaphore.WaitAsync();
var perRender = Stopwatch.StartNew();
try
{
byte[] pdf = await engine.RenderAsync(html);
perRender.Stop();
// An engine that returns quickly by returning nothing must not
// be rewarded with a throughput number.
if (pdf == null || pdf.Length < 500) lock (gate) failures++;
else lock (gate) latencies.Add(perRender.Elapsed.TotalMilliseconds);
}
catch
{
lock (gate) failures++;
}
finally { semaphore.Release(); }
});
await Task.WhenAll(work);
}
wall.Stop();
sampler.Stop();
latencies.Sort();
double throughput = (TotalRenders - failures) / wall.Elapsed.TotalSeconds;
Console.WriteLine(
$"C={concurrency,-2} {throughput,6:0.00} rend/s " +
$"p50 {Percentile(latencies, 50),6:0} ms " +
$"p95 {Percentile(latencies, 95),6:0} ms " +
$"peak {sampler.PeakBytes / 1024.0 / 1024.0,6:0} MB " +
$"procs {sampler.PeakProcessCount,2} fail {failures}");
}
await engine.DisposeAsync();
// Report percentiles rather than means. A mean hides the tail, and the tail is
// what your users experience.
static double Percentile(List<double> sorted, int p)
{
if (sorted.Count == 0) return -1;
double rank = (p / 100.0) * (sorted.Count - 1);
int low = (int)Math.Floor(rank);
int high = (int)Math.Ceiling(rank);
return low == high
? sorted[low]
: sorted[low] + (rank - low) * (sorted[high] - sorted[low]);
}Imports System
Imports System.Collections.Generic
Imports System.Diagnostics
Imports System.Linq
Imports System.Threading
Imports System.Threading.Tasks
Const TotalRenders As Integer = 64
Dim levels As Integer() = {1, 4, 8, 16}
Dim html As String = TestDocument.Invoice()
Dim engine As IEngine = Engines.Create("ironpdf")
Await engine.InitAsync()
' Warm the engine so the sweep measures steady state rather than a cold start
' smeared across the first few results.
For i As Integer = 0 To 4
Await engine.RenderAsync(html)
Next
For Each concurrency As Integer In levels
Dim sampler = New TreeMemorySampler()
Dim latencies = New List(Of Double)(TotalRenders)
Dim failures As Integer = 0
Dim gate As New Object()
GC.Collect()
GC.WaitForPendingFinalizers()
sampler.Start()
Dim wall = Stopwatch.StartNew()
Using semaphore = New SemaphoreSlim(concurrency)
Dim work As IEnumerable(Of Task) = Enumerable.Range(0, TotalRenders).[Select](Async Function(_)
Await semaphore.WaitAsync()
Dim perRender = Stopwatch.StartNew()
Try
Dim pdf As Byte() = Await engine.RenderAsync(html)
perRender.Stop()
' An engine that returns quickly by returning nothing must not
' be rewarded with a throughput number.
If pdf Is Nothing OrElse pdf.Length < 500 Then
SyncLock gate
failures += 1
End SyncLock
Else
SyncLock gate
latencies.Add(perRender.Elapsed.TotalMilliseconds)
End SyncLock
End If
Catch
SyncLock gate
failures += 1
End SyncLock
Finally
semaphore.Release()
End Try
End Function)
Await Task.WhenAll(work)
End Using
wall.Stop()
sampler.Stop()
latencies.Sort()
Dim throughput As Double = (TotalRenders - failures) / wall.Elapsed.TotalSeconds
Console.WriteLine($"C={concurrency,-2} {throughput,6:0.00} rend/s " &
$"p50 {Percentile(latencies, 50),6:0} ms " &
$"p95 {Percentile(latencies, 95),6:0} ms " &
$"peak {sampler.PeakBytes / 1024.0 / 1024.0,6:0} MB " &
$"procs {sampler.PeakProcessCount,2} fail {failures}")
Next
Await engine.DisposeAsync()
' Report percentiles rather than means. A mean hides the tail, and the tail is
' what your users experience.
Private Shared Function Percentile(sorted As List(Of Double), p As Integer) As Double
If sorted.Count = 0 Then Return -1
Dim rank As Double = (p / 100.0) * (sorted.Count - 1)
Dim low As Integer = CInt(Math.Floor(rank))
Dim high As Integer = CInt(Math.Ceiling(rank))
Return If(low = high, sorted(low), sorted(low) + (rank - low) * (sorted(high) - sorted(low)))
End FunctionImports System
Imports System.Collections.Generic
Imports System.Diagnostics
Imports System.Linq
Imports System.Threading
Imports System.Threading.Tasks
Const TotalRenders As Integer = 64
Dim levels As Integer() = {1, 4, 8, 16}
Dim html As String = TestDocument.Invoice()
Dim engine As IEngine = Engines.Create("ironpdf")
Await engine.InitAsync()
' Warm the engine so the sweep measures steady state rather than a cold start
' smeared across the first few results.
For i As Integer = 0 To 4
Await engine.RenderAsync(html)
Next
For Each concurrency As Integer In levels
Dim sampler = New TreeMemorySampler()
Dim latencies = New List(Of Double)(TotalRenders)
Dim failures As Integer = 0
Dim gate As New Object()
GC.Collect()
GC.WaitForPendingFinalizers()
sampler.Start()
Dim wall = Stopwatch.StartNew()
Using semaphore = New SemaphoreSlim(concurrency)
Dim work As IEnumerable(Of Task) = Enumerable.Range(0, TotalRenders).[Select](Async Function(_)
Await semaphore.WaitAsync()
Dim perRender = Stopwatch.StartNew()
Try
Dim pdf As Byte() = Await engine.RenderAsync(html)
perRender.Stop()
' An engine that returns quickly by returning nothing must not
' be rewarded with a throughput number.
If pdf Is Nothing OrElse pdf.Length < 500 Then
SyncLock gate
failures += 1
End SyncLock
Else
SyncLock gate
latencies.Add(perRender.Elapsed.TotalMilliseconds)
End SyncLock
End If
Catch
SyncLock gate
failures += 1
End SyncLock
Finally
semaphore.Release()
End Try
End Function)
Await Task.WhenAll(work)
End Using
wall.Stop()
sampler.Stop()
latencies.Sort()
Dim throughput As Double = (TotalRenders - failures) / wall.Elapsed.TotalSeconds
Console.WriteLine($"C={concurrency,-2} {throughput,6:0.00} rend/s " &
$"p50 {Percentile(latencies, 50),6:0} ms " &
$"p95 {Percentile(latencies, 95),6:0} ms " &
$"peak {sampler.PeakBytes / 1024.0 / 1024.0,6:0} MB " &
$"procs {sampler.PeakProcessCount,2} fail {failures}")
Next
Await engine.DisposeAsync()
' Report percentiles rather than means. A mean hides the tail, and the tail is
' what your users experience.
Private Shared Function Percentile(sorted As List(Of Double), p As Integer) As Double
If sorted.Count = 0 Then Return -1
Dim rank As Double = (p / 100.0) * (sorted.Count - 1)
Dim low As Integer = CInt(Math.Floor(rank))
Dim high As Integer = CInt(Math.Ceiling(rank))
Return If(low = high, sorted(low), sorted(low) + (rank - low) * (sorted(high) - sorted(low)))
End Functionusing System;
using System.Diagnostics;
using System.Globalization;
using System.Threading.Tasks;
// Cold start cannot be measured inside a process that has already rendered.
// The parent spawns this same binary with --cold, so every reading is a real
// process start rather than a first call inside an already-warm runtime.
// --- child mode: initialise one engine, render once, print, exit ------------
if (args.Length == 2 && args[0] == "--cold")
{
var sampler = new TreeMemorySampler();
sampler.Start();
var sw = Stopwatch.StartNew();
IEngine engine = Engines.Create(args[1]);
await engine.InitAsync();
byte[] first = await engine.RenderAsync(TestDocument.Invoice());
sw.Stop();
sampler.Stop();
Console.WriteLine($"COLD_MS={sw.Elapsed.TotalMilliseconds:0.0}");
Console.WriteLine($"COLD_PEAK_MB={sampler.PeakBytes / 1024.0 / 1024.0:0.0}");
Console.WriteLine($"BYTES={first.Length}");
try { await engine.DisposeAsync(); } catch { }
Environment.Exit(0);
}
// --- parent mode: run three fresh children and take the minimum -------------
static (double ms, double peakMb) RunColdChild(string engineId)
{
var psi = new ProcessStartInfo
{
FileName = Environment.ProcessPath,
RedirectStandardOutput = true,
RedirectStandardError = true,
UseShellExecute = false
};
psi.ArgumentList.Add("--cold");
psi.ArgumentList.Add(engineId);
using Process p = Process.Start(psi);
string output = p.StandardOutput.ReadToEnd();
p.WaitForExit(180_000);
double ms = -1, mb = 0;
foreach (string line in output.Split('\n'))
{
if (line.StartsWith("COLD_MS="))
double.TryParse(line.Substring(8).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, out ms);
if (line.StartsWith("COLD_PEAK_MB="))
double.TryParse(line.Substring(13).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, out mb);
}
return (ms, mb);
}
// Take the minimum of three, not the mean. The first run of any engine absorbs
// one-time costs - assembly loading, a browser download, a native extraction -
// which are real deployment costs but are not per-start costs, and averaging
// them in blurs two different numbers together.
var readings = new List<double>();
double peak = 0;
for (int i = 0; i < 3; i++)
{
var (ms, mb) = RunColdChild("ironpdf");
if (ms > 0) { readings.Add(ms); peak = Math.Max(peak, mb); }
}
Console.WriteLine($"cold start (best of {readings.Count}): {readings.Min():0} ms, peak {peak:0} MB");using System;
using System.Diagnostics;
using System.Globalization;
using System.Threading.Tasks;
// Cold start cannot be measured inside a process that has already rendered.
// The parent spawns this same binary with --cold, so every reading is a real
// process start rather than a first call inside an already-warm runtime.
// --- child mode: initialise one engine, render once, print, exit ------------
if (args.Length == 2 && args[0] == "--cold")
{
var sampler = new TreeMemorySampler();
sampler.Start();
var sw = Stopwatch.StartNew();
IEngine engine = Engines.Create(args[1]);
await engine.InitAsync();
byte[] first = await engine.RenderAsync(TestDocument.Invoice());
sw.Stop();
sampler.Stop();
Console.WriteLine($"COLD_MS={sw.Elapsed.TotalMilliseconds:0.0}");
Console.WriteLine($"COLD_PEAK_MB={sampler.PeakBytes / 1024.0 / 1024.0:0.0}");
Console.WriteLine($"BYTES={first.Length}");
try { await engine.DisposeAsync(); } catch { }
Environment.Exit(0);
}
// --- parent mode: run three fresh children and take the minimum -------------
static (double ms, double peakMb) RunColdChild(string engineId)
{
var psi = new ProcessStartInfo
{
FileName = Environment.ProcessPath,
RedirectStandardOutput = true,
RedirectStandardError = true,
UseShellExecute = false
};
psi.ArgumentList.Add("--cold");
psi.ArgumentList.Add(engineId);
using Process p = Process.Start(psi);
string output = p.StandardOutput.ReadToEnd();
p.WaitForExit(180_000);
double ms = -1, mb = 0;
foreach (string line in output.Split('\n'))
{
if (line.StartsWith("COLD_MS="))
double.TryParse(line.Substring(8).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, out ms);
if (line.StartsWith("COLD_PEAK_MB="))
double.TryParse(line.Substring(13).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, out mb);
}
return (ms, mb);
}
// Take the minimum of three, not the mean. The first run of any engine absorbs
// one-time costs - assembly loading, a browser download, a native extraction -
// which are real deployment costs but are not per-start costs, and averaging
// them in blurs two different numbers together.
var readings = new List<double>();
double peak = 0;
for (int i = 0; i < 3; i++)
{
var (ms, mb) = RunColdChild("ironpdf");
if (ms > 0) { readings.Add(ms); peak = Math.Max(peak, mb); }
}
Console.WriteLine($"cold start (best of {readings.Count}): {readings.Min():0} ms, peak {peak:0} MB");Imports System
Imports System.Diagnostics
Imports System.Globalization
Imports System.Threading.Tasks
' Cold start cannot be measured inside a process that has already rendered.
' The parent spawns this same binary with --cold, so every reading is a real
' process start rather than a first call inside an already-warm runtime.
' --- child mode: initialise one engine, render once, print, exit ------------
If args.Length = 2 AndAlso args(0) = "--cold" Then
Dim sampler = New TreeMemorySampler()
sampler.Start()
Dim sw = Stopwatch.StartNew()
Dim engine As IEngine = Engines.Create(args(1))
Await engine.InitAsync()
Dim first() As Byte = Await engine.RenderAsync(TestDocument.Invoice())
sw.Stop()
sampler.Stop()
Console.WriteLine($"COLD_MS={sw.Elapsed.TotalMilliseconds:0.0}")
Console.WriteLine($"COLD_PEAK_MB={sampler.PeakBytes / 1024.0 / 1024.0:0.0}")
Console.WriteLine($"BYTES={first.Length}")
Try
Await engine.DisposeAsync()
Catch
End Try
Environment.Exit(0)
End If
' --- parent mode: run three fresh children and take the minimum -------------
Private Shared Function RunColdChild(engineId As String) As (ms As Double, peakMb As Double)
Dim psi = New ProcessStartInfo With {
.FileName = Environment.ProcessPath,
.RedirectStandardOutput = True,
.RedirectStandardError = True,
.UseShellExecute = False
}
psi.ArgumentList.Add("--cold")
psi.ArgumentList.Add(engineId)
Using p As Process = Process.Start(psi)
Dim output As String = p.StandardOutput.ReadToEnd()
p.WaitForExit(180000)
Dim ms As Double = -1, mb As Double = 0
For Each line As String In output.Split(vbLf)
If line.StartsWith("COLD_MS=") Then
Double.TryParse(line.Substring(8).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, ms)
End If
If line.StartsWith("COLD_PEAK_MB=") Then
Double.TryParse(line.Substring(13).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, mb)
End If
Next
Return (ms, mb)
End Using
End Function
' Take the minimum of three, not the mean. The first run of any engine absorbs
' one-time costs - assembly loading, a browser download, a native extraction -
' which are real deployment costs but are not per-start costs, and averaging
' them in blurs two different numbers together.
Dim readings = New List(Of Double)()
Dim peak As Double = 0
For i As Integer = 0 To 2
Dim result = RunColdChild("ironpdf")
Dim ms = result.ms
Dim mb = result.peakMb
If ms > 0 Then
readings.Add(ms)
peak = Math.Max(peak, mb)
End If
Next
Console.WriteLine($"cold start (best of {readings.Count}): {readings.Min():0} ms, peak {peak:0} MB")Imports System
Imports System.Diagnostics
Imports System.Globalization
Imports System.Threading.Tasks
' Cold start cannot be measured inside a process that has already rendered.
' The parent spawns this same binary with --cold, so every reading is a real
' process start rather than a first call inside an already-warm runtime.
' --- child mode: initialise one engine, render once, print, exit ------------
If args.Length = 2 AndAlso args(0) = "--cold" Then
Dim sampler = New TreeMemorySampler()
sampler.Start()
Dim sw = Stopwatch.StartNew()
Dim engine As IEngine = Engines.Create(args(1))
Await engine.InitAsync()
Dim first() As Byte = Await engine.RenderAsync(TestDocument.Invoice())
sw.Stop()
sampler.Stop()
Console.WriteLine($"COLD_MS={sw.Elapsed.TotalMilliseconds:0.0}")
Console.WriteLine($"COLD_PEAK_MB={sampler.PeakBytes / 1024.0 / 1024.0:0.0}")
Console.WriteLine($"BYTES={first.Length}")
Try
Await engine.DisposeAsync()
Catch
End Try
Environment.Exit(0)
End If
' --- parent mode: run three fresh children and take the minimum -------------
Private Shared Function RunColdChild(engineId As String) As (ms As Double, peakMb As Double)
Dim psi = New ProcessStartInfo With {
.FileName = Environment.ProcessPath,
.RedirectStandardOutput = True,
.RedirectStandardError = True,
.UseShellExecute = False
}
psi.ArgumentList.Add("--cold")
psi.ArgumentList.Add(engineId)
Using p As Process = Process.Start(psi)
Dim output As String = p.StandardOutput.ReadToEnd()
p.WaitForExit(180000)
Dim ms As Double = -1, mb As Double = 0
For Each line As String In output.Split(vbLf)
If line.StartsWith("COLD_MS=") Then
Double.TryParse(line.Substring(8).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, ms)
End If
If line.StartsWith("COLD_PEAK_MB=") Then
Double.TryParse(line.Substring(13).Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, mb)
End If
Next
Return (ms, mb)
End Using
End Function
' Take the minimum of three, not the mean. The first run of any engine absorbs
' one-time costs - assembly loading, a browser download, a native extraction -
' which are real deployment costs but are not per-start costs, and averaging
' them in blurs two different numbers together.
Dim readings = New List(Of Double)()
Dim peak As Double = 0
For i As Integer = 0 To 2
Dim result = RunColdChild("ironpdf")
Dim ms = result.ms
Dim mb = result.peakMb
If ms > 0 Then
readings.Add(ms)
peak = Math.Max(peak, mb)
End If
Next
Console.WriteLine($"cold start (best of {readings.Count}): {readings.Min():0} ms, peak {peak:0} MB")ハーネスはこれらのコントロールをすべての測定に適用します。
GC.Collect と WaitForPendingFinalizers は各レベルの前に実行されます。エンジンごとの構成はアダプターで設定されます。以下の各決定は、どのエンジンにも構成上の利点を与えないようにしています。
Load、同じA4用紙サイズ、および印刷された背景を取得します。MemoryStreamに書き込むため、他のエンジンが回避するディスクI/Oを支払いません。using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Runtime.InteropServices;
using System.Threading;
using System.Threading.Tasks;
// Samples the whole process tree, not just the .NET process.
//
// Several rendering libraries keep most of their memory in spawned browser
// processes, so measuring only the managed side flatters whichever engine
// spawns the most children. Two things have to be right for the reading to be
// fair, and both are easy to get wrong.
//
// First, attribution is by real ancestry rather than by process name. Matching
// a list of renderer names and counting anything that started after the
// benchmark did over-counts on any machine with a browser or an Electron
// application open: a library that spawns nothing reports several processes and
// a few hundred spare MB.
//
// Second, the tree and its memory are read from one system-wide snapshot.
// Asking the operating system about each process in turn cannot keep up with an
// engine that starts and exits renderers faster than the sample interval: the
// child is in the process list, and gone by the time its working set is read.
// NtQuerySystemInformation returns process id, parent id, creation time and
// working set for every process in a single call, so the shape of the tree and
// the memory in it come from the same instant.
sealed class TreeMemorySampler
{
// pid -> the creation time it had when it was claimed. Windows recycles
// process ids quickly and these engines churn through short-lived children,
// so a pid on its own is not an identity.
readonly Dictionary<int, long> _ours = new Dictionary<int, long>();
long _ourCreateTime = -1;
CancellationTokenSource _cts;
Task _loop;
public long PeakBytes { get; private set; }
public int PeakProcessCount { get; private set; }
public void Start()
{
PeakBytes = 0;
PeakProcessCount = 0;
_cts = new CancellationTokenSource();
CancellationToken token = _cts.Token;
_loop = Task.Run(async () =>
{
while (!token.IsCancellationRequested)
{
Sample();
try { await Task.Delay(100, token); }
catch (TaskCanceledException) { return; }
}
}, token);
}
public void Stop()
{
Sample(); // one final reading, in case the peak landed late
_cts?.Cancel();
try { _loop?.Wait(2000); } catch { }
}
void Sample()
{
List<Entry> all = Snapshot();
if (all.Count == 0) return;
int self = Environment.ProcessId;
foreach (Entry e in all)
if (e.Pid == self) { _ourCreateTime = e.CreateTime; break; }
if (_ourCreateTime < 0) return;
_ours[self] = _ourCreateTime;
// Drop any claim whose pid now carries a different creation time: that
// pid was recycled and the process wearing it belongs to someone else.
var live = new Dictionary<int, long>(all.Count);
foreach (Entry e in all) live[e.Pid] = e.CreateTime;
var recycled = new List<int>();
foreach (KeyValuePair<int, long> claim in _ours)
{
long now;
if (live.TryGetValue(claim.Key, out now) && now != claim.Value)
recycled.Add(claim.Key);
}
foreach (int pid in recycled) _ours.Remove(pid);
// Grow the owned set until it stops growing: a child seen in this
// snapshot may itself be the parent of another process in it. Claims
// survive the process exiting, so a grandchild still counts once the
// child that launched it is gone.
bool added = true;
while (added)
{
added = false;
foreach (Entry e in all)
{
if (_ours.ContainsKey(e.Pid)) continue;
long parentClaim;
if (!_ours.TryGetValue(e.Ppid, out parentClaim)) continue;
// A parent only vouches for children started after it.
if (e.CreateTime < parentClaim) continue;
_ours[e.Pid] = e.CreateTime;
added = true;
}
}
long total = 0;
int count = 0;
foreach (Entry e in all)
{
long claim;
if (!_ours.TryGetValue(e.Pid, out claim) || claim != e.CreateTime) continue;
total += e.WorkingSet;
count++;
}
// Track the peak, not the average. The peak is what decides whether
// the container survives its busiest second.
if (total > PeakBytes) PeakBytes = total;
if (count > PeakProcessCount) PeakProcessCount = count;
}
readonly struct Entry
{
public readonly int Pid, Ppid;
public readonly long CreateTime, WorkingSet;
public Entry(int pid, int ppid, long create, long ws)
{
Pid = pid; Ppid = ppid; CreateTime = create; WorkingSet = ws;
}
}
// ---- one atomic system-wide process snapshot ---------------------------
// SYSTEM_PROCESS_INFORMATION, x64 field offsets: CreateTime 32,
// UniqueProcessId 80, InheritedFromUniqueProcessId 88, WorkingSetSize 144.
const int SystemProcessInformation = 5;
const uint STATUS_INFO_LENGTH_MISMATCH = 0xC0000004;
[DllImport("ntdll.dll")]
static extern uint NtQuerySystemInformation(int systemInformationClass,
IntPtr systemInformation, int systemInformationLength, out int returnLength);
static int _bufferSize = 1 << 20;
static List<Entry> Snapshot()
{
var list = new List<Entry>(400);
IntPtr buffer = IntPtr.Zero;
try
{
for (int attempt = 0; attempt < 8; attempt++)
{
if (buffer != IntPtr.Zero) Marshal.FreeHGlobal(buffer);
buffer = Marshal.AllocHGlobal(_bufferSize);
int needed;
uint status = NtQuerySystemInformation(
SystemProcessInformation, buffer, _bufferSize, out needed);
if (status == 0)
{
long offset = 0;
while (true)
{
IntPtr entry = buffer + (int)offset;
int next = Marshal.ReadInt32(entry, 0);
long create = Marshal.ReadInt64(entry, 32);
int pid = (int)Marshal.ReadIntPtr(entry, 80);
int ppid = (int)Marshal.ReadIntPtr(entry, 88);
long ws = (long)Marshal.ReadIntPtr(entry, 144);
if (pid != 0) list.Add(new Entry(pid, ppid, create, ws));
if (next == 0) break;
offset += next;
}
return list;
}
if (status != STATUS_INFO_LENGTH_MISMATCH) return list;
_bufferSize = Math.Max(needed + (64 * 1024), _bufferSize * 2);
}
}
catch { }
finally { if (buffer != IntPtr.Zero) Marshal.FreeHGlobal(buffer); }
return list;
}
}using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Runtime.InteropServices;
using System.Threading;
using System.Threading.Tasks;
// Samples the whole process tree, not just the .NET process.
//
// Several rendering libraries keep most of their memory in spawned browser
// processes, so measuring only the managed side flatters whichever engine
// spawns the most children. Two things have to be right for the reading to be
// fair, and both are easy to get wrong.
//
// First, attribution is by real ancestry rather than by process name. Matching
// a list of renderer names and counting anything that started after the
// benchmark did over-counts on any machine with a browser or an Electron
// application open: a library that spawns nothing reports several processes and
// a few hundred spare MB.
//
// Second, the tree and its memory are read from one system-wide snapshot.
// Asking the operating system about each process in turn cannot keep up with an
// engine that starts and exits renderers faster than the sample interval: the
// child is in the process list, and gone by the time its working set is read.
// NtQuerySystemInformation returns process id, parent id, creation time and
// working set for every process in a single call, so the shape of the tree and
// the memory in it come from the same instant.
sealed class TreeMemorySampler
{
// pid -> the creation time it had when it was claimed. Windows recycles
// process ids quickly and these engines churn through short-lived children,
// so a pid on its own is not an identity.
readonly Dictionary<int, long> _ours = new Dictionary<int, long>();
long _ourCreateTime = -1;
CancellationTokenSource _cts;
Task _loop;
public long PeakBytes { get; private set; }
public int PeakProcessCount { get; private set; }
public void Start()
{
PeakBytes = 0;
PeakProcessCount = 0;
_cts = new CancellationTokenSource();
CancellationToken token = _cts.Token;
_loop = Task.Run(async () =>
{
while (!token.IsCancellationRequested)
{
Sample();
try { await Task.Delay(100, token); }
catch (TaskCanceledException) { return; }
}
}, token);
}
public void Stop()
{
Sample(); // one final reading, in case the peak landed late
_cts?.Cancel();
try { _loop?.Wait(2000); } catch { }
}
void Sample()
{
List<Entry> all = Snapshot();
if (all.Count == 0) return;
int self = Environment.ProcessId;
foreach (Entry e in all)
if (e.Pid == self) { _ourCreateTime = e.CreateTime; break; }
if (_ourCreateTime < 0) return;
_ours[self] = _ourCreateTime;
// Drop any claim whose pid now carries a different creation time: that
// pid was recycled and the process wearing it belongs to someone else.
var live = new Dictionary<int, long>(all.Count);
foreach (Entry e in all) live[e.Pid] = e.CreateTime;
var recycled = new List<int>();
foreach (KeyValuePair<int, long> claim in _ours)
{
long now;
if (live.TryGetValue(claim.Key, out now) && now != claim.Value)
recycled.Add(claim.Key);
}
foreach (int pid in recycled) _ours.Remove(pid);
// Grow the owned set until it stops growing: a child seen in this
// snapshot may itself be the parent of another process in it. Claims
// survive the process exiting, so a grandchild still counts once the
// child that launched it is gone.
bool added = true;
while (added)
{
added = false;
foreach (Entry e in all)
{
if (_ours.ContainsKey(e.Pid)) continue;
long parentClaim;
if (!_ours.TryGetValue(e.Ppid, out parentClaim)) continue;
// A parent only vouches for children started after it.
if (e.CreateTime < parentClaim) continue;
_ours[e.Pid] = e.CreateTime;
added = true;
}
}
long total = 0;
int count = 0;
foreach (Entry e in all)
{
long claim;
if (!_ours.TryGetValue(e.Pid, out claim) || claim != e.CreateTime) continue;
total += e.WorkingSet;
count++;
}
// Track the peak, not the average. The peak is what decides whether
// the container survives its busiest second.
if (total > PeakBytes) PeakBytes = total;
if (count > PeakProcessCount) PeakProcessCount = count;
}
readonly struct Entry
{
public readonly int Pid, Ppid;
public readonly long CreateTime, WorkingSet;
public Entry(int pid, int ppid, long create, long ws)
{
Pid = pid; Ppid = ppid; CreateTime = create; WorkingSet = ws;
}
}
// ---- one atomic system-wide process snapshot ---------------------------
// SYSTEM_PROCESS_INFORMATION, x64 field offsets: CreateTime 32,
// UniqueProcessId 80, InheritedFromUniqueProcessId 88, WorkingSetSize 144.
const int SystemProcessInformation = 5;
const uint STATUS_INFO_LENGTH_MISMATCH = 0xC0000004;
[DllImport("ntdll.dll")]
static extern uint NtQuerySystemInformation(int systemInformationClass,
IntPtr systemInformation, int systemInformationLength, out int returnLength);
static int _bufferSize = 1 << 20;
static List<Entry> Snapshot()
{
var list = new List<Entry>(400);
IntPtr buffer = IntPtr.Zero;
try
{
for (int attempt = 0; attempt < 8; attempt++)
{
if (buffer != IntPtr.Zero) Marshal.FreeHGlobal(buffer);
buffer = Marshal.AllocHGlobal(_bufferSize);
int needed;
uint status = NtQuerySystemInformation(
SystemProcessInformation, buffer, _bufferSize, out needed);
if (status == 0)
{
long offset = 0;
while (true)
{
IntPtr entry = buffer + (int)offset;
int next = Marshal.ReadInt32(entry, 0);
long create = Marshal.ReadInt64(entry, 32);
int pid = (int)Marshal.ReadIntPtr(entry, 80);
int ppid = (int)Marshal.ReadIntPtr(entry, 88);
long ws = (long)Marshal.ReadIntPtr(entry, 144);
if (pid != 0) list.Add(new Entry(pid, ppid, create, ws));
if (next == 0) break;
offset += next;
}
return list;
}
if (status != STATUS_INFO_LENGTH_MISMATCH) return list;
_bufferSize = Math.Max(needed + (64 * 1024), _bufferSize * 2);
}
}
catch { }
finally { if (buffer != IntPtr.Zero) Marshal.FreeHGlobal(buffer); }
return list;
}
}Imports System
Imports System.Collections.Generic
Imports System.Diagnostics
Imports System.Runtime.InteropServices
Imports System.Threading
Imports System.Threading.Tasks
' Samples the whole process tree, not just the .NET process.
'
' Several rendering libraries keep most of their memory in spawned browser
' processes, so measuring only the managed side flatters whichever engine
' spawns the most children. Two things have to be right for the reading to be
' fair, and both are easy to get wrong.
'
' First, attribution is by real ancestry rather than by process name. Matching
' a list of renderer names and counting anything that started after the
' benchmark did over-counts on any machine with a browser or an Electron
' application open: a library that spawns nothing reports several processes and
' a few hundred spare MB.
'
' Second, the tree and its memory are read from one system-wide snapshot.
' Asking the operating system about each process in turn cannot keep up with an
' engine that starts and exits renderers faster than the sample interval: the
' child is in the process list, and gone by the time its working set is read.
' NtQuerySystemInformation returns process id, parent id, creation time and
' working set for every process in a single call, so the shape of the tree and
' the memory in it come from the same instant.
NotInheritable Class TreeMemorySampler
' pid -> the creation time it had when it was claimed. Windows recycles
' process ids quickly and these engines churn through short-lived children,
' so a pid on its own is not an identity.
ReadOnly _ours As New Dictionary(Of Integer, Long)()
Private _ourCreateTime As Long = -1
Private _cts As CancellationTokenSource
Private _loop As Task
Public Property PeakBytes As Long
Get
Return _PeakBytes
End Get
Private Set(value As Long)
_PeakBytes = value
End Set
End Property
Private _PeakBytes As Long
Public Property PeakProcessCount As Integer
Get
Return _PeakProcessCount
End Get
Private Set(value As Integer)
_PeakProcessCount = value
End Set
End Property
Private _PeakProcessCount As Integer
Public Sub Start()
PeakBytes = 0
PeakProcessCount = 0
_cts = New CancellationTokenSource()
Dim token As CancellationToken = _cts.Token
_loop = Task.Run(Async Function()
While Not token.IsCancellationRequested
Sample()
Try
Await Task.Delay(100, token)
Catch ex As TaskCanceledException
Return
End Try
End While
End Function, token)
End Sub
Public Sub [Stop]()
Sample() ' one final reading, in case the peak landed late
_cts?.Cancel()
Try
_loop?.Wait(2000)
Catch
End Try
End Sub
Private Sub Sample()
Dim all As List(Of Entry) = Snapshot()
If all.Count = 0 Then Return
Dim self As Integer = Environment.ProcessId
For Each e As Entry In all
If e.Pid = self Then
_ourCreateTime = e.CreateTime
Exit For
End If
Next
If _ourCreateTime < 0 Then Return
_ours(self) = _ourCreateTime
' Drop any claim whose pid now carries a different creation time: that
' pid was recycled and the process wearing it belongs to someone else.
Dim live As New Dictionary(Of Integer, Long)(all.Count)
For Each e As Entry In all
live(e.Pid) = e.CreateTime
Next
Dim recycled As New List(Of Integer)()
For Each claim As KeyValuePair(Of Integer, Long) In _ours
Dim now As Long
If live.TryGetValue(claim.Key, now) AndAlso now <> claim.Value Then
recycled.Add(claim.Key)
End If
Next
For Each pid As Integer In recycled
_ours.Remove(pid)
Next
' Grow the owned set until it stops growing: a child seen in this
' snapshot may itself be the parent of another process in it. Claims
' survive the process exiting, so a grandchild still counts once the
' child that launched it is gone.
Dim added As Boolean = True
While added
added = False
For Each e As Entry In all
If _ours.ContainsKey(e.Pid) Then Continue For
Dim parentClaim As Long
If Not _ours.TryGetValue(e.Ppid, parentClaim) Then Continue For
' A parent only vouches for children started after it.
If e.CreateTime < parentClaim Then Continue For
_ours(e.Pid) = e.CreateTime
added = True
Next
End While
Dim total As Long = 0
Dim count As Integer = 0
For Each e As Entry In all
Dim claim As Long
If Not _ours.TryGetValue(e.Pid, claim) OrElse claim <> e.CreateTime Then Continue For
total += e.WorkingSet
count += 1
Next
' Track the peak, not the average. The peak is what decides whether
' the container survives its busiest second.
If total > PeakBytes Then PeakBytes = total
If count > PeakProcessCount Then PeakProcessCount = count
End Sub
Private Structure Entry
Public ReadOnly Pid, Ppid As Integer
Public ReadOnly CreateTime, WorkingSet As Long
Public Sub New(pid As Integer, ppid As Integer, create As Long, ws As Long)
Me.Pid = pid
Me.Ppid = ppid
Me.CreateTime = create
Me.WorkingSet = ws
End Sub
End Structure
' ---- one atomic system-wide process snapshot ---------------------------
' SYSTEM_PROCESS_INFORMATION, x64 field offsets: CreateTime 32,
' UniqueProcessId 80, InheritedFromUniqueProcessId 88, WorkingSetSize 144.
Const SystemProcessInformation As Integer = 5
Const STATUS_INFO_LENGTH_MISMATCH As UInteger = &HC0000004UI
<DllImport("ntdll.dll")>
Shared Function NtQuerySystemInformation(systemInformationClass As Integer, systemInformation As IntPtr, systemInformationLength As Integer, ByRef returnLength As Integer) As UInteger
End Function
Shared _bufferSize As Integer = 1 << 20
Shared Function Snapshot() As List(Of Entry)
Dim list As New List(Of Entry)(400)
Dim buffer As IntPtr = IntPtr.Zero
Try
For attempt As Integer = 0 To 7
If buffer <> IntPtr.Zero Then Marshal.FreeHGlobal(buffer)
buffer = Marshal.AllocHGlobal(_bufferSize)
Dim needed As Integer
Dim status As UInteger = NtQuerySystemInformation(SystemProcessInformation, buffer, _bufferSize, needed)
If status = 0 Then
Dim offset As Long = 0
While True
Dim entry As IntPtr = buffer + CInt(offset)
Dim next As Integer = Marshal.ReadInt32(entry, 0)
Dim create As Long = Marshal.ReadInt64(entry, 32)
Dim pid As Integer = CType(Marshal.ReadIntPtr(entry, 80), Integer)
Dim ppid As Integer = CType(Marshal.ReadIntPtr(entry, 88), Integer)
Dim ws As Long = CType(Marshal.ReadIntPtr(entry, 144), Long)
If pid <> 0 Then list.Add(New Entry(pid, ppid, create, ws))
If next = 0 Then Exit While
offset += next
End While
Return list
End If
If status <> STATUS_INFO_LENGTH_MISMATCH Then Return list
_bufferSize = Math.Max(needed + (64 * 1024), _bufferSize * 2)
Next
Catch
Finally
If buffer <> IntPtr.Zero Then Marshal.FreeHGlobal(buffer)
End Try
Return list
End Function
End ClassImports System
Imports System.Collections.Generic
Imports System.Diagnostics
Imports System.Runtime.InteropServices
Imports System.Threading
Imports System.Threading.Tasks
' Samples the whole process tree, not just the .NET process.
'
' Several rendering libraries keep most of their memory in spawned browser
' processes, so measuring only the managed side flatters whichever engine
' spawns the most children. Two things have to be right for the reading to be
' fair, and both are easy to get wrong.
'
' First, attribution is by real ancestry rather than by process name. Matching
' a list of renderer names and counting anything that started after the
' benchmark did over-counts on any machine with a browser or an Electron
' application open: a library that spawns nothing reports several processes and
' a few hundred spare MB.
'
' Second, the tree and its memory are read from one system-wide snapshot.
' Asking the operating system about each process in turn cannot keep up with an
' engine that starts and exits renderers faster than the sample interval: the
' child is in the process list, and gone by the time its working set is read.
' NtQuerySystemInformation returns process id, parent id, creation time and
' working set for every process in a single call, so the shape of the tree and
' the memory in it come from the same instant.
NotInheritable Class TreeMemorySampler
' pid -> the creation time it had when it was claimed. Windows recycles
' process ids quickly and these engines churn through short-lived children,
' so a pid on its own is not an identity.
ReadOnly _ours As New Dictionary(Of Integer, Long)()
Private _ourCreateTime As Long = -1
Private _cts As CancellationTokenSource
Private _loop As Task
Public Property PeakBytes As Long
Get
Return _PeakBytes
End Get
Private Set(value As Long)
_PeakBytes = value
End Set
End Property
Private _PeakBytes As Long
Public Property PeakProcessCount As Integer
Get
Return _PeakProcessCount
End Get
Private Set(value As Integer)
_PeakProcessCount = value
End Set
End Property
Private _PeakProcessCount As Integer
Public Sub Start()
PeakBytes = 0
PeakProcessCount = 0
_cts = New CancellationTokenSource()
Dim token As CancellationToken = _cts.Token
_loop = Task.Run(Async Function()
While Not token.IsCancellationRequested
Sample()
Try
Await Task.Delay(100, token)
Catch ex As TaskCanceledException
Return
End Try
End While
End Function, token)
End Sub
Public Sub [Stop]()
Sample() ' one final reading, in case the peak landed late
_cts?.Cancel()
Try
_loop?.Wait(2000)
Catch
End Try
End Sub
Private Sub Sample()
Dim all As List(Of Entry) = Snapshot()
If all.Count = 0 Then Return
Dim self As Integer = Environment.ProcessId
For Each e As Entry In all
If e.Pid = self Then
_ourCreateTime = e.CreateTime
Exit For
End If
Next
If _ourCreateTime < 0 Then Return
_ours(self) = _ourCreateTime
' Drop any claim whose pid now carries a different creation time: that
' pid was recycled and the process wearing it belongs to someone else.
Dim live As New Dictionary(Of Integer, Long)(all.Count)
For Each e As Entry In all
live(e.Pid) = e.CreateTime
Next
Dim recycled As New List(Of Integer)()
For Each claim As KeyValuePair(Of Integer, Long) In _ours
Dim now As Long
If live.TryGetValue(claim.Key, now) AndAlso now <> claim.Value Then
recycled.Add(claim.Key)
End If
Next
For Each pid As Integer In recycled
_ours.Remove(pid)
Next
' Grow the owned set until it stops growing: a child seen in this
' snapshot may itself be the parent of another process in it. Claims
' survive the process exiting, so a grandchild still counts once the
' child that launched it is gone.
Dim added As Boolean = True
While added
added = False
For Each e As Entry In all
If _ours.ContainsKey(e.Pid) Then Continue For
Dim parentClaim As Long
If Not _ours.TryGetValue(e.Ppid, parentClaim) Then Continue For
' A parent only vouches for children started after it.
If e.CreateTime < parentClaim Then Continue For
_ours(e.Pid) = e.CreateTime
added = True
Next
End While
Dim total As Long = 0
Dim count As Integer = 0
For Each e As Entry In all
Dim claim As Long
If Not _ours.TryGetValue(e.Pid, claim) OrElse claim <> e.CreateTime Then Continue For
total += e.WorkingSet
count += 1
Next
' Track the peak, not the average. The peak is what decides whether
' the container survives its busiest second.
If total > PeakBytes Then PeakBytes = total
If count > PeakProcessCount Then PeakProcessCount = count
End Sub
Private Structure Entry
Public ReadOnly Pid, Ppid As Integer
Public ReadOnly CreateTime, WorkingSet As Long
Public Sub New(pid As Integer, ppid As Integer, create As Long, ws As Long)
Me.Pid = pid
Me.Ppid = ppid
Me.CreateTime = create
Me.WorkingSet = ws
End Sub
End Structure
' ---- one atomic system-wide process snapshot ---------------------------
' SYSTEM_PROCESS_INFORMATION, x64 field offsets: CreateTime 32,
' UniqueProcessId 80, InheritedFromUniqueProcessId 88, WorkingSetSize 144.
Const SystemProcessInformation As Integer = 5
Const STATUS_INFO_LENGTH_MISMATCH As UInteger = &HC0000004UI
<DllImport("ntdll.dll")>
Shared Function NtQuerySystemInformation(systemInformationClass As Integer, systemInformation As IntPtr, systemInformationLength As Integer, ByRef returnLength As Integer) As UInteger
End Function
Shared _bufferSize As Integer = 1 << 20
Shared Function Snapshot() As List(Of Entry)
Dim list As New List(Of Entry)(400)
Dim buffer As IntPtr = IntPtr.Zero
Try
For attempt As Integer = 0 To 7
If buffer <> IntPtr.Zero Then Marshal.FreeHGlobal(buffer)
buffer = Marshal.AllocHGlobal(_bufferSize)
Dim needed As Integer
Dim status As UInteger = NtQuerySystemInformation(SystemProcessInformation, buffer, _bufferSize, needed)
If status = 0 Then
Dim offset As Long = 0
While True
Dim entry As IntPtr = buffer + CInt(offset)
Dim next As Integer = Marshal.ReadInt32(entry, 0)
Dim create As Long = Marshal.ReadInt64(entry, 32)
Dim pid As Integer = CType(Marshal.ReadIntPtr(entry, 80), Integer)
Dim ppid As Integer = CType(Marshal.ReadIntPtr(entry, 88), Integer)
Dim ws As Long = CType(Marshal.ReadIntPtr(entry, 144), Long)
If pid <> 0 Then list.Add(New Entry(pid, ppid, create, ws))
If next = 0 Then Exit While
offset += next
End While
Return list
End If
If status <> STATUS_INFO_LENGTH_MISMATCH Then Return list
_bufferSize = Math.Max(needed + (64 * 1024), _bufferSize * 2)
Next
Catch
Finally
If buffer <> IntPtr.Zero Then Marshal.FreeHGlobal(buffer)
End Try
Return list
End Function
End Classusing System;
using System.IO;
using System.Threading.Tasks;
using IronPdf;
using PuppeteerSharp.Media;
using PW = Microsoft.Playwright;
using PS = PuppeteerSharp;
using iText.Html2pdf;
// One interface so a single sweep loop drives every engine. Anyone reading your
// results will check these adapters, so the fairness decisions belong here and
// should be stated alongside the numbers.
interface IEngine
{
string Version { get; }
Task InitAsync();
Task<byte[]> RenderAsync(string html);
Task DisposeAsync();
}
static class Engines
{
public static readonly string[] All =
{ "ironpdf", "puppeteersharp", "playwright", "itext-pdfhtml" };
public static IEngine Create(string id) => id switch
{
"ironpdf" => new IronPdfEngine(),
"puppeteersharp" => new PuppeteerEngine(),
"playwright" => new PlaywrightEngine(),
"itext-pdfhtml" => new ITextEngine(),
_ => throw new ArgumentException("unknown engine: " + id)
};
}
// One renderer instance, reused across every render. ChromePdfRenderer is
// thread-safe and stateless per render, so this is both the documented pattern
// and what a real service would do.
sealed class IronPdfEngine : IEngine
{
ChromePdfRenderer _renderer;
public string Version => typeof(ChromePdfRenderer).Assembly.GetName().Version?.ToString();
public Task InitAsync()
{
_renderer = new ChromePdfRenderer();
_renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4;
_renderer.RenderingOptions.PrintHtmlBackgrounds = true;
_renderer.RenderingOptions.CssMediaType = IronPdf.Rendering.PdfCssMediaType.Print;
return Task.CompletedTask;
}
public async Task<byte[]> RenderAsync(string html)
{
using PdfDocument pdf = await _renderer.RenderHtmlAsPdfAsync(html);
return pdf.BinaryData;
}
public Task DisposeAsync() => Task.CompletedTask;
}
// One browser, a fresh page per render. Page-per-render is what the Puppeteer
// documentation recommends and it is the cheaper of the two options, so it is
// the favourable choice here rather than the convenient one.
sealed class PuppeteerEngine : IEngine
{
PS.IBrowser _browser;
public string Version => typeof(PS.Puppeteer).Assembly.GetName().Version?.ToString();
public async Task InitAsync()
{
await new PS.BrowserFetcher().DownloadAsync();
_browser = await PS.Puppeteer.LaunchAsync(new PS.LaunchOptions { Headless = true });
}
public async Task<byte[]> RenderAsync(string html)
{
await using PS.IPage page = await _browser.NewPageAsync();
// Load, not networkidle. PuppeteerSharp deprecated the networkidle
// conditions for SetContent, and every engine here is given the same
// wait condition so the comparison stays like for like.
await page.SetContentAsync(html, new PS.SetContentOptions
{
WaitUntil = new[] { PS.WaitUntilNavigation.Load }
});
return await page.PdfDataAsync(new PS.PdfOptions
{
Format = PaperFormat.A4,
PrintBackground = true
});
}
public async Task DisposeAsync()
{
if (_browser != null) await _browser.CloseAsync();
}
}
sealed class PlaywrightEngine : IEngine
{
PW.IPlaywright _playwright;
PW.IBrowser _browser;
public string Version => typeof(PW.Playwright).Assembly.GetName().Version?.ToString();
public async Task InitAsync()
{
Microsoft.Playwright.Program.Main(new[] { "install", "chromium" });
_playwright = await PW.Playwright.CreateAsync();
_browser = await _playwright.Chromium.LaunchAsync(
new PW.BrowserTypeLaunchOptions { Headless = true });
}
public async Task<byte[]> RenderAsync(string html)
{
PW.IPage page = await _browser.NewPageAsync();
try
{
await page.SetContentAsync(html, new PW.PageSetContentOptions
{
WaitUntil = PW.WaitUntilState.Load
});
return await page.PdfAsync(new PW.PagePdfOptions
{
Format = "A4",
PrintBackground = true
});
}
finally { await page.CloseAsync(); }
}
public async Task DisposeAsync()
{
if (_browser != null) await _browser.CloseAsync();
_playwright?.Dispose();
}
}
// No browser and no JavaScript engine. It is in the benchmark as the control
// that shows what the browser engines are paying for - and what they buy.
sealed class ITextEngine : IEngine
{
// pdfHTML and iText Core ship as separate packages on independent version
// lines, so report both: pdfHTML 6.x is the add-on that runs on Core 9.x.
public string Version =>
typeof(HtmlConverter).Assembly.GetName().Version?.ToString() + "+core" +
typeof(iText.Kernel.Pdf.PdfDocument).Assembly.GetName().Version?.ToString();
public Task InitAsync() => Task.CompletedTask;
public Task<byte[]> RenderAsync(string html) => Task.Run(() =>
{
using var stream = new MemoryStream();
HtmlConverter.ConvertToPdf(html, stream);
return stream.ToArray();
});
public Task DisposeAsync() => Task.CompletedTask;
}using System;
using System.IO;
using System.Threading.Tasks;
using IronPdf;
using PuppeteerSharp.Media;
using PW = Microsoft.Playwright;
using PS = PuppeteerSharp;
using iText.Html2pdf;
// One interface so a single sweep loop drives every engine. Anyone reading your
// results will check these adapters, so the fairness decisions belong here and
// should be stated alongside the numbers.
interface IEngine
{
string Version { get; }
Task InitAsync();
Task<byte[]> RenderAsync(string html);
Task DisposeAsync();
}
static class Engines
{
public static readonly string[] All =
{ "ironpdf", "puppeteersharp", "playwright", "itext-pdfhtml" };
public static IEngine Create(string id) => id switch
{
"ironpdf" => new IronPdfEngine(),
"puppeteersharp" => new PuppeteerEngine(),
"playwright" => new PlaywrightEngine(),
"itext-pdfhtml" => new ITextEngine(),
_ => throw new ArgumentException("unknown engine: " + id)
};
}
// One renderer instance, reused across every render. ChromePdfRenderer is
// thread-safe and stateless per render, so this is both the documented pattern
// and what a real service would do.
sealed class IronPdfEngine : IEngine
{
ChromePdfRenderer _renderer;
public string Version => typeof(ChromePdfRenderer).Assembly.GetName().Version?.ToString();
public Task InitAsync()
{
_renderer = new ChromePdfRenderer();
_renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4;
_renderer.RenderingOptions.PrintHtmlBackgrounds = true;
_renderer.RenderingOptions.CssMediaType = IronPdf.Rendering.PdfCssMediaType.Print;
return Task.CompletedTask;
}
public async Task<byte[]> RenderAsync(string html)
{
using PdfDocument pdf = await _renderer.RenderHtmlAsPdfAsync(html);
return pdf.BinaryData;
}
public Task DisposeAsync() => Task.CompletedTask;
}
// One browser, a fresh page per render. Page-per-render is what the Puppeteer
// documentation recommends and it is the cheaper of the two options, so it is
// the favourable choice here rather than the convenient one.
sealed class PuppeteerEngine : IEngine
{
PS.IBrowser _browser;
public string Version => typeof(PS.Puppeteer).Assembly.GetName().Version?.ToString();
public async Task InitAsync()
{
await new PS.BrowserFetcher().DownloadAsync();
_browser = await PS.Puppeteer.LaunchAsync(new PS.LaunchOptions { Headless = true });
}
public async Task<byte[]> RenderAsync(string html)
{
await using PS.IPage page = await _browser.NewPageAsync();
// Load, not networkidle. PuppeteerSharp deprecated the networkidle
// conditions for SetContent, and every engine here is given the same
// wait condition so the comparison stays like for like.
await page.SetContentAsync(html, new PS.SetContentOptions
{
WaitUntil = new[] { PS.WaitUntilNavigation.Load }
});
return await page.PdfDataAsync(new PS.PdfOptions
{
Format = PaperFormat.A4,
PrintBackground = true
});
}
public async Task DisposeAsync()
{
if (_browser != null) await _browser.CloseAsync();
}
}
sealed class PlaywrightEngine : IEngine
{
PW.IPlaywright _playwright;
PW.IBrowser _browser;
public string Version => typeof(PW.Playwright).Assembly.GetName().Version?.ToString();
public async Task InitAsync()
{
Microsoft.Playwright.Program.Main(new[] { "install", "chromium" });
_playwright = await PW.Playwright.CreateAsync();
_browser = await _playwright.Chromium.LaunchAsync(
new PW.BrowserTypeLaunchOptions { Headless = true });
}
public async Task<byte[]> RenderAsync(string html)
{
PW.IPage page = await _browser.NewPageAsync();
try
{
await page.SetContentAsync(html, new PW.PageSetContentOptions
{
WaitUntil = PW.WaitUntilState.Load
});
return await page.PdfAsync(new PW.PagePdfOptions
{
Format = "A4",
PrintBackground = true
});
}
finally { await page.CloseAsync(); }
}
public async Task DisposeAsync()
{
if (_browser != null) await _browser.CloseAsync();
_playwright?.Dispose();
}
}
// No browser and no JavaScript engine. It is in the benchmark as the control
// that shows what the browser engines are paying for - and what they buy.
sealed class ITextEngine : IEngine
{
// pdfHTML and iText Core ship as separate packages on independent version
// lines, so report both: pdfHTML 6.x is the add-on that runs on Core 9.x.
public string Version =>
typeof(HtmlConverter).Assembly.GetName().Version?.ToString() + "+core" +
typeof(iText.Kernel.Pdf.PdfDocument).Assembly.GetName().Version?.ToString();
public Task InitAsync() => Task.CompletedTask;
public Task<byte[]> RenderAsync(string html) => Task.Run(() =>
{
using var stream = new MemoryStream();
HtmlConverter.ConvertToPdf(html, stream);
return stream.ToArray();
});
public Task DisposeAsync() => Task.CompletedTask;
}Imports System
Imports System.IO
Imports System.Threading.Tasks
Imports IronPdf
Imports PuppeteerSharp.Media
Imports PW = Microsoft.Playwright
Imports PS = PuppeteerSharp
Imports iText.Html2pdf
' One interface so a single sweep loop drives every engine. Anyone reading your
' results will check these adapters, so the fairness decisions belong here and
' should be stated alongside the numbers.
Interface IEngine
ReadOnly Property Version As String
Function InitAsync() As Task
Function RenderAsync(html As String) As Task(Of Byte())
Function DisposeAsync() As Task
End Interface
Module Engines
Public ReadOnly All As String() = {"ironpdf", "puppeteersharp", "playwright", "itext-pdfhtml"}
Public Function Create(id As String) As IEngine
Select Case id
Case "ironpdf"
Return New IronPdfEngine()
Case "puppeteersharp"
Return New PuppeteerEngine()
Case "playwright"
Return New PlaywrightEngine()
Case "itext-pdfhtml"
Return New ITextEngine()
Case Else
Throw New ArgumentException("unknown engine: " & id)
End Select
End Function
End Module
' One renderer instance, reused across every render. ChromePdfRenderer is
' thread-safe and stateless per render, so this is both the documented pattern
' and what a real service would do.
NotInheritable Class IronPdfEngine
Implements IEngine
Private _renderer As ChromePdfRenderer
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(ChromePdfRenderer).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Function InitAsync() As Task Implements IEngine.InitAsync
_renderer = New ChromePdfRenderer()
_renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4
_renderer.RenderingOptions.PrintHtmlBackgrounds = True
_renderer.RenderingOptions.CssMediaType = IronPdf.Rendering.PdfCssMediaType.Print
Return Task.CompletedTask
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Using pdf As PdfDocument = Await _renderer.RenderHtmlAsPdfAsync(html)
Return pdf.BinaryData
End Using
End Function
Public Function DisposeAsync() As Task Implements IEngine.DisposeAsync
Return Task.CompletedTask
End Function
End Class
' One browser, a fresh page per render. Page-per-render is what the Puppeteer
' documentation recommends and it is the cheaper of the two options, so it is
' the favourable choice here rather than the convenient one.
NotInheritable Class PuppeteerEngine
Implements IEngine
Private _browser As PS.IBrowser
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(PS.Puppeteer).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Async Function InitAsync() As Task Implements IEngine.InitAsync
Await New PS.BrowserFetcher().DownloadAsync()
_browser = Await PS.Puppeteer.LaunchAsync(New PS.LaunchOptions With {.Headless = True})
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Await Using page As PS.IPage = Await _browser.NewPageAsync()
' Load, not networkidle. PuppeteerSharp deprecated the networkidle
' conditions for SetContent, and every engine here is given the same
' wait condition so the comparison stays like for like.
Await page.SetContentAsync(html, New PS.SetContentOptions With {
.WaitUntil = {PS.WaitUntilNavigation.Load}
})
Return Await page.PdfDataAsync(New PS.PdfOptions With {
.Format = PaperFormat.A4,
.PrintBackground = True
})
End Using
End Function
Public Async Function DisposeAsync() As Task Implements IEngine.DisposeAsync
If _browser IsNot Nothing Then Await _browser.CloseAsync()
End Function
End Class
NotInheritable Class PlaywrightEngine
Implements IEngine
Private _playwright As PW.IPlaywright
Private _browser As PW.IBrowser
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(PW.Playwright).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Async Function InitAsync() As Task Implements IEngine.InitAsync
Microsoft.Playwright.Program.Main({"install", "chromium"})
_playwright = Await PW.Playwright.CreateAsync()
_browser = Await _playwright.Chromium.LaunchAsync(New PW.BrowserTypeLaunchOptions With {.Headless = True})
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Dim page As PW.IPage = Await _browser.NewPageAsync()
Try
Await page.SetContentAsync(html, New PW.PageSetContentOptions With {
.WaitUntil = PW.WaitUntilState.Load
})
Return Await page.PdfAsync(New PW.PagePdfOptions With {
.Format = "A4",
.PrintBackground = True
})
Finally
Await page.CloseAsync()
End Try
End Function
Public Async Function DisposeAsync() As Task Implements IEngine.DisposeAsync
If _browser IsNot Nothing Then Await _browser.CloseAsync()
_playwright?.Dispose()
End Function
End Class
' No browser and no JavaScript engine. It is in the benchmark as the control
' that shows what the browser engines are paying for - and what they buy.
NotInheritable Class ITextEngine
Implements IEngine
' pdfHTML and iText Core ship as separate packages on independent version
' lines, so report both: pdfHTML 6.x is the add-on that runs on Core 9.x.
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(HtmlConverter).Assembly.GetName().Version?.ToString() & "+core" &
GetType(iText.Kernel.Pdf.PdfDocument).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Function InitAsync() As Task Implements IEngine.InitAsync
Return Task.CompletedTask
End Function
Public Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Return Task.Run(Function()
Using stream As New MemoryStream()
HtmlConverter.ConvertToPdf(html, stream)
Return stream.ToArray()
End Using
End Function)
End Function
Public Function DisposeAsync() As Task Implements IEngine.DisposeAsync
Return Task.CompletedTask
End Function
End ClassImports System
Imports System.IO
Imports System.Threading.Tasks
Imports IronPdf
Imports PuppeteerSharp.Media
Imports PW = Microsoft.Playwright
Imports PS = PuppeteerSharp
Imports iText.Html2pdf
' One interface so a single sweep loop drives every engine. Anyone reading your
' results will check these adapters, so the fairness decisions belong here and
' should be stated alongside the numbers.
Interface IEngine
ReadOnly Property Version As String
Function InitAsync() As Task
Function RenderAsync(html As String) As Task(Of Byte())
Function DisposeAsync() As Task
End Interface
Module Engines
Public ReadOnly All As String() = {"ironpdf", "puppeteersharp", "playwright", "itext-pdfhtml"}
Public Function Create(id As String) As IEngine
Select Case id
Case "ironpdf"
Return New IronPdfEngine()
Case "puppeteersharp"
Return New PuppeteerEngine()
Case "playwright"
Return New PlaywrightEngine()
Case "itext-pdfhtml"
Return New ITextEngine()
Case Else
Throw New ArgumentException("unknown engine: " & id)
End Select
End Function
End Module
' One renderer instance, reused across every render. ChromePdfRenderer is
' thread-safe and stateless per render, so this is both the documented pattern
' and what a real service would do.
NotInheritable Class IronPdfEngine
Implements IEngine
Private _renderer As ChromePdfRenderer
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(ChromePdfRenderer).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Function InitAsync() As Task Implements IEngine.InitAsync
_renderer = New ChromePdfRenderer()
_renderer.RenderingOptions.PaperSize = IronPdf.Rendering.PdfPaperSize.A4
_renderer.RenderingOptions.PrintHtmlBackgrounds = True
_renderer.RenderingOptions.CssMediaType = IronPdf.Rendering.PdfCssMediaType.Print
Return Task.CompletedTask
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Using pdf As PdfDocument = Await _renderer.RenderHtmlAsPdfAsync(html)
Return pdf.BinaryData
End Using
End Function
Public Function DisposeAsync() As Task Implements IEngine.DisposeAsync
Return Task.CompletedTask
End Function
End Class
' One browser, a fresh page per render. Page-per-render is what the Puppeteer
' documentation recommends and it is the cheaper of the two options, so it is
' the favourable choice here rather than the convenient one.
NotInheritable Class PuppeteerEngine
Implements IEngine
Private _browser As PS.IBrowser
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(PS.Puppeteer).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Async Function InitAsync() As Task Implements IEngine.InitAsync
Await New PS.BrowserFetcher().DownloadAsync()
_browser = Await PS.Puppeteer.LaunchAsync(New PS.LaunchOptions With {.Headless = True})
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Await Using page As PS.IPage = Await _browser.NewPageAsync()
' Load, not networkidle. PuppeteerSharp deprecated the networkidle
' conditions for SetContent, and every engine here is given the same
' wait condition so the comparison stays like for like.
Await page.SetContentAsync(html, New PS.SetContentOptions With {
.WaitUntil = {PS.WaitUntilNavigation.Load}
})
Return Await page.PdfDataAsync(New PS.PdfOptions With {
.Format = PaperFormat.A4,
.PrintBackground = True
})
End Using
End Function
Public Async Function DisposeAsync() As Task Implements IEngine.DisposeAsync
If _browser IsNot Nothing Then Await _browser.CloseAsync()
End Function
End Class
NotInheritable Class PlaywrightEngine
Implements IEngine
Private _playwright As PW.IPlaywright
Private _browser As PW.IBrowser
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(PW.Playwright).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Async Function InitAsync() As Task Implements IEngine.InitAsync
Microsoft.Playwright.Program.Main({"install", "chromium"})
_playwright = Await PW.Playwright.CreateAsync()
_browser = Await _playwright.Chromium.LaunchAsync(New PW.BrowserTypeLaunchOptions With {.Headless = True})
End Function
Public Async Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Dim page As PW.IPage = Await _browser.NewPageAsync()
Try
Await page.SetContentAsync(html, New PW.PageSetContentOptions With {
.WaitUntil = PW.WaitUntilState.Load
})
Return Await page.PdfAsync(New PW.PagePdfOptions With {
.Format = "A4",
.PrintBackground = True
})
Finally
Await page.CloseAsync()
End Try
End Function
Public Async Function DisposeAsync() As Task Implements IEngine.DisposeAsync
If _browser IsNot Nothing Then Await _browser.CloseAsync()
_playwright?.Dispose()
End Function
End Class
' No browser and no JavaScript engine. It is in the benchmark as the control
' that shows what the browser engines are paying for - and what they buy.
NotInheritable Class ITextEngine
Implements IEngine
' pdfHTML and iText Core ship as separate packages on independent version
' lines, so report both: pdfHTML 6.x is the add-on that runs on Core 9.x.
Public ReadOnly Property Version As String Implements IEngine.Version
Get
Return GetType(HtmlConverter).Assembly.GetName().Version?.ToString() & "+core" &
GetType(iText.Kernel.Pdf.PdfDocument).Assembly.GetName().Version?.ToString()
End Get
End Property
Public Function InitAsync() As Task Implements IEngine.InitAsync
Return Task.CompletedTask
End Function
Public Function RenderAsync(html As String) As Task(Of Byte()) Implements IEngine.RenderAsync
Return Task.Run(Function()
Using stream As New MemoryStream()
HtmlConverter.ConvertToPdf(html, stream)
Return stream.ToArray()
End Using
End Function)
End Function
Public Function DisposeAsync() As Task Implements IEngine.DisposeAsync
Return Task.CompletedTask
End Function
End Classこの表は、8,960回のタイムレンダリング、7つのエンジン、4つの同時実行レベルで各64回のレンダリングを行い、5回の完全なパスを繰り返し、105回のコールドスタートプロセスの起動と共に行われたものです。公開されたすべての数値は、その5回のパスの中央値です。
| ライブラリ | 最も遅いパス | 中央値 | 最も速いパス | スプレッド |
|---|---|---|---|---|
| wkhtmltopdf | 15.98/s | 16.03/s | 16.85/s | 5.5% |
| IronPDF | 40.71/s | 44.02/s | 44.31/s | 8.8% |
| iText 9 pdfHTML | 51.93/s | 54.30/s | 56.87/s | 9.5% |
| PuppeteerSharp | 14.74/s | 15.60/s | 16.21/s | 10.0% |
| Aspose.HTML | 32.31/s | 33.98/s | 35.71/s | 10.5% |
| Playwright .NET | 20.23/s | 20.68/s | 22.38/s | 10.6% |
| HtmlRenderer + PdfSharp | 290.68/s | 327.09/s | 429.45/s | 47.7% |
テスト環境: 24コア / 32スレッド x64 デスクトップ CPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
8つの同時レンダリングでのスループットは、5回のパスで5.5%から47.7%まで変動しました。スプレッドは、最も速く終了するエンジンで最も広く、短いレンダリングの中で数ミリ秒のスケジューリングノイズが大きな割合を占め、最も遅いエンジンではそうではありません。HtmlRendererは23 msでレンダリングを完了し、47.7%の変動があります。wkhtmltopdfは486 msかかり、5.5%の変動があります。ドキュメントを正しくレンダリングしたすべてのエンジンは、11%以内に収まりました。
パスは他のアプリケーションがコアを競合しない、アイドル状態のマシンで実行されました。それは思った以上に重要です。同じデスクトップで通常のアプリケーションが実行されている間に行われた同じ5つのパスの以前のキャンペーンでは、7つのエンジンのうち6つでスループットが3%から21%低下し、PuppeteerSharpとIronPDFが最も影響を受けました。例外はHtmlRendererで、レンダリングを数十ミリ秒で完了し、忙しいマシンで3%高くなりました。これは、単一の高速測定がどれほど少ないことを示しています。エンジンの順序は両方のキャンペーンで同一であり、その順序が他のハードウェアに転送されます。絶対的な速度はこのマシンに特有であり、他には適用されません。
これは、デプロイ後の最初のリクエストが支払うレイテンシーです。ほとんどのデモンストレーションがウォームアップされたプロセスを使用するため、公開されることはまれです。
| ライブラリ | 最初のPDF、3回のうち最良 | コールドスタート中のピーク |
|---|---|---|
| HtmlRenderer + PdfSharp | 157 ms | 128 MB |
| wkhtmltopdf | 424 ms | 116 MB |
| IronPDF | 486 ms | 342 MB |
| iText 9 pdfHTML | 489 ms | 130 MB |
| PuppeteerSharp | 639 ms | 539 MB |
| Playwright .NET | 720 ms | 411 MB |
| Aspose.HTML | 1,096 ms | 162 MB |
テスト環境: 24コア / 32スレッド x64 デスクトップCPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
IronPDFは、ここでドキュメントを再現したすべての中で最初のPDFを生成するのが最も速く、486 msでPuppeteerSharpの639 msやPlaywrightの720 msに対して優れています。また、Aspose.HTMLの1,096 msを大きく上回っています。これは、埋め込まれたChromiumが半秒で最初のPDFを生成するのに対し、外部ブラウザを起動して接続する必要がある2つのエンジンに対するものです。
表の上記2つのエンジンは、開始するための最新のブラウザを持っていません。HtmlRendererにはそのようなレンダリングエンジンがまったくなく、157 msで最初のPDFに到達します。wkhtmltopdfは現在のChromiumよりもはるかに軽いQtWebKit 5.212をロードし、424 msかかります。どちらもIronPDFの342 MBに対して約120 MBで、iText 9はIronPDFの3 ms後ろの489 msで、130 MBです。このメモリの差はブラウザを持ち運ぶコストであり、それはブラウザが提供するものによって制約されます。同じ半秒で、3つすべての請求書に0.00の合計があり、チャートはありませんでしたので、読み取りは同じ操作を計時していません。
4つの同時実行レベルにわたる定常状態。
| ライブラリ | 同時実行数 | スループット | p50 | p95 | ピークプロセスツリー | プロセス数 |
|---|---|---|---|---|---|---|
| IronPDF | 1 | 9.22/s | 96 ms | 181 ms | 750 MB | 6 |
| IronPDF | 4 | 31.49/s | 121 ms | 149 ms | 850 MB | 10 |
| IronPDF | 8 | 44.02/s | 161 ms | 269 ms | 1,187 MB | 15 |
| IronPDF | 16 | 40.16/s | 364 ms | 511 ms | 1,770 MB | 28 |
| Playwright .NET | 1 | 5.93/s | 167 ms | 179 ms | 511 MB | 8 |
| Playwright .NET | 4 | 16.91/s | 234 ms | 255 ms | 750 MB | 11 |
| Playwright .NET | 8 | 20.68/s | 381 ms | 426 ms | 1,122 MB | 15 |
| Playwright .NET | 16 | 21.31/s | 724 ms | 870 ms | 1,808 MB | 23 |
| PuppeteerSharp | 1 | 4.85/s | 204 ms | 224 ms | 584 MB | 11 |
| PuppeteerSharp | 4 | 11.85/s | 339 ms | 383 ms | 890 MB | 16 |
| PuppeteerSharp | 8 | 15.60/s | 507 ms | 597 ms | 1,293 MB | 24 |
| PuppeteerSharp | 16 | 15.68/s | 997 ms | 1,147 ms | 2,094 MB | 40 |
| iText 9 pdfHTML | 1 | 12.69/s | 53 ms | 220 ms | 174 MB | 1 |
| iText 9 pdfHTML | 4 | 45.69/s | 84 ms | 111 ms | 264 MB | 1 |
| iText 9 pdfHTML | 8 | 54.30/s | 144 ms | 178 ms | 332 MB | 1 |
| iText 9 pdfHTML | 16 | 58.53/s | 268 ms | 315 ms | 535 MB | 1 |
| HtmlRenderer + PdfSharp | 1 | 143.08/s | 7 ms | 8 ms | 153 MB | 1 |
| HtmlRenderer + PdfSharp | 4 | 366.96/s | 11 ms | 14 ms | 157 MB | 1 |
| HtmlRenderer + PdfSharp | 8 | 327.09/s | 23 ms | 35 ms | 166 MB | 1 |
| HtmlRenderer + PdfSharp | 16 | 309.92/s | 48 ms | 67 ms | 181 MB | 1 |
| wkhtmltopdf | 1 | 2.34/s | 422 ms | 478 ms | 147 MB | 3 |
| wkhtmltopdf | 4 | 8.97/s | 443 ms | 484 ms | 293 MB | 10 |
| wkhtmltopdf | 8 | 16.03/s | 486 ms | 526 ms | 482 MB | 18 |
| wkhtmltopdf | 16 | 24.09/s | 635 ms | 743 ms | 827 MB | 34 |
| Aspose.HTML | 1 | 10.37/s | 80 ms | 181 ms | 235 MB | 1 |
| Aspose.HTML | 4 | 33.48/s | 119 ms | 144 ms | 293 MB | 1 |
| Aspose.HTML | 8 | 33.98/s | 227 ms | 299 ms | 334 MB | 1 |
| Aspose.HTML | 16 | 33.37/s | 469 ms | 581 ms | 398 MB | 1 |
テスト環境: 24コア / 32スレッド x64 デスクトップ CPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
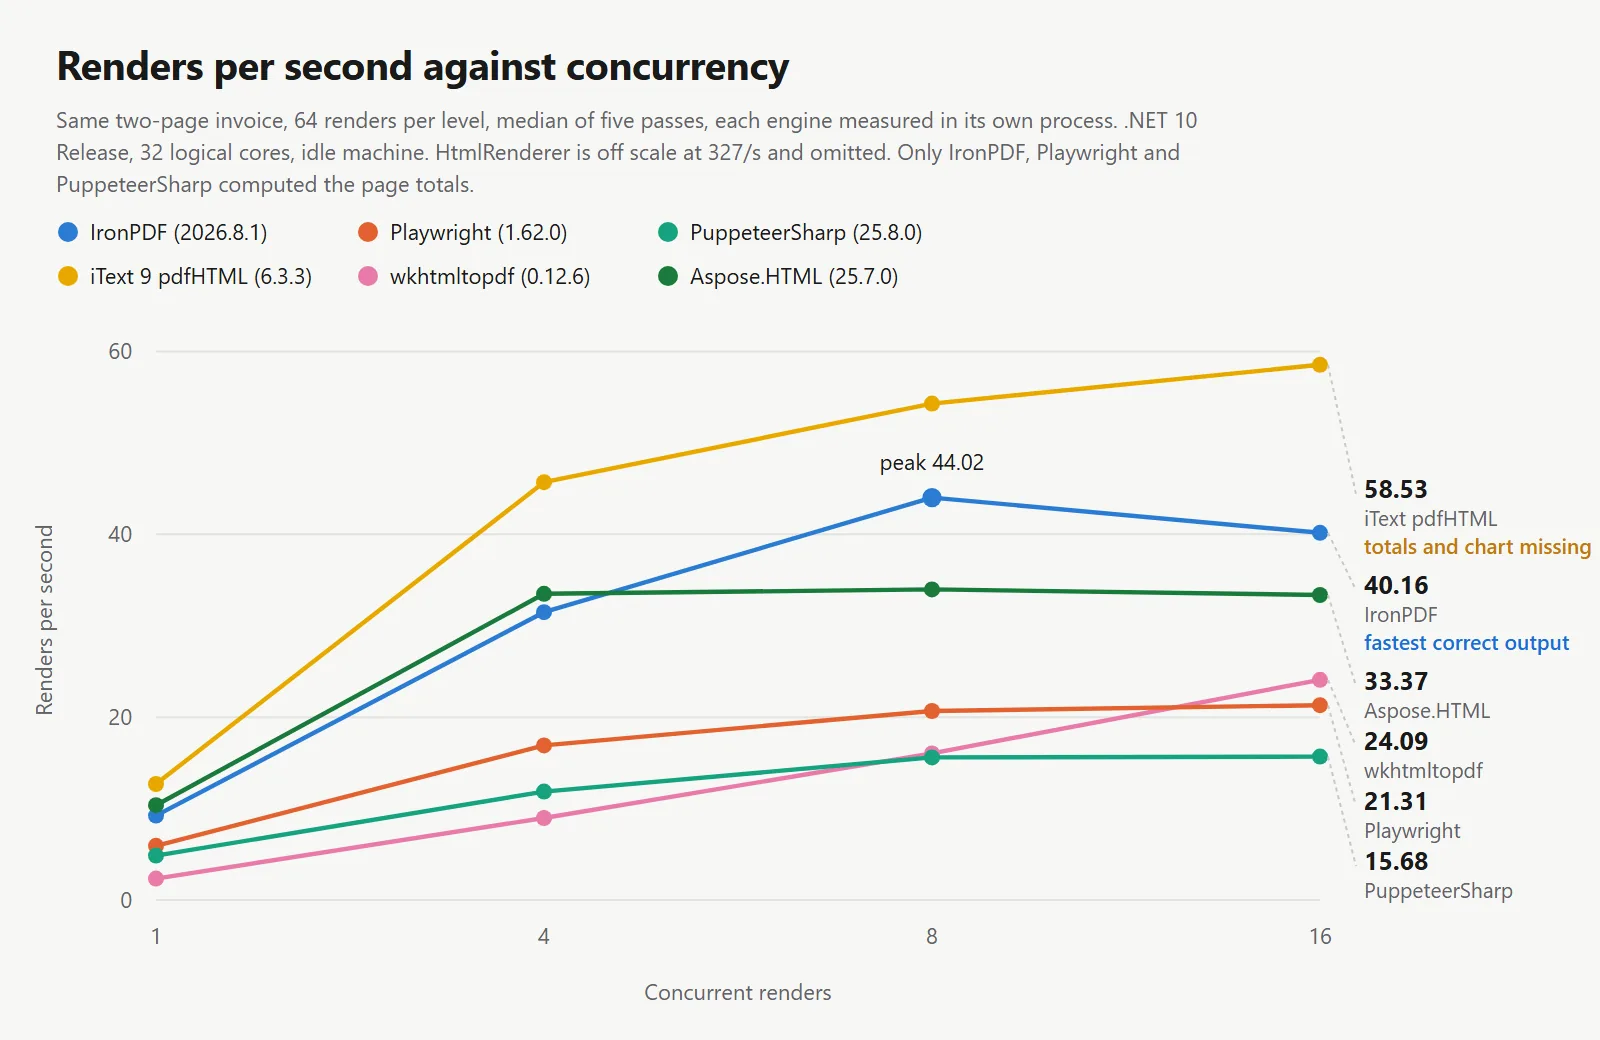
ドキュメントを正しくレンダリングしたエンジンの中で、IronPDFはすべてのテストされた同時実行レベルでリードし、負荷が高まるにつれてその優位性が増しました。同時実行1では、3つの正しいレンダラーは4.85から9.22レンダー毎秒の範囲で、1.9倍の差があります。同時実行8では、15.60から44.02の範囲で、2.8倍の差があります。このギャップは負荷が増すにつれて広がり、これはホストしていないブラウザを通じてすべてのページを移動させなければならない2つのエンジンとインプロセスエンジンを分けるものです。
ほとんどのエンジンには膝があり、それを超えるとスループットが上昇せず、遅延のみが増加します。IronPDFの膝は8で、44.02/sが16で40.16/sになり、p50が161 msから364 msに上昇するため、8で保持するセマフォは追加の遅延を支払うことなくスループットを維持します。PuppeteerSharpは8以降で平坦化し、15.60/sから15.68/sに変わりませんが、p50は507 msから997 msに40プロセスで上昇し、これは何も得られない遅延です。Aspose.HTMLはさらに早く平坦化し、4から16の間で何も得られません。HtmlRendererはすべての中で最も早く4で変わり、これは単一プロセスライブラリが1つのコアでスケジュールできる作業を超えたときに行うことです。iText 9、Playwright、wkhtmltopdfはすべて16でまだ増加しており、テスト範囲内で膝に達していませんが、Playwrightの21.31/sはIronPDFが4で維持したものを下回っています。
同時実行による単一レンダーのタイミングを外挿すると、実際のスループットを一貫して過大評価し、その程度はエンジンによって異なります。同時実行8では、IronPDFは外挿されたスループットの60%を達成し、iTextは53%、Playwrightは44%、PuppeteerSharpは40%です。
スイープテーブルと同じピークを、1つのライブラリが列を下に読み取るように配置しています。これらの値はコンテナサイズを設定します。
| ライブラリ | ピーク 1 | ピーク 4 | ピーク 8 | ピーク 16 | 持続的なレンダリング/sあたりのMB (8) | 正しくレンダリングされた |
|---|---|---|---|---|---|---|
| IronPDF | 750 MB | 850 MB | 1,187 MB | 1,770 MB | 27.0 | はい |
| Playwright .NET | 511 MB | 750 MB | 1,122 MB | 1,808 MB | 54.3 | はい |
| PuppeteerSharp | 584 MB | 890 MB | 1,293 MB | 2,094 MB | 82.9 | はい |
| iText 9 pdfHTML | 174 MB | 264 MB | 332 MB | 535 MB | 6.1 | いいえ |
| HtmlRenderer + PdfSharp | 153 MB | 157 MB | 166 MB | 181 MB | 0.5 | いいえ |
| wkhtmltopdf | 147 MB | 293 MB | 482 MB | 827 MB | 30.1 | いいえ |
| Aspose.HTML | 235 MB | 293 MB | 334 MB | 398 MB | 9.8 | いいえ |
テスト環境: 24コア / 32スレッド x64 デスクトップCPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
ピークメモリだけでは、作業量が少ないエンジンを有利にする可能性がありますが、これは最終列で対処されています。ピークメモリを持続的なスループットで割ることで、1秒あたりのレンダーごとのメモリコストが得られます。ドキュメントを正しくレンダリングしたエンジンの中で、IronPDFは27.0 MBで最も効率的であり、Playwrightの54.3 MBやPuppeteerSharpの82.9 MBと比較されます。
絶対的なピークメモリのランキングは異なります。Playwrightは、同時実行数1、4、8で239 MB、100 MB、65 MBと低いピークを持ち、16ではそのリードを返し、IronPDFが1,770 MBでピークに達し、Playwrightは1,808 MBです。8では、リードが実際にあり、IronPDFの44.02に対して20.68レンダー/秒を提供するため、65 MBの節約はスループットの半分以上のコストがかかります。
レイアウトエンジンライブラリは、ブラウザエンジンがないため、メモリ使用量が大幅に低くなります。これは実際の利点ですが、このテストでは合計が0.00にとどまる結果となりました。
3つのChromium駆動エンジンでは、8から16の同時レンダー間でピークメモリが49%から62%増加し、スループットの増加はありません。IronPDFのスループットは9%減少し、PuppeteerSharpは変わらず、Playwrightは3%増加します。中央値のレイテンシー(p50)は、同じステップで1.9から2.3倍に上昇します。8を超える同時レンダーでの追加メモリは、スループットではなくレイテンシーを生み出します。
すべての出力は信頼されるのではなく、読み返されました。チェックはテキストレイヤーを抽出し、正規表現で請求書の合計を一致させ、キャンバスチャートにはテキストレイヤーがないため、テキストだけでは確認できないため、すべてのページをラスタライズします。
using System;
using System.IO;
using System.Linq;
using System.Text.RegularExpressions;
using IronPdf;

// Reads each engine's output back and reports what actually landed on the page.
// A render that finishes in 109 ms and gets the total wrong is not faster than
// one that finishes in 164 ms and gets it right - it is a different operation,
// so the timer alone cannot be trusted.
string resultsDir = "results";

Console.WriteLine($"{"Engine",-16} {"Pages",5} {"Bytes",8} {"Total",-12} Notes");
Console.WriteLine(new string('-', 62));

foreach (string path in Directory.GetFiles(resultsDir, "*-single.pdf").OrderBy(p => p))
{
    string engine = Path.GetFileNameWithoutExtension(path).Replace("-single", "");

    using PdfDocument document = PdfDocument.FromFile(path);
    string flat = Regex.Replace(document.ExtractAllText() ?? "", @"\s+", " ");

    // The document computes its totals in JavaScript. If the script never ran,
    // the placeholder zero survives into the text layer of the PDF.
    Match total = Regex.Match(flat, @"Total\s+([\d,]+\.\d{2})");
    string reported = total.Success ? total.Groups[1].Value : "not found";
    bool scriptRan = reported != "0.00" && total.Success;

    // The canvas chart has no text layer, so rasterise page two as well and
    // confirm it by eye. A missing chart cannot be detected from text alone.
    document.RasterizeToImageFiles(Path.Combine(resultsDir, engine + "-page_*.png"), 1400, 1980);

    long bytes = new FileInfo(path).Length;
    string note = scriptRan ? "" : "JavaScript did not run";
    if (!flat.Contains("Professional services")) note += " | table rows missing";

    Console.WriteLine($"{engine,-16} {document.PageCount,5} {bytes,8} {reported,-12} {note}");
}

// Output size is a fast tell, but not a sufficient one. Identical HTML produced
// 46 to 104 KB from the engines that ran the script and drew the chart, so the
// 6 KB output is missing content rather than encoding it more cleverly. It cuts
// the other way too: one engine dropped the masthead, the totals and the chart
// and still produced 46 KB, so size narrows the question without answering it.
using System;
using System.IO;
using System.Linq;
using System.Text.RegularExpressions;
using IronPdf;
// Reads each engine's output back and reports what actually landed on the page.
// A render that finishes in 109 ms and gets the total wrong is not faster than
// one that finishes in 164 ms and gets it right - it is a different operation,
// so the timer alone cannot be trusted.
string resultsDir = "results";
Console.WriteLine($"{"Engine",-16} {"Pages",5} {"Bytes",8} {"Total",-12} Notes");
Console.WriteLine(new string('-', 62));
foreach (string path in Directory.GetFiles(resultsDir, "*-single.pdf").OrderBy(p => p))
{
string engine = Path.GetFileNameWithoutExtension(path).Replace("-single", "");
using PdfDocument document = PdfDocument.FromFile(path);
string flat = Regex.Replace(document.ExtractAllText() ?? "", @"\s+", " ");
// The document computes its totals in JavaScript. If the script never ran,
// the placeholder zero survives into the text layer of the PDF.
Match total = Regex.Match(flat, @"Total\s+([\d,]+\.\d{2})");
string reported = total.Success ? total.Groups[1].Value : "not found";
bool scriptRan = reported != "0.00" && total.Success;
// The canvas chart has no text layer, so rasterise page two as well and
// confirm it by eye. A missing chart cannot be detected from text alone.
document.RasterizeToImageFiles(Path.Combine(resultsDir, engine + "-page_*.png"), 1400, 1980);
long bytes = new FileInfo(path).Length;
string note = scriptRan ? "" : "JavaScript did not run";
if (!flat.Contains("Professional services")) note += " | table rows missing";
Console.WriteLine($"{engine,-16} {document.PageCount,5} {bytes,8} {reported,-12} {note}");
}
// Output size is a fast tell, but not a sufficient one. Identical HTML produced
// 46 to 104 KB from the engines that ran the script and drew the chart, so the
// 6 KB output is missing content rather than encoding it more cleverly. It cuts
// the other way too: one engine dropped the masthead, the totals and the chart
// and still produced 46 KB, so size narrows the question without answering it.Imports System
Imports System.IO
Imports System.Linq
Imports System.Text.RegularExpressions
Imports IronPdf
' Reads each engine's output back and reports what actually landed on the page.
' A render that finishes in 109 ms and gets the total wrong is not faster than
' one that finishes in 164 ms and gets it right - it is a different operation,
' so the timer alone cannot be trusted.
Dim resultsDir As String = "results"
Console.WriteLine(String.Format("{0,-16} {1,5} {2,8} {3,-12} Notes", "Engine", "Pages", "Bytes", "Total"))
Console.WriteLine(New String("-"c, 62))
For Each path As String In Directory.GetFiles(resultsDir, "*-single.pdf").OrderBy(Function(p) p)
Dim engine As String = Path.GetFileNameWithoutExtension(path).Replace("-single", "")
Using document As PdfDocument = PdfDocument.FromFile(path)
Dim flat As String = Regex.Replace(document.ExtractAllText() ?? "", "\s+", " ")
' The document computes its totals in JavaScript. If the script never ran,
' the placeholder zero survives into the text layer of the PDF.
Dim total As Match = Regex.Match(flat, "Total\s+([\d,]+\.\d{2})")
Dim reported As String = If(total.Success, total.Groups(1).Value, "not found")
Dim scriptRan As Boolean = reported <> "0.00" AndAlso total.Success
' The canvas chart has no text layer, so rasterise page two as well and
' confirm it by eye. A missing chart cannot be detected from text alone.
document.RasterizeToImageFiles(Path.Combine(resultsDir, engine & "-page_*.png"), 1400, 1980)
Dim bytes As Long = New FileInfo(path).Length
Dim note As String = If(scriptRan, "", "JavaScript did not run")
If Not flat.Contains("Professional services") Then note &= " | table rows missing"
Console.WriteLine(String.Format("{0,-16} {1,5} {2,8} {3,-12} {4}", engine, document.PageCount, bytes, reported, note))
End Using
Next
' Output size is a fast tell, but not a sufficient one. Identical HTML produced
' 46 to 104 KB from the engines that ran the script and drew the chart, so the
' 6 KB output is missing content rather than encoding it more cleverly. It cuts
' the other way too: one engine dropped the masthead, the totals and the chart
' and still produced 46 KB, so size narrows the question without answering it.Imports System
Imports System.IO
Imports System.Linq
Imports System.Text.RegularExpressions
Imports IronPdf
' Reads each engine's output back and reports what actually landed on the page.
' A render that finishes in 109 ms and gets the total wrong is not faster than
' one that finishes in 164 ms and gets it right - it is a different operation,
' so the timer alone cannot be trusted.
Dim resultsDir As String = "results"
Console.WriteLine(String.Format("{0,-16} {1,5} {2,8} {3,-12} Notes", "Engine", "Pages", "Bytes", "Total"))
Console.WriteLine(New String("-"c, 62))
For Each path As String In Directory.GetFiles(resultsDir, "*-single.pdf").OrderBy(Function(p) p)
Dim engine As String = Path.GetFileNameWithoutExtension(path).Replace("-single", "")
Using document As PdfDocument = PdfDocument.FromFile(path)
Dim flat As String = Regex.Replace(document.ExtractAllText() ?? "", "\s+", " ")
' The document computes its totals in JavaScript. If the script never ran,
' the placeholder zero survives into the text layer of the PDF.
Dim total As Match = Regex.Match(flat, "Total\s+([\d,]+\.\d{2})")
Dim reported As String = If(total.Success, total.Groups(1).Value, "not found")
Dim scriptRan As Boolean = reported <> "0.00" AndAlso total.Success
' The canvas chart has no text layer, so rasterise page two as well and
' confirm it by eye. A missing chart cannot be detected from text alone.
document.RasterizeToImageFiles(Path.Combine(resultsDir, engine & "-page_*.png"), 1400, 1980)
Dim bytes As Long = New FileInfo(path).Length
Dim note As String = If(scriptRan, "", "JavaScript did not run")
If Not flat.Contains("Professional services") Then note &= " | table rows missing"
Console.WriteLine(String.Format("{0,-16} {1,5} {2,8} {3,-12} {4}", engine, document.PageCount, bytes, reported, note))
End Using
Next
' Output size is a fast tell, but not a sufficient one. Identical HTML produced
' 46 to 104 KB from the engines that ran the script and drew the chart, so the
' 6 KB output is missing content rather than encoding it more cleverly. It cuts
' the other way too: one engine dropped the masthead, the totals and the chart
' and still produced 46 KB, so size narrows the question without answering it.| ライブラリ | ページ数 | 出力サイズ | 請求書合計 | チャート | マストヘッドとレイアウト |
|---|---|---|---|---|---|
| IronPDF | 2 | 47,196 bytes | 2313.30 | 描画済み | グリッドはそのまま |
| Playwright .NET | 2 | 46,248 bytes | 2313.30 | 描画済み | グリッドはそのまま |
| PuppeteerSharp | 2 | 104,011 bytes | 2313.30 | 描画済み | グリッドはそのまま |
| iText 9 pdfHTML | 2 | 6,145 bytes | 0.00 | なし | グリッドは1列に折りたたまれた |
| HtmlRenderer + PdfSharp | 1 | 46,419 bytes | ブロックなし | なし | マストヘッドが削除され、ページ区切りが失われた |
| wkhtmltopdf | 2 | 22,752 bytes | 0.00 | なし | グリッドは1列に折りたたまれた |
| Aspose.HTML | 2 | 38,780 bytes | 0.00 | なし | グリッドは1列に折りたたまれた |
テスト環境: 24コア / 32スレッド x64 デスクトップ CPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
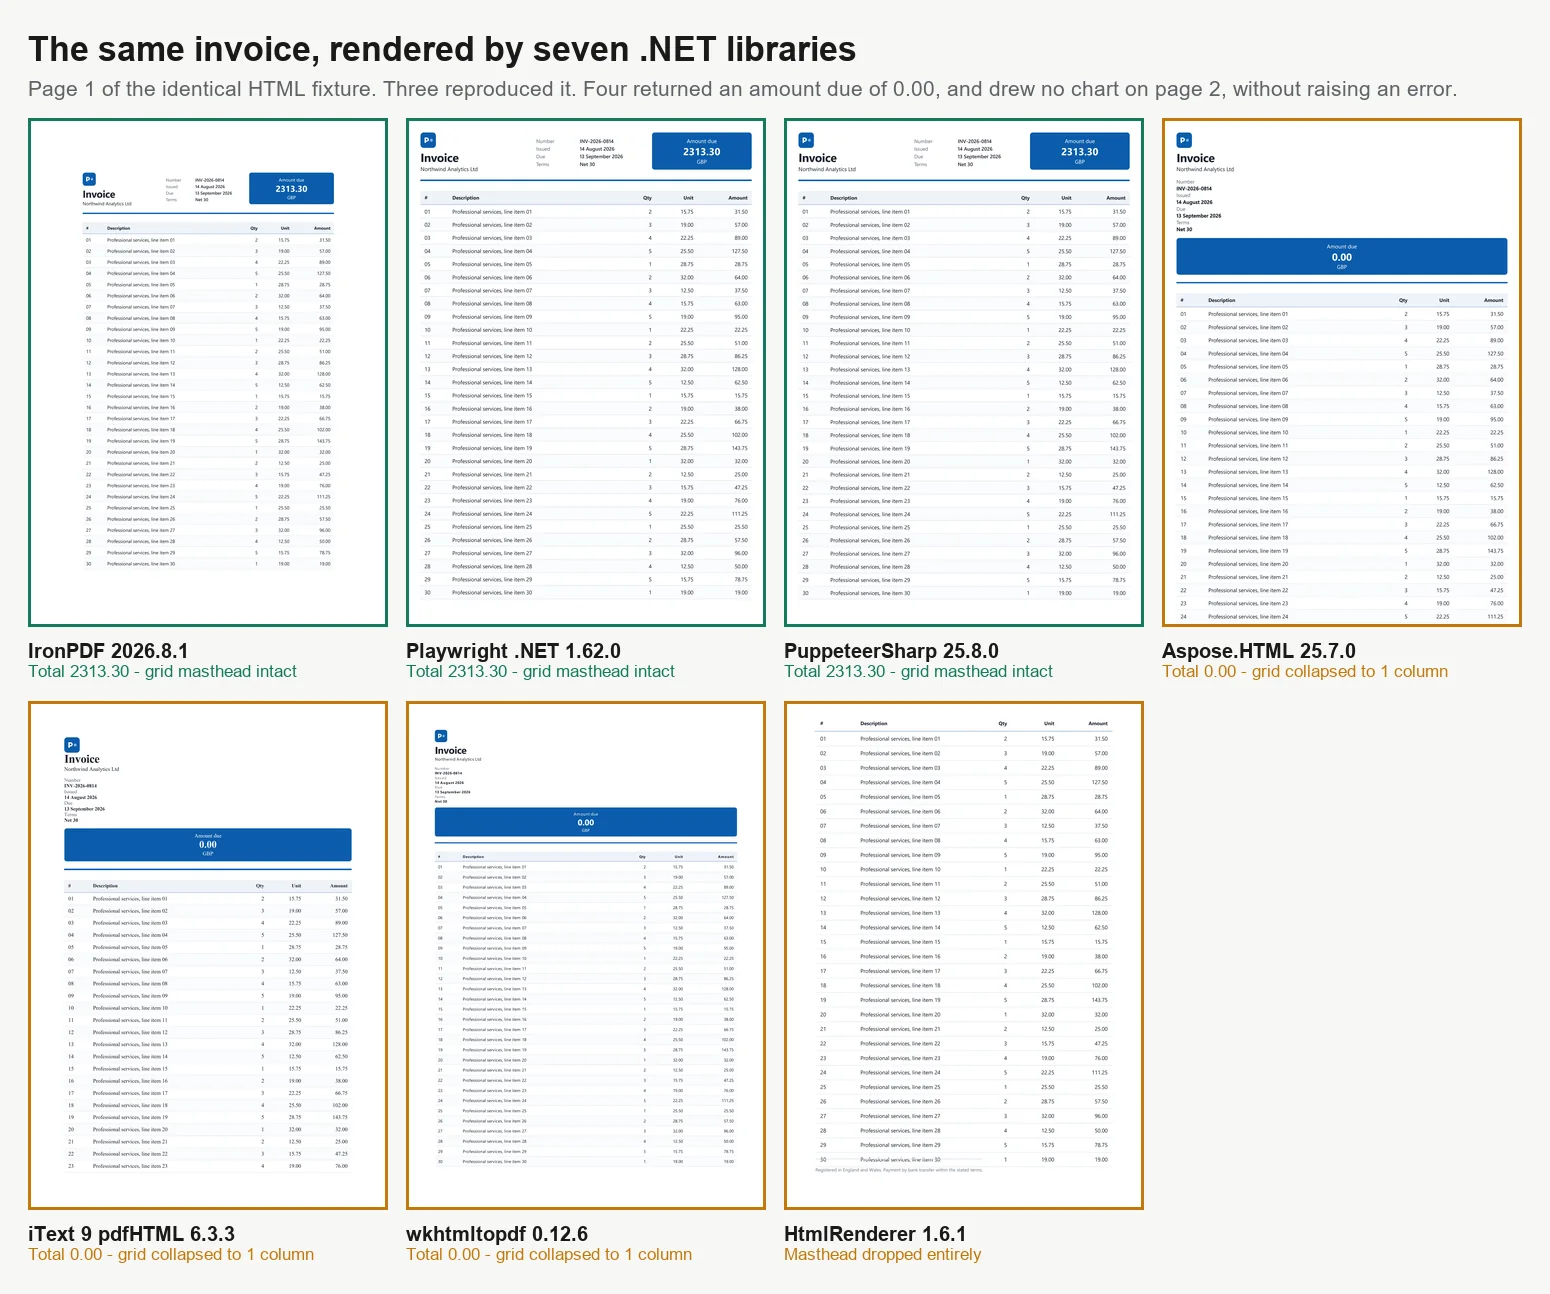
7つのすべての同じページを同じスケールで。最初の3つのパネルは合計を計算しました。他の4つは、レビュアーが気づかずに承認するものです。
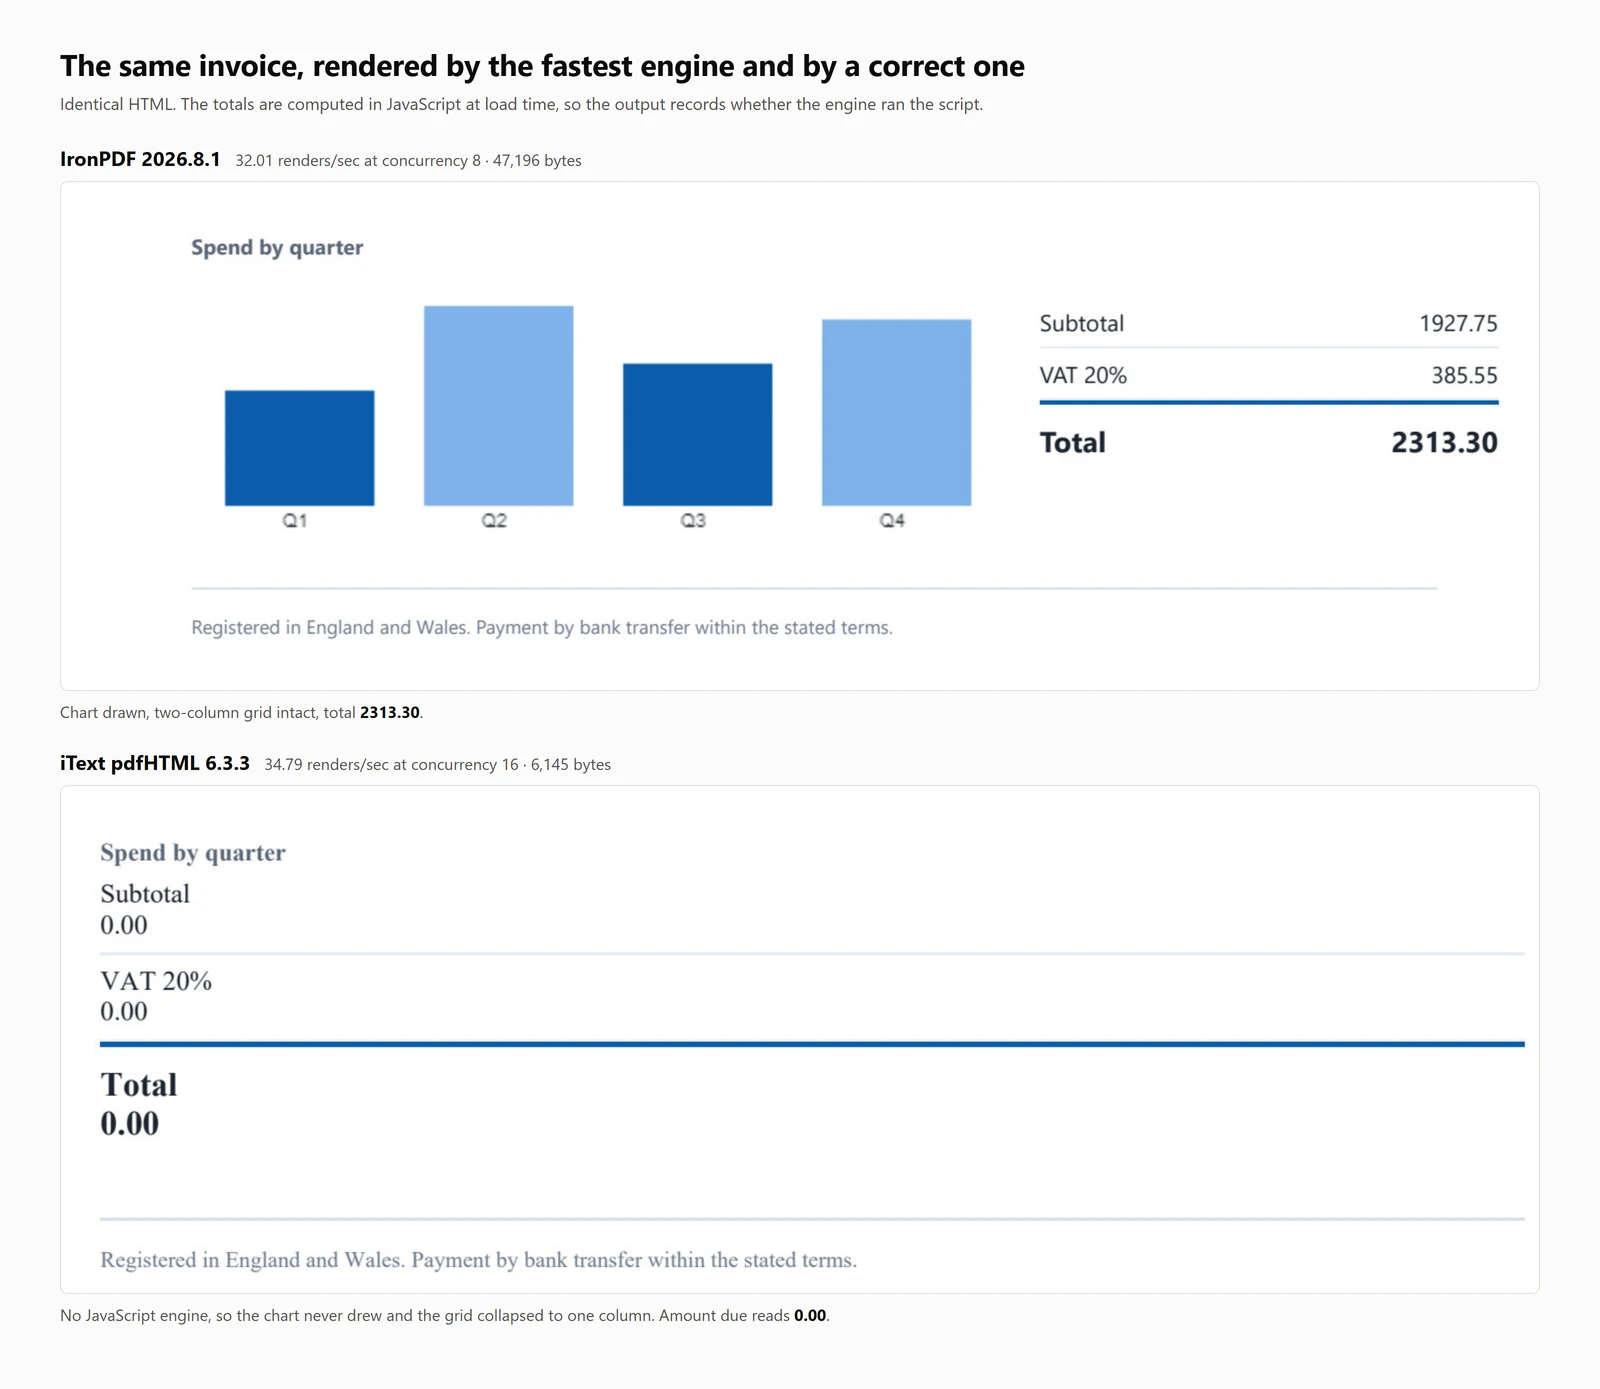
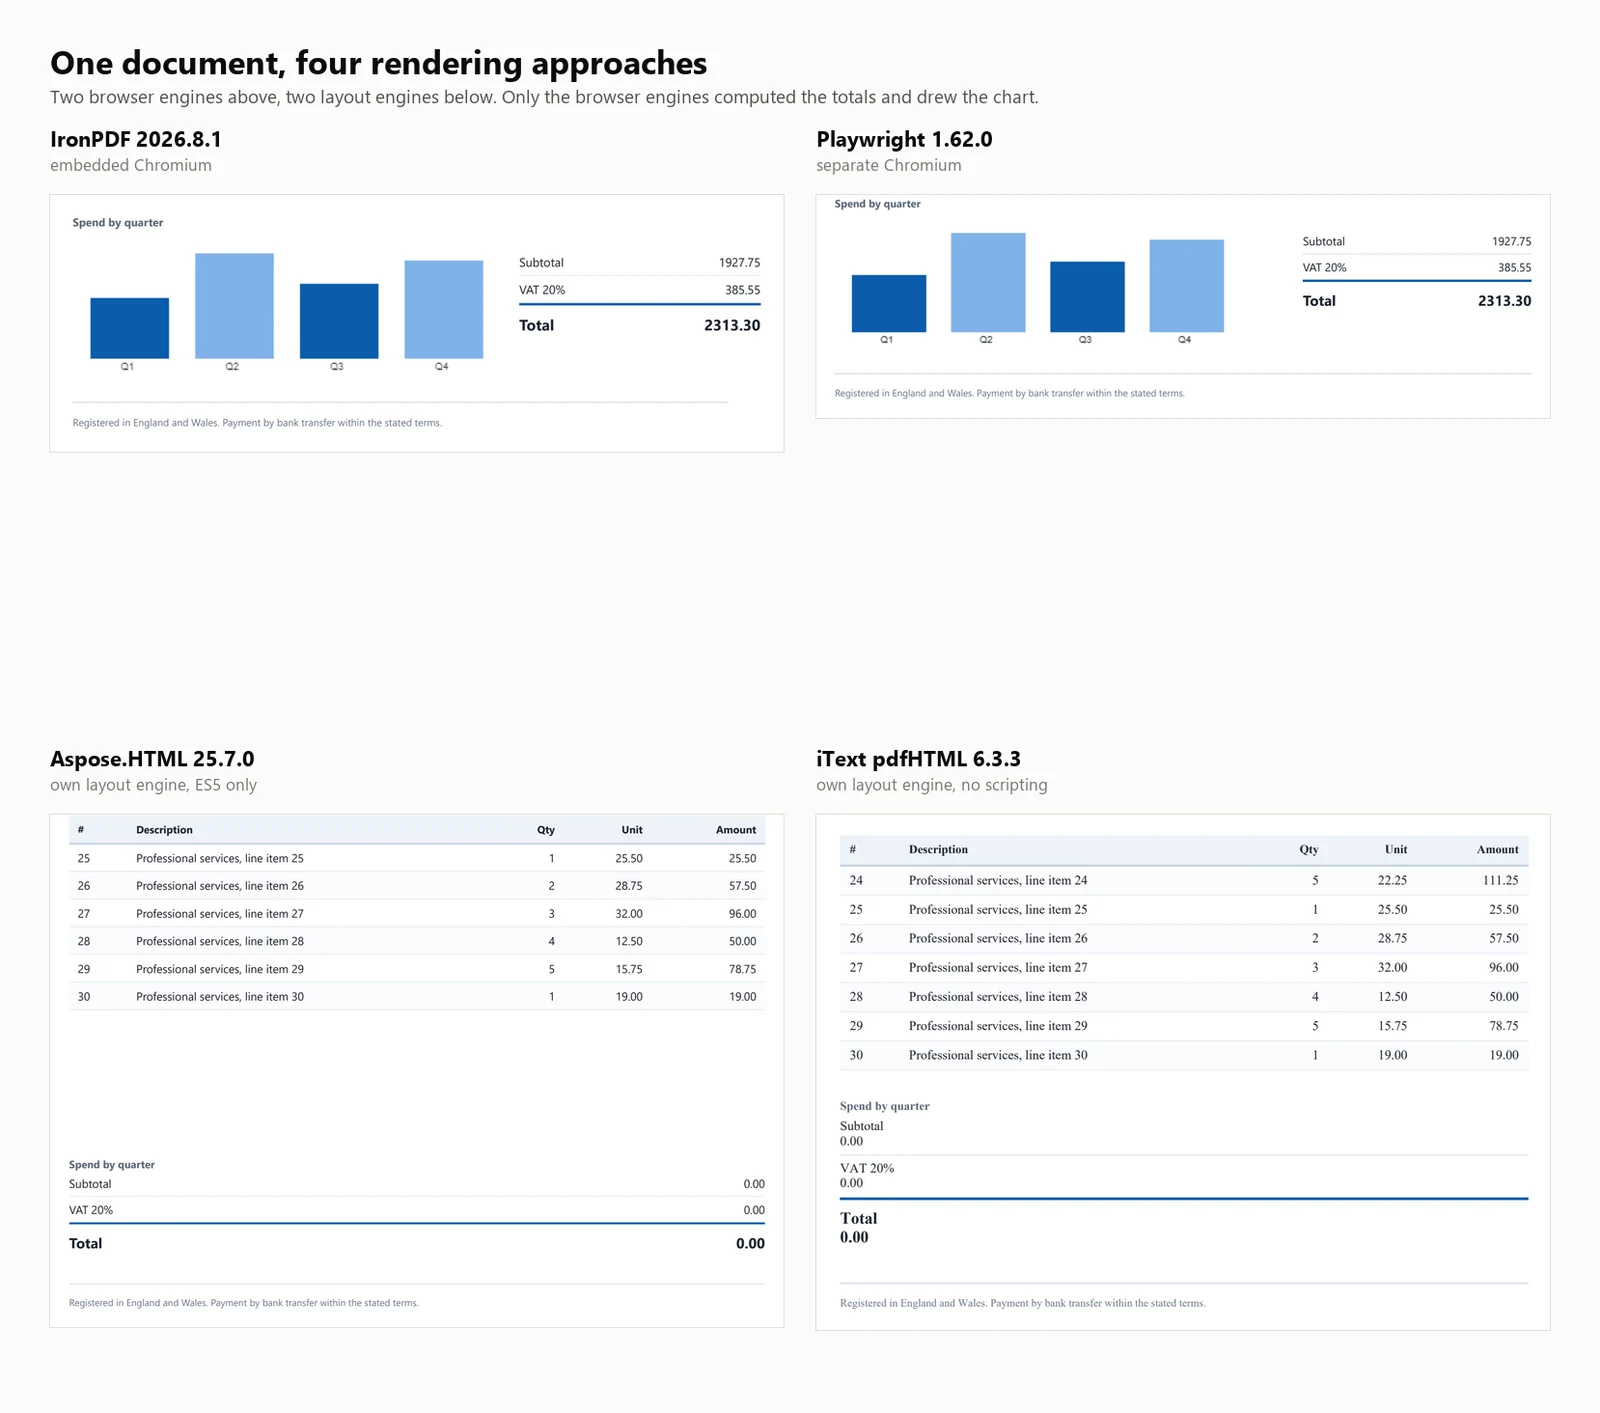
出力ファイルサイズはレンダリングの完全性を示す大まかな指標であり、誤りやすいものです。スクリプトを実行しグラフをレンダリングした3つのエンジンは、46〜104 KBのファイルを生成し、iText 9の6 KBの出力は、より良く圧縮されたのではなく、コンテンツが欠落しています。HtmlRendererでは逆方向に失敗し、46 KBのファイルは正しい出力と同じ範囲内に収まりますが、マストヘッド、合計、グラフが完全に欠落しているため、ファイルサイズは有用なチェックであり、決定的なものではありません。これらの失敗のいずれも例外や警告を引き起こさず、それらのPDFはすべて正しく形成されていて間違っています。
合計を計算できなかった4つのエンジンは、異なる理由で失敗しました。ES5とES6のサポートを別々に報告するターゲットテストページは、3つの異なるカテゴリを明らかにしました。
| エンジン | ES5 | ES6 | テスト請求書への影響 |
|---|---|---|---|
| IronPDF, PuppeteerSharp, Playwright | 実行 | 実行 | 合計が計算され、チャートが描画される |
| wkhtmltopdf, Aspose.HTML | 実行 | 例外を投げる | 合計はゼロのまま、チャートなし |
| iText 9 pdfHTML, HtmlRenderer | エンジンなし | エンジンなし | iTextはプレースホルダーのゼロを残し、HtmlRendererはブロックを削除した;どちらもチャートなし |
テスト環境: 24コア / 32スレッド x64 デスクトップ CPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
この区別はライブラリを選択する際に重要です。wkhtmltopdfとAspose.HTMLはES5ベースラインで書かれたスクリプトを実行し、正しい結果を計算しますが、テストページで使用されているdocument.querySelectorAll(...).forEachをサポートしていません。iText 9とHtmlRendererは、どの言語レベルでもJavaScriptを実行しません。
注: Chromeのレンダリングが基準として使用されており、これは本質的にChromiumベースのライブラリを優遇します。これは既知の制限ですが、ブラウザの出力を一致させることが通常必要とされるため、ほとんどのシナリオにおいて適切です。
再実行できないベンチマークは主張に過ぎません。上記の表の背後にあるすべてが1つのアーカイブに含まれており、数値を引用可能ではなく検証可能にする部分も含まれています。
ベンチマークバンドルをダウンロード (282 KB)
| フォルダー | 内容 |
|---|---|
| harness/ | 完全な実行可能プロジェクト:エンジンアダプター、並行性スイープ、コールドスタートドライバー、メモリサンプラー、忠実度チェック、および5回のパスを実行して中央値を取るスクリプト |
| fixture/invoice.html | 正確な入力、10,260文字、7つのエンジンすべてに渡されたバイト単位の内容 |
| raw-timings/ | 35の結果ファイル、7つのエンジンが5回のパスを通じて、各レベルのスループット、p50、p95、ピークメモリ、プロセス数、および計算された中央値を含む |
| outputs/ | そのフィクスチャから各エンジンが生成したPDF、精度の主張を信じるのではなく開くことができるように |
再現するには: dotnet build -c Release、次に./run-isolated.sh 1 2 3 4 5、次にpython median-iso.py。--engine <id>で単一のエンジンを実行しながら反復してください。これがメモリの数値を正直に保つ唯一の方法です。
アーカイブには意図的に3つのものが含まれていません。ライセンスキー、IronPDFが環境からIRONPDF_LICENSE_KEYを読み取り、Aspose.HTMLが独自の.licファイルを期待しているため、ここでは両方のエンジンが商用ライセンスで実行されました。wkhtmltopdf.exeバイナリは、そのプロジェクトのアーカイブされたリリースからのサードパーティのアーティファクトです。そして、PuppeteerSharpとPlaywrightが初回実行時にそれぞれダウンロードするブラウザです。
ベンチマークは、7つのエンジンが同じ請求書を変換する速度と精度に関する単一の質問を考慮しています。実際には、プロダクションパイプラインには追加の要件があります。次のセクションでは、よくあるフォローアップの質問に対する回答を提供します。
上記のすべての数値は、Windows 11でベアメタル上で取得されました。コンテナのCPU制限、cgroupメモリ計算、共有ホストなどの要因が並行性に影響を与える可能性があります。IronPDFはLinuxおよびDockerで同じNuGetパッケージを使用して動作し、Chromiumが含まれているため、別途ブラウザをダウンロードしたりPlaywrightをインストールする必要はありません。意図した並行性でのピーク使用量に基づいてコンテナのサイズを決定し、ランタイムのために追加の容量を追加してください。
ベンチマークは、各エンジンにネットワーク遅延を排除するためにインメモリ文字列を提供しました。実際の運用では、入力はしばしばURLであり、URLをPDFに変換するには通常、同じレンダラーでメソッドを変更するだけです。ここでテストされたレイアウトエンジンはこれを直接サポートしていません。iText 9とHtmlRendererはマークアップのみを受け入れるため、ページを取得し、相対パスを解決するためにベースURLを設定する必要があります。
テスト請求書は、フォントカバレッジをタイミング結果から除外するためにウェブセーフなラテンフォントスタックを使用しています。レンダラーは非ラテン文字で最も異なりますが、解決策は一貫しています。継承に頼るのではなく、フォントを明示的に指定してください。@font-faceを使用してフォントを埋め込むか、必要なフォントパッケージをイメージにインストールし、埋め込みルールについてはフォント処理ガイドを参照してください。Chromiumベースのエンジンは、ブラウザと同じシェーピングとフォールバック動作を提供します。
これらの結果は、2ページの請求書のバッチを処理した際のピーク値を反映しており、大規模なドキュメントや長時間のテストではありません。長いドキュメントや画像が多いドキュメントは、より多くのメモリを必要とします。持続的なワークロードには、制限付きの同時実行性を使用してください。セマフォで進行中のレンダリングを制限し、リクエストごとに新しいレンダラーインスタンスを作成するのではなく、単一のレンダラーインスタンスを再利用し、非同期でレンダリングすることで、スループットは同時実行性の上限によってのみ制限されます。バッチ処理チュートリアルは完全なガイドを提供します。
この段階では、ソリューション間の差異が減少するのではなく増加します。ベンチマークは、特にレンダリングという単一の操作を評価しましたが、これは無料エンジンの主要な機能を表しています。しかし、ほとんどのドキュメント処理パイプラインは、このポイントを超えた追加の機能を必要とします。
2 つのエンジンは、ブラウザを含まないことで最高のスループットを達成しましたが、結果として得られるドキュメントにはこの制限が反映されていました。iText 9 は 0.00 の金額を返し、HtmlRenderer は合計ブロックを完全に省略しました。Aspose.HTML は独自のレイアウトエンジンで同じ結果を達成し、wkhtmltopdf はページを実行するには古すぎる QtWebKit ビルドを使用しました。このアプローチは、マークアップが静的で、動的な計算、チャート、計算された合計、または最新のレイアウトを必要としない場合にのみ機能します。これらの機能が存在する場合、ベンチマーク結果はその限界を示しています。
正しく出力される必要があるもののデフォルト: IronPDF。これは、44.02 レンダリング/秒でドキュメントを正しくレンダリングし、同一のハードウェアで Playwright の 2.1 倍、PuppeteerSharp の 2.8 倍の速度を達成し、486 ms で最初の PDF を生成し、請求書を再現した 3 つのエンジンの中で最も多くの作業をメガバイトあたりに返しました。Chromium はパッケージ内に含まれているため、インストール、監視、またはパッチを当てるブラウザはなく、マージ、フォーム、署名、PDF/A、暗号化が次のライブラリではなく同じライブラリに含まれています。
他の 6 つのライブラリには、それぞれ特定の制限があり、以下に示されています。
Playwright .NET は Chrome グレードの出力を生成し、ライセンス費用はかかりませんが、44.02 に対して 20.68 レンダリング/秒です。ライセンスは唯一のコストではありません。イメージ内のブラウザバイナリを維持し、ビルド内の playwright install chromium ステップ、負荷時に 23 プロセスに達するプロセスプール、サービスの寿命にわたる Chromium のパッチ適用を行います。
PuppeteerSharp もドキュメントを再現し、15.60 レンダリング/秒で、ここで測定された中で最も多くのプロセスを生成し、16 の同時実行で 40 です。その p50 は 507 ms から 997 ms に倍増し、スループットは変わらないため、これらの追加プロセスは容量ではなくレイテンシーを追加します。
iText 9 with pdfHTML は 54.30 レンダリング/秒で高速で、返された請求書には合計があるべき場所に 0.00 と表示されます。どの言語レベルでも JavaScript エンジンを持たないため、その結果は解決すべき設定の問題ではありません。これは AGPL または商用であるため、ほとんどのチームにとっては有料のライブラリであり、それでもページを実行できません。
HtmlRenderer with PdfSharp はベンチマークで最速で、327.09 レンダリング/秒で、157 ms で最初の PDF を生成します。その出力はマストヘッド、合計ブロック、チャートを削除し、2 ページを 1 ページに圧縮しました。その CSS サポートは 2011 年頃で止まっているため、ページをレイアウトしないことで得られる速度です。
wkhtmltopdf は 2023 年 1 月にアーカイブされたエンジンを実行し、2020 年 6 月に最後にリリースされ、Qt 4.8.5 上で動作します。ES5 を実行し、ES6 でエラーをスローするため、合計が 0.00 と表示され、セキュリティパッチは受け取りません。現在のテンプレートを正しくレンダリングする場合、テンプレートが変更されるまでそれを続けます。
Aspose.HTML は無料のティアがない有料ライブラリで、他のレイアウトエンジンと同じ 0.00 の合計と欠落したチャートを生成し、最初の PDF までに 1,096 ms かかり、測定された中で最も遅いです。そのケースはレンダリングではなく調達です。
ダッシュボード、チャート、またはロード時に計算されるものに対して: ブラウザグレードのエンジンが唯一機能するカテゴリであり、IronPDFはそのカテゴリで操作する必要がないものです。
PDFはJavaScriptが描画を完了する前にキャプチャされます。この不具合は開発中に確実に再現され、本番環境の負荷下では断続的に発生するため、診断が難しくなります。
固定された期間ではなく条件を待ちます。すべてのブラウザベースのライブラリは、ネットワークの非アクティブ、指定された要素の出現、またはJavaScript式がtrueを返すなどの条件が満たされるまでレンダリングを保持することができます。チャートライブラリはダウンロードを完了する前に描画を完了するため、要素を優先します。
// IronPDF 2026.8.1 - waiting for the page to finish drawing itself.
using IronPdf;

var renderer = new ChromePdfRenderer();

// Waiting for a specific element beats waiting for the network, because a chart
// library can finish downloading well before it finishes rendering.
renderer.RenderingOptions.WaitFor.HtmlElementById("chart-ready", maxWaitTimeInMilliseconds: 10000);

// A JavaScript condition works too when there is no element to key on.
// renderer.RenderingOptions.WaitFor.JavaScript(5000);

using PdfDocument pdf = renderer.RenderHtmlAsPdf(html);
pdf.SaveAs("dashboard.pdf");
// IronPDF 2026.8.1 - waiting for the page to finish drawing itself.
using IronPdf;
var renderer = new ChromePdfRenderer();
// Waiting for a specific element beats waiting for the network, because a chart
// library can finish downloading well before it finishes rendering.
renderer.RenderingOptions.WaitFor.HtmlElementById("chart-ready", maxWaitTimeInMilliseconds: 10000);
// A JavaScript condition works too when there is no element to key on.
// renderer.RenderingOptions.WaitFor.JavaScript(5000);
using PdfDocument pdf = renderer.RenderHtmlAsPdf(html);
pdf.SaveAs("dashboard.pdf");' IronPDF 2026.8.1 - waiting for the page to finish drawing itself.
Imports IronPdf
Dim renderer = New ChromePdfRenderer()
' Waiting for a specific element beats waiting for the network, because a chart
' library can finish downloading well before it finishes rendering.
renderer.RenderingOptions.WaitFor.HtmlElementById("chart-ready", maxWaitTimeInMilliseconds:=10000)
' A JavaScript condition works too when there is no element to key on.
' renderer.RenderingOptions.WaitFor.JavaScript(5000)
Using pdf As PdfDocument = renderer.RenderHtmlAsPdf(html)
pdf.SaveAs("dashboard.pdf")
End Using' IronPDF 2026.8.1 - waiting for the page to finish drawing itself.
Imports IronPdf
Dim renderer = New ChromePdfRenderer()
' Waiting for a specific element beats waiting for the network, because a chart
' library can finish downloading well before it finishes rendering.
renderer.RenderingOptions.WaitFor.HtmlElementById("chart-ready", maxWaitTimeInMilliseconds:=10000)
' A JavaScript condition works too when there is no element to key on.
' renderer.RenderingOptions.WaitFor.JavaScript(5000)
Using pdf As PdfDocument = renderer.RenderHtmlAsPdf(html)
pdf.SaveAs("dashboard.pdf")
End UsingCSSレンダリングの問題の大部分は、4つの主要な原因に起因します。
一般的な見落としは、スタイルシート内の@media printブロックで、これは印刷レンダリング中にのみ適用され、ブラウザには表示されません。デフォルトに頼るのではなく、RenderingOptions.CssMediaTypeを使用してCSSメディアタイプを明示的に設定し、正しいスタイルシートが適用されるようにします。
2番目の問題は、背景や色が表示されないことで、ブラウザはインクを節約するために印刷時にそれらを省略することがよくあります。RenderingOptions.PrintHtmlBackgrounds = trueを有効にしてそれらを復元し、影響を受けない要素にはCSSでprint-color-adjust: exactを使用します。
残りの2つの原因はタイミングに関連しています。スナップショットが撮られるときに画像がまだ遅延読み込みされているか、ウェブフォントが読み込まれていないため、テキストがシステムフォントにフォールバックし、レイアウトが変更される可能性があります。これらの問題に対処するには、レンダリング前にすべてのリソースが読み込まれていることを確認します。
文字列からレンダリングする場合、ベースの場所がないため、レンダラーは/images/logo.pngのような相対パスを解決できません。これは文字列入力で最も一般的な問題であり、単一の設定で解決できます。
レンダリング前にベースURLまたはベースパスを設定します。IronPDFの場合はRenderingOptions.BaseUrlOrPathを使用します。iTextの場合はConverterProperties.SetBaseUriを使用します。あるいは、ドキュメント全体で絶対URLを使用します。相対パスが解決された後に必要になる可能性のあるアセットエンコーディングに関する情報は、ベースURLガイドを参照してください。
確認すべき主な原因は3つあります。まず、必要なフォントがイメージにインストールされていない可能性があります。次に、ネイティブ依存関係が欠落している可能性があります。最後に、イメージビルド中にブラウザがダウンロードされておらず、実行時に取得できない可能性があります。
フォントが欠落している場合、エラーが報告されないため診断が難しいです。PDFはレンダリングされますが、テキストは空のボックスとして表示されます。レンダリングコードをトラブルシューティングするのではなく、必要なフォントパッケージをインストールします。ブラウザのダウンロードについては、IronPDFのChromiumのような埋め込みエンジンはパッケージ内にブラウザを含んでいるため、ネットワーク制限により失敗する可能性のある初回実行のダウンロードが不要です。
この問題は上記と同じ根本原因を共有していますが、特定の症状として現れます。特定のスクリプトに必要なフォントがコンテナに存在しないのです。タイ語、アラビア語、CJKなどの言語は、これらのスクリプトをカバーする基本イメージが不足していることが多いため、最も影響を受けます。
@font-faceとフォントファイルを使用してドキュメントにフォントを埋め込むか、イメージにパッケージをインストールしてください。バージョン間で変更される基本イメージのデフォルトセットに依存しないでください。フォント処理ガイドには埋め込みの詳細があります。
一般的な失敗は、ローカルでは動作するがコンテナ内で失敗するという構成です。ほとんどのケースは3つの修正でカバーされています。
ビルド時にブラウザをダウンロードする、初回実行時ではなく: イメージにChromiumが含まれていない場合、デプロイ後の最初のリクエストで150 MBのダウンロードがトリガーされるか、外部接続がブロックされている場合は完全に失敗します。
必要なフォントとネイティブ依存関係をインストールする: スリムな基本イメージは最小限のフォントセットを提供します。ラテン文字以外のスクリプトを含むドキュメントには追加のフォントパッケージが必要です。
サンドボックスを無効にしない: --no-sandboxを渡すことで、サンドボックスをオフにしてルートとしてChromeを実行することでエラーを解決します。代わりに、seccompプロファイルを持つ非ルートユーザーを設定してください。
# IronPDF on Linux. The engine ships in the NuGet package, so there is no
# browser download at first run and no Chromium to supervise.
FROM mcr.microsoft.com/dotnet/aspnet:10.0 AS base
WORKDIR /app

# Chromium's Linux dependencies plus fonts. Slim base images carry neither, and
# a missing font produces empty boxes rather than an error.
RUN apt-get update && apt-get install -y --no-install-recommends \
        libnss3 libatk-bridge2.0-0 libgbm1 libasound2 libxshmfence1 \
        fonts-liberation fonts-noto-core fonts-noto-cjk \
    && rm -rf /var/lib/apt/lists/*

FROM mcr.microsoft.com/dotnet/sdk:10.0 AS build
WORKDIR /src
COPY ["InvoiceService.csproj", "./"]
RUN dotnet restore "InvoiceService.csproj"
COPY . .
RUN dotnet publish "InvoiceService.csproj" -c Release -o /app/publish

FROM base AS final
WORKDIR /app
COPY --from=build /app/publish .

# Run as a non-root user rather than reaching for --no-sandbox.
RUN useradd --create-home --shell /usr/sbin/nologin renderer \
    && chown -R renderer:renderer /app
USER renderer

ENV IRONPDF_LICENSE_KEY=""
ENTRYPOINT ["dotnet", "InvoiceService.dll"]リソースの割り当ては、意図した同時実行レベルで観察されたピークメモリ使用量に基づいて決定する必要があります。ランタイムのオーバーヘッドやアプリケーションの要件を考慮して追加の容量を含めるべきです。これらの合計推定値を超えるインスタンスサイズを選択することが、信頼性のあるパフォーマンスを確保するために賢明です。
| ライブラリ | 8 同時実行時のピークツリー | 現実的なコンテナ | 持続的なレンダリング/秒 | 正しくレンダリングされた |
|---|---|---|---|---|
| IronPDF | 1,187 MB | 2 GB | 44.02 | はい |
| Playwright .NET | 1,122 MB | 2 GB | 20.68 | はい |
| PuppeteerSharp | 1,293 MB | 2 GB | 15.60 | はい |
| iText 9 pdfHTML | 332 MB | 1 GB | 54.30 | いいえ |
| HtmlRenderer + PdfSharp | 166 MB | 512 MB | 327.09 | いいえ |
| wkhtmltopdf | 482 MB | 1 GB | 16.03 | いいえ |
| Aspose.HTML | 334 MB | 1 GB | 33.98 | いいえ |
テスト環境: 24コア / 32スレッド x64 デスクトップ CPU · 3.2 GHz · 64 GB RAM · Windows 11 x64 · .NET 10 · IronPDF (2026.8.1) · 最終確認 2026年9月
最終列に示された比較メモリ数値は、リソース要件の明確化を提供します。すべての3つの正しいレンダリングエンジンは2 GBのコンテナ内で動作し、スループットがメモリ消費ではなく重要な差別化要因として位置付けられます。彼らのスループットは16から44レンダリング/秒の範囲であり、PuppeteerSharpをIronPDFより選択することは、同等の出力のためにほぼ3倍のインフラストラクチャを必要とします。PlaywrightとIronPDFの間の65 MBの差のようなピークメモリのわずかな違いは、インスタンス選択に実質的な影響を与えませんが、スループットの違いは運用コストに大きな影響を与えます。
2つの要素がこれらの数値をあなたの環境に合わせて変更します。1つはドキュメントの形状です。200ページのステートメントや高解像度の画像を多く含むドキュメントは、2ページの請求書が必要とするメモリのピークをはるかに超えます。もう1つは測定する場所です。デプロイするコンテナ内でテストを実行してください。なぜなら、マルチコアのワークステーションと仮想化されたインスタンスでは、同時作業のスケジュールが異なるからです。
C#に最適なHTMLからPDFへのライブラリは何ですか? これらの測定に基づくと、IronPDFはドキュメントを正しくレンダリングする最速のエンジンであり、44.02レンダリング/秒で、Playwrightの20.68やPuppeteerSharpの15.60を上回り、3つの中でメガバイトあたりの作業量が最も多かったです。
C#でURLをPDFに変換するにはどうすればよいですか?
ここにあるすべてのブラウザベースのライブラリはURLを直接受け取ります。HTML文字列の代わりにそれを渡し、残りのコードは変更しません。レイアウトエンジンライブラリであるiText 9とHtmlRendererはそうではありません。HttpClientでHTMLを取得し、文字列を渡し、相対的なアセットが解決されるようにベースURLを設定します。
どのライブラリがJavaScriptをサポートしていますか? サポートには3つのレベルがあります。IronPDF、PuppeteerSharp、Playwrightは最新のJavaScriptを完全に実行します。wkhtmltopdfとAspose.HTMLはES5を実行しますが、ES6ではエラーを出すため、最新のスクリプトは静かに失敗し、出力にプレースホルダー値を残します。iText 9とHtmlRendererにはJavaScriptエンジンがまったくありません。
ヘッドレスブラウザなしでHTMLをPDFに変換できますか? はい。iText 9、Aspose.HTML、およびPdfSharpを使用したHtmlRendererはすべて独自のレイアウトエンジンを持ち、ブラウザを必要としません。トレードオフはJavaScriptの実行と最新のCSSサポートです。
ASP.NET CoreでRazorビューをPDFに変換するにはどうすればよいですか?
最初にビューを文字列にレンダリングし、その文字列をここにある任意のライブラリに渡します。一般的な失敗は相対的なアセットパスです。HTMLが文字列になると、/css/site.cssが解決するものがなくなるため、ベースURLを設定するか絶対パスを使用してください。Razor-to-PDFガイドはMVCとBlazorのバリエーションをカバーしています。
wkhtmltopdfは2026年でも使用可能ですか? 動作しますが、アーカイブされています。最後の安定版リリースは2020年6月のQt (4.8.5)上のwkhtmltopdf (0.12.6)で、リポジトリは2023年1月にアーカイブされました。最新のCSSをレンダリングせず、セキュリティパッチも受け取りません。
なぜ私のPDFはブラウザと異なるように見えるのですか?
通常、@media printブロック、print-color-adjustなしで背景が印刷されない、画像がまだ遅延読み込みされている、またはスナップショットが撮られたときに到着していなかったWebフォントが原因です。
どのライブラリが最速ですか? HtmlRenderer with PdfSharpは327レンダリング/秒で、ヘッダや合計、チャートのない単一ページの出力でした。ドキュメントを正しくレンダリングしたエンジンの中では、IronPDFが最速で44.02レンダリング/秒でした。
HTMLからPDFへの変換にはどれくらいのメモリが必要ですか? 8つの同時レンダリングで166 MBから1,293 MBの間です。ブラウザベースのオプションはより重く、そのメモリの多くは子プロセスにありますので、.NETプロセス単独ではなくプロセスツリー全体からコンテナをサイズ設定してください。
単一のアプローチがすべての分野で優れているわけではありません。ブラウザベースのライブラリは最新のページを正確に再現しますが、より多くのメモリと大きなコンテナを必要とします。レイアウトエンジンライブラリは高速で小型ですが、JavaScriptを実行しないため、この請求書の7つの測定出力のうち4つは計算された合計がありませんでした。最適な選択は、主な制約によって異なります。
ブラウザプロセスを管理せずに正確なレンダリングが主な要件である場合、IronPDFはここで測定された中で最も高速な正確なレンダラーでした。そのAPIは、追加のライブラリを必要とせずに、HTML文字列の変換、Razorビュー、レスポンシブCSS、カスタムマージンと用紙サイズ、非同期レンダリング、PDF/Aアーカイブ、およびデジタル署名をサポートしています。大量使用の場合は、並行処理パターンについてバッチ処理チュートリアルを参照し、より広範なライブラリ選択についてはC# HTML to PDFライブラリの比較を参照してください。
次に進むべき場所は、多くの人が必要とする順序で。完全なウォークスルーについてはHTML to PDFチュートリアルから始め、貼り付け可能なコードについては実行可能なHTML to PDFの例を参照してください。無料の30日間トライアルは、上記のテンプレートを独自のドキュメントに対して実行し、ライセンス条件は、ここで測定されたAGPLおよびMIT条件に対して何を出荷できるかをカバーしています。
IronPDFをダウンロードして始めましょう。これらの数値が異なる場合や、ワークロードのサイズに関する第二の意見が必要な場合は、エンジニアリングサポートチームにお問い合わせください。IronPDFは、OCR、バーコード、Word、Excelもカバーする.NETライブラリを提供するIron Softwareによって構築されています。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。

IronPDF はIRONSUITEの一部です
オフィス文書用の10個の.NET API製品

PDFがHTMLのように見える必要があるとき、迅速に。
