# C#'ta Yapay Zeka Destekli PDF İşleme: IronPDF ile Belgeleri Özetleyin, Çıkarın ve Analiz Edin
**Yapay Zeka destekli PDF işleme** IronPDF ile **C#** kullanarak .NET geliştiricileri, mevcut PDF iş akışlarının üzerinde **belge özetlemesi**, **yapılandırılmış verilerin çıkarılması** ve **soru-cevap sistemleri** oluşturma imkanı sunar. Bu, topluluk temelli **Microsoft Semantic Kernel** üzerine inşa edilen `IronPdf.Extensions.AI` paketi aracılığıyla gerçekleştirilir ve **Azure OpenAI** ve **OpenAI** modelleri ile sorunsuz birliktelik sağlar. İster **yasal keşif araçları**, ister **finansal analiz hatları**, ister **belge zekası platformları** inşa edin, IronPDF PDF çıkarma ve bağlam hazırlığını yönetir, böylece AI mantığına odaklanabilirsiniz.
~~Kısa-Özet: Hızlı Başlangıç Kılavuzu~~
Bu eğitim, C# .NET'te doküman özetleme, veri çıkartma ve akıllı sorgulama için IronPDF'nin AI hizmetlerine nasıl bağlanacağını ele alır.
- **Kimin için:** Geliştiriciler, yasal keşif sistemleri, finansal analiz araçları, uyumluluk inceleme platformları veya büyük hacimli PDF dokümanlarından anlam çıkarması gereken her türlü uygulamayı inşa eden .NET geliştiricileri.
- **Ne inşa edeceksiniz:** Tek doküman özetleme, özel şemalarla yapılandırılmış JSON veri çıkartma, doküman içeriği üzerinde soru-cevap, uzun dokümanlar için RAG hatları ve belge kütüphaneleri genelinde toplu AI işleme iş akışları.
- **Nerede çalışır:** .NET 6+ ortamında Azure OpenAI veya OpenAI API anahtarına sahip herhangi bir yerde. AI uzantısı Microsoft Semantic Kernel ile entegre olur ve bağlam pencere yönetimi, bölümlendirme ve orkestrasyonu otomatik olarak yönetir.
- **Bu yaklaşımı ne zaman kullanılmalıdır:** Uygulamanızın PDF'leri metin çıkarmanın ötesinde işlemesi gerektiğinde - sözleşme yükümlülüklerini anlamak, araştırma makalelerini özetlemek, finansal tabloları yapılandırılmış veriler olarak çıkarmak veya ölçekli bir şekilde doküman içeriği hakkında kullanıcı sorularını yanıtlamak.
- **Teknik açıdan neden önemlidir:** Ham metin çıkartımı doküman yapısını kaybeder – tablolar karışık hale gelir, çok sütunlu düzenler anlamsız olur ve bölümler arasındaki anlamsal ilişkiler kaybolur. IronPDF, belgeleri yapısını koruyarak ve token sınırlarını yöneterek AI tüketimi için hazırlar, bu yüzden model düzenli, iyi organize edilmiş giriş alır.
Sadece birkaç satır kodla bir PDF özetleyin:
```cs
:title=One-Line PDF Summarization (after initialization)
await IronPdf.AI.PdfAIEngine.Summarize("contract.pdf", "summary.txt", azureEndpoint, azureApiKey);
```
IronPDF'yi satın aldıktan veya 30 günlük denemeye kaydolduktan sonra, başvurunuzda lisans anahtarınızı ekleyin.
```cs
IronPdf.License.LicenseKey = "KEY";
```
!!!--LIBRARY_NUGET_INSTALL_BLOCK--!!!
~~İçindekiler~~
- [AI + PDF Fırsatı](#the-ai-pdf-opportunity)
- [IronPDF'nin Dahili AI Entegrasyonu](#ironpdfs-built-in-ai-integration)
- [Doküman Özetleme](#document-summarization)
- [Akıllı Veri Çıkartımı](#intelligent-data-extraction)
- [Dokümanlar Üzerinden Soru-Cevap](#question-answering-over-documents)
- [Toplu AI İşlem](#batch-ai-processing)
- [Gerçek Dünya Kullanım Alanları](#real-world-use-cases)
- [Sorun Giderme & Teknik Destek](#troubleshooting-technical-support)
## AI + PDF Fırsatı
### Neden PDF'ler En Büyük Kullanılmamış Veri Kaynağıdır?
PDF'ler, modern işletmelerdeki yapılandırılmış iş bilgisinin en büyük deposunu temsil eder. Profesyonel belgeler - sözleşmeler, finansal beyanlar, uyum raporları, yasal özetler ve araştırma makaleleri - ağırlıklı olarak PDF formatında saklanmaktadır. Bu belgeler kritik iş zekası içerir: yükümlülük ve sorumlulukları tanımlayan sözleşme şartları, yatırım kararlarını yönlendiren finansal metrikler, uyumu sağlayan yasal gereklilikler ve strateji yönlendiren araştırma bulguları.
Ancak PDF işlemeye yönelik geleneksel yaklaşımlar ciddi şekilde sınırlıdır. Temel metin çıkartma araçları bir sayfadan ham karakterler çıkarabilir, ancak önemli bağlamı kaybederler: tablo yapıları karışık metne dönüşür, çok sütunlu düzenler anlamsız hale gelir ve bölümler arasındaki anlamsal ilişkiler kaybolur.
Kırılma noktası, AI'ın bağlamı ve yapıyı anlama yeteneğinden gelir. Modern LLM'ler sadece kelimeleri değil, aynı zamanda dokümanların organizasyonunu da anlar, sözleşme maddeleri veya finansal tablolar gibi desenleri tanır ve karmaşık düzenlerden bile anlam çıkarabilir. GPT-5'in gerçek zamanlı yönlendiriciye sahip birleşik muhakeme sistemi ve Claude Sonnet 4.5'in geliştirilmiş ajan becerileri, önceki modellere kıyasla önemli ölçüde azaltılmış halüsinasyon oranları göstererek, profesyonel doküman analizi için güvenilir hale getirmektedir.
### LLM'ler Belge Yapısını Nasıl Anlar?
Büyük dil modelleri, PDF analizine gelişmiş doğal dil işleme yetenekleri getirir. GPT-5'in hibrit yapıları, görev karmaşıklığına dayalı olarak dinamik bir şekilde en uygun varyantı seçen gerçek zamanlı bir yönlendirici ile ana, mini, düşünme ve nano adlı birçok alt-model içerir – basit sorular daha hızlı modellere yönendirilirken, karmaşık muhakeme görevleri tam modeli kullanır.
Claude Opus 4.6, özellikle uzun süreli ajans görevlerinde mükemmeldir, bölümlere ayrılmış işlerde doğrudan koordine olan ajan ekipleri ve tüm doküman kütüphanelerini parçalamadan işleyebilen 1M-token bağlam penceresi ile.
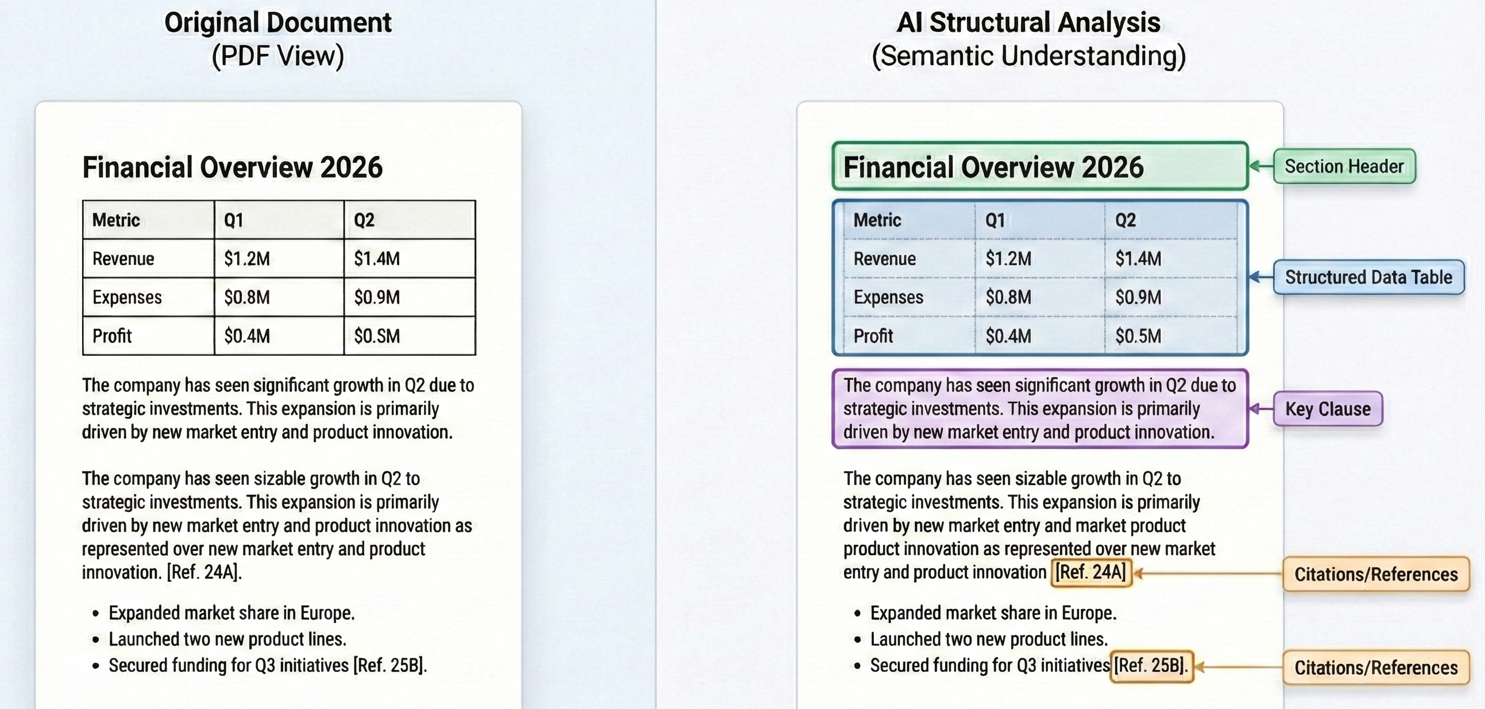
Bu bağlamsal anlama, LLM'lerin gerçek anlamaya ihtiyaç duyan görevleri gerçekleştirmesini sağlar. Bir sözleşmeyi analiz ederken, bir LLM sadece "fesih" kelimesini içeren maddeleri değil, fesihin hangi koşullar altında izin verildiğini, gerekli bildirim gereksinimlerini ve sonuçta ortaya çıkan yükümlülükleri de anlar. Bu yeteneği sağlayan teknik temel, modern LLM'leri destekleyen transformer mimarisi olup, GPT-5'in bağlam penceresi 272.000 giriş tokens desteği sağlarken, Claude Sonnet 4.5'in 200K token penceresi kapsamlı belge kapsamı sağlar.
## IronPDF'nin Dahili AI Entegrasyonu
### IronPDF ve AI Uzantılarının Kurulumu
AI destekli PDF işlemeye başlamak için temel IronPDF kütüphanesi, AI uzantıları paketi ve Microsoft Semantic Kernel bağımlılıkları gereklidir.
IronPDF'yi NuGet Paket Yöneticisi ile kurun:
```shell
:InstallCmd Install-Package IronPdf, IronPdf.Extensions.AI, Microsoft.SemanticKernel, Microsoft.SemanticKernel.Plugins.Memory
```
Bu paketler, eksiksiz bir çözü sağlamak için birlikte çalışır. IronPDF tüm PDF ile ilgili işlemleri yönetir - metin çıkartma, sayfa işleme, format dönüştürme - AI uzantısı ise Microsoft Semantic Kernel aracılığıyla dil modelleri ile entegrasyonu yürütür.
[[i:(Semantic Kernel paketleri deneysel API'ler içerir. Derleyici uyarılarını engellemek için `<NoWarn>$(NoWarn);SKEXP0001;SKEXP0010;SKEXP0050</NoWarn>`'i .csproj PropertyGroup bölümünüze ekleyin.)]]
### OpenAI/Azure API Anahtarınızı Yapılandırma
AI özelliklerinden yararlanabilmemiz için, bir AI hizmet sağlayıcısının erişimini yapılandırmanız gerekir. IronPDF'nin AI uzantısı hem OpenAI hem de Azure OpenAI'yi destekler. Azure OpenAI, genellikle gelişmiş güvenlik özellikleri, uyumluluk sertifikaları ve verileri belirli coğrafi bölgeler içinde saklama olanağı sağladığı için kurumsal uygulamalar için tercih edilir.
Azure OpenAI'yi yapılandırmak için, Azure portalından sohbet ve gömme modeller için Azure uç noktası URL'niz, API anahtarınız ve dağıtım adlarınız gerekir.
### AI Motorunu Başlatma
IronPDF'nin AI uzantısı kapalı kapılar ardında Microsoft Semantic Kernel kullanır. Herhangi bir AI özelliğini kullanmadan önce, Azure OpenAI kimlik bilgilerinizi kullanarak çekirdek yazılımı başlatmanız ve doküman işleme için bellek deposunu yapılandırmanız gerekir.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Initialize IronPDF AI with Azure OpenAI credentials

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel with Azure OpenAI
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

// Create memory store for document embeddings
var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

// Initialize IronPDF AI
IronDocumentAI.Initialize(kernel, memory);

Console.WriteLine("IronPDF AI initialized successfully with Azure OpenAI");
```
Başlatma iki anahtar bileşen yaratır:
- **Çekirdek:** Azure OpenAI üzerinden sohbet tamamlama ve metin gömme üretimini yönetir
- **Bellek:** Anlamsal arama ve alma işlemleri için doküman gömümlerini saklar
`IronDocumentAI.Initialize()` ile başlatıldıktan sonra, uygulamanız genelinde AI özelliklerini kullanabilirsiniz. Üretim uygulamaları için, kimlik bilgilerini ortamlarda veya Azure Key Vault'ta saklamak şiddetle tavsiye edilir.
### IronPDF'nin AI Bağlamı için PDF'leri Nasıl Hazırladığı
AI destekli PDF işlemenin en zorlayıcı yönlerinden biri, belgeleri dil modelleri tarafından tüketilmek üzere hazırlamaktır. GPT-5, 272.000 giriş tokenine kadar desteklerken ve Claude Opus 4.6 şimdi 1M token bağlam penceresi sunarken, tek bir yasal sözleşme veya finansal rapor hala eski modellerin sınırını kolayca aşabilir.
IronPDF'nin AI uzantısı, bu karmaşıklığı zeki belge hazırlığı ile yönetir. Bir AI yöntemini çağırdığınızda, IronPDF önce PDF'den metin çıkarır ve yapısal bilgileri koruyarak - paragrafları tanımlar, tablo yapılarını muhafaza eder ve bölümler arasındaki ilişkileri korur.
Bağlam sınırlarını aşan belgeler için, IronPDF yapısal belgelerdeki doğal ayrılma noktalarında - bölüm başlıkları, sayfa sonları veya paragraf sınırları gibi stratejik bölümlendirme uygular.
---
## Belgelerin Özetlenmesi
### Tek Belge Özetleri
Belge özetleme, uzun belgeleri hemen sindirilebilir içgörülere dönüştürerek anında değer sağlar. `Summarize` yöntemi tüm iş akışını ele alır: metni çıkarır, AI tüketimi için hazırlar, dil modelinden bir özet talep eder ve sonuçları kaydeder.
#### Girdi
<iframe loading="lazy" src="/static-assets/pdf/tutorials/ai-powered-pdf-processing-csharp/sample-report.pdf" width="100%" height="400px">
</iframe>
<br />
Kod, `PdfDocument.FromFile()` kullanarak bir PDF yükler ve kısa bir özet oluşturmak için `pdf.Summarize()`'i çağırır, ardından sonucu bir metin dosyasına kaydeder.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
// Summarize a PDF document using IronPDF AI
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Load and summarize PDF
var pdf = PdfDocument.FromFile("sample-report.pdf");
string summary = await pdf.Summarize();
Console.WriteLine("Document Summary:");
Console.WriteLine(summary);
File.WriteAllText("report-summary.txt", summary);
Console.WriteLine("\nSummary saved to report-summary.txt");
```
<br />
#### Konsol Çıkış
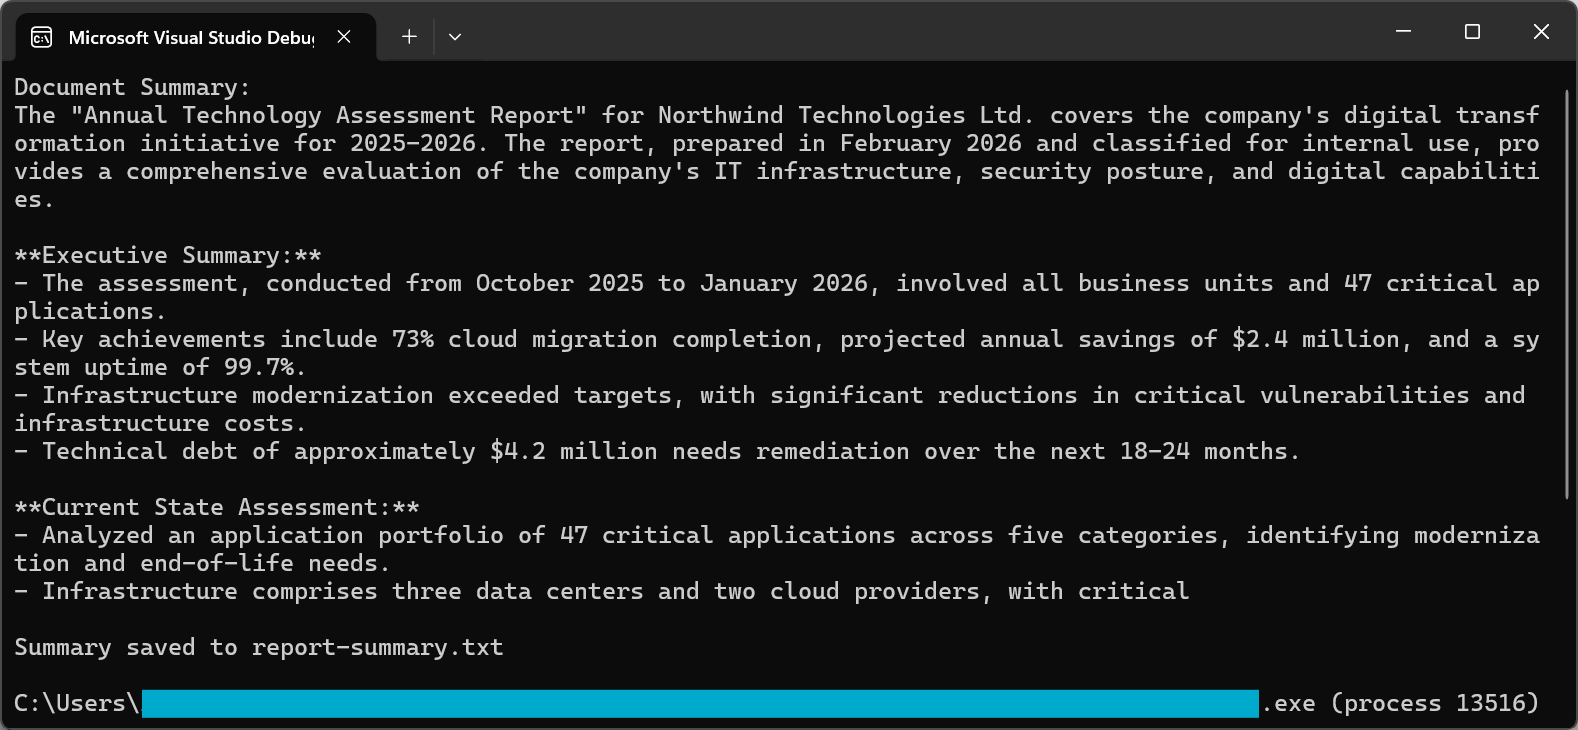
Özetleme, yüksek kaliteli sonuçları sağlamak için sofistike ipuçları kullanır. 2026 yılında hem GPT-5 hem de Claude Sonnet 4.5, talimat takibi yeteneklerinde önemli ölçüde gelişmiş özellikler sunarak özetlerin temel bilgileri yakalarken kısa ve okunabilir kalmasını sağlar.
Belge özetleme teknikleri ve gelişmiş seçenekler hakkında daha ayrıntılı bir açıklama için lütfen [nasıl yapılır kılavuzumuza](https://ironpdf.com/how-to/openai/) başvurun.
### Çok Belge Sentezi
Birçok gerçek dünya senaryosu, birden çok belge üzerinden bilgi sentezlemesini gerektirir. Bir hukuk ekibi, bir dizi sözleşme genelinde ortak maddeleri belirlemek isteyebilir veya bir mali analist, üç aylık raporlar genelinde metrikleri karşılaştırmak isteyebilir.
Çok belge sentezine yaklaşım, her belgeyi ayrı ayrı işleyerek anahtar bilgileri çıkarmak, ardından bu içgörüleri son sentez için bir araya getirmeyi içerir.
Bu örnek, birden çok PDF üzerinde dolaşarak her birine `pdf.Summarize()` çağrısı yapar, ardından birleştirilmiş özetlerle `pdf.Query()` kullanarak birleşik bir sentez oluşturur.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
// Synthesize insights across multiple related documents (e.g., quarterly reports into annual summary)
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Define documents to synthesize
string[] documentPaths = {
"Q1-report.pdf",
"Q2-report.pdf",
"Q3-report.pdf",
"Q4-report.pdf"
};
var documentSummaries = new List<string>();
// Summarize each document
foreach (string path in documentPaths)
{
var pdf = PdfDocument.FromFile(path);
string summary = await pdf.Summarize();
documentSummaries.Add($"=== {Path.GetFileName(path)} ===\n{summary}");
Console.WriteLine($"Processed: {path}");
}
// Combine and synthesize across all documents
string combinedSummaries = string.Join("\n\n", documentSummaries);
var synthesisDoc = PdfDocument.FromFile(documentPaths[0]);
string synthesisQuery = @"Based on the quarterly summaries below, provide an annual synthesis:
ll trends across quarters
chievements and challenges
over-year patterns
s:
inedSummaries;
string synthesis = await synthesisDoc.Query(synthesisQuery);
Console.WriteLine("\n=== Annual Synthesis ===");
Console.WriteLine(synthesis);
File.WriteAllText("annual-synthesis.txt", synthesis);
```
Bu model, büyük belge setlerine etkili bir şekilde ölçeklenir. Belgeleri paralel işleyerek ve ara sonuçları yöneterek, belgelerden oluşan yüzlerce veya binlerce belgeleri tutarlı bir sentez sağlarken analiz edebilirsiniz.
### Yöneticilere Yönelik Özet Üretimi
Yönetici özetleri, standart özetlemeden farklı bir yaklaşım gerektirir. İçeriği basitçe özetlemek yerine, bir yönetici özeti en önemli iş bilgilerini belirlemeli, anahtar kararları veya önerileri vurgulamalı ve bulguları liderlik incelemesine uygun bir formatta sunmalıdır.
Kod, iş dili ile ana kararları, kritik bulguları, finansal etkileri ve risk değerlendirmesini talep eden yapılandırılmış bir komut istemi ile `pdf.Query()` kullanır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
// Generate executive summary from strategic documents for C-suite leadership
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("strategic-plan.pdf");
string executiveQuery = @"Create an executive summary for C-suite leadership. Include:
cisions Required:**
ny decisions needing executive approval
al Findings:**
5 most important findings (bullet points)
ial Impact:**
e/cost implications if mentioned
ssessment:**
riority risks identified
ended Actions:**
ate next steps
er 500 words. Use business language appropriate for board presentation.";
string executiveSummary = await pdf.Query(executiveQuery);
File.WriteAllText("executive-summary.txt", executiveSummary);
Console.WriteLine("Executive summary saved to executive-summary.txt");
```
Sonuçta ortaya çıkan yönetici özeti, karar vericilerin detaylarla boğmadan tam olarak ihtiyaç duyduğu bilgileri sağlamaya üzere eyleme dönük bilgileri önceliklendirir.
---
## Akıllı Veri Çıkartımı
### JSON'a Yapılandırılmış Veri Çıkartma
AI destekli PDF işlemesinin en güçlü uygulamalarından biri, yapılandırılmamış belgelerden yapılandırılmış veri çıkartmaktır. 2026'da başarılı yapılandırılmış çıkartmanın anahtarı, yapılandırılmış çıkış modlarına sahip JSON şemalarıdır. GPT-5, geliştirilmiş yapılandırılmış çıkışlar sunarken, Claude Sonnet 4.5, güvenilir veri çıkartımı için gelişmiş araç orkestrasyonu sunar.
#### Girdi
<iframe loading="lazy" src="/static-assets/pdf/tutorials/ai-powered-pdf-processing-csharp/sample-invoice.pdf" width="100%" height="400px">
</iframe>
<br />
Kod, bir JSON şeması istemi ile `pdf.Query()` çağırır, ardından çıkarılan fatura verilerini ayrıştırmak ve doğrulamak için `JsonSerializer.Deserialize()` kullanır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;
// Extract structured invoice data as JSON from PDF
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("sample-invoice.pdf");
// Define JSON schema for extraction
string extractionQuery = @"Extract invoice data and return as JSON with this exact structure:
voiceNumber"": ""string"",
voiceDate"": ""YYYY-MM-DD"",
eDate"": ""YYYY-MM-DD"",
ndor"": {
""name"": ""string"",
""address"": ""string"",
""taxId"": ""string or null""
stomer"": {
""name"": ""string"",
""address"": ""string""
neItems"": [
{
""description"": ""string"",
""quantity"": number,
""unitPrice"": number,
""total"": number
}
btotal"": number,
xRate"": number,
xAmount"": number,
tal"": number,
rrency"": ""string""
NLY valid JSON, no additional text.";
string jsonResponse = await pdf.Query(extractionQuery);
// Parse and save JSON
try
{
var invoiceData = JsonSerializer.Deserialize<JsonElement>(jsonResponse);
string formattedJson = JsonSerializer.Serialize(invoiceData, new JsonSerializerOptions { WriteIndented = true });
Console.WriteLine("Extracted Invoice Data:");
Console.WriteLine(formattedJson);
File.WriteAllText("invoice-data.json", formattedJson);
}
catch (JsonException)
{
Console.WriteLine("Unable to parse JSON response");
File.WriteAllText("invoice-raw-response.txt", jsonResponse);
}
```
<br />
#### Üretilen JSON Dosya Ekran Görüntüsünün Bir Bölümü
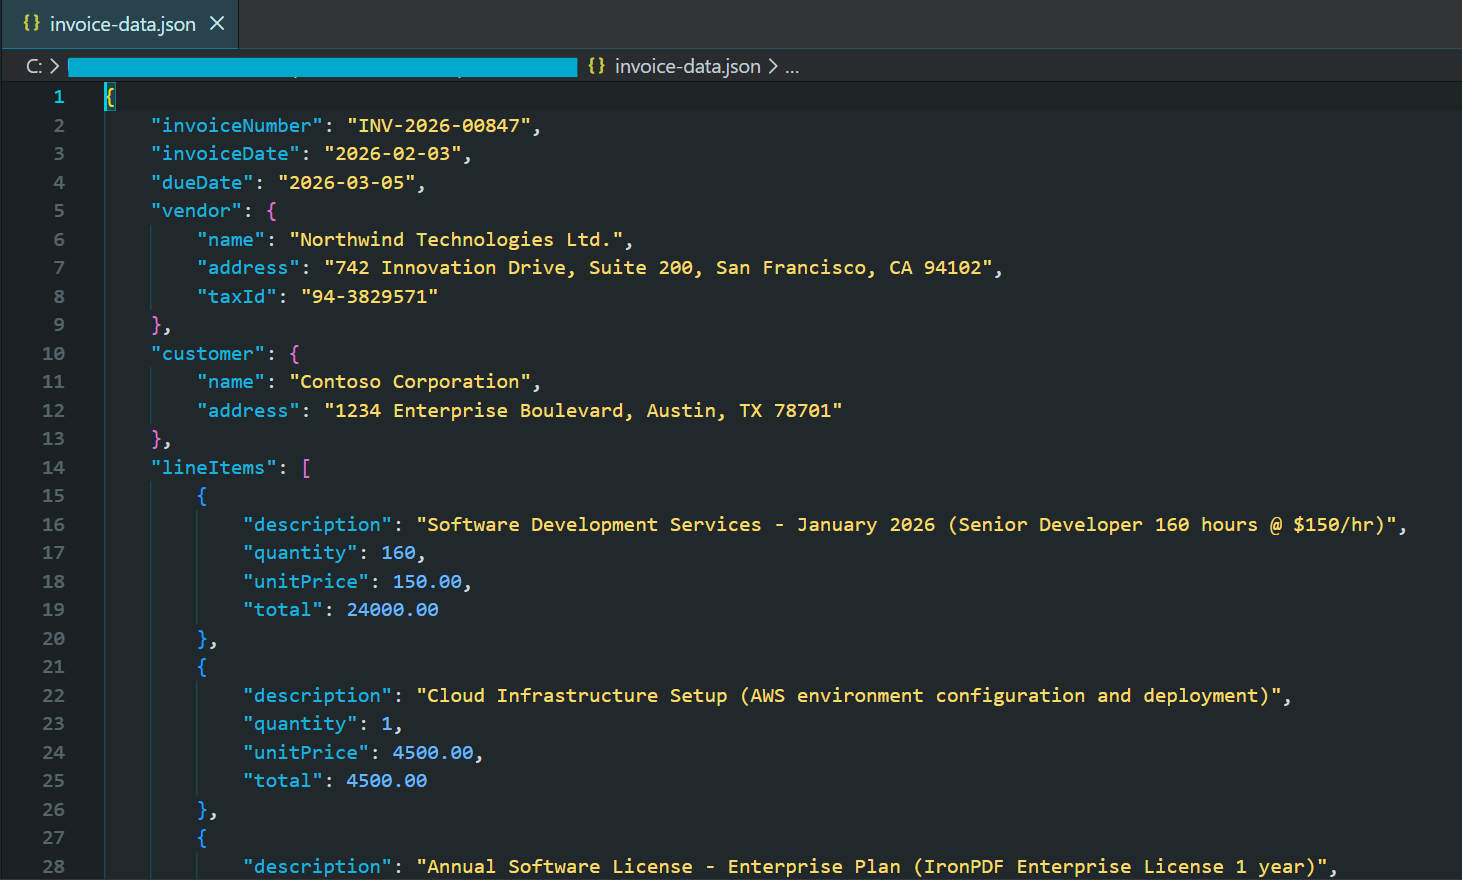
2026'daki modern AI modelleri, sağlanan şemalara uygun geçerli JSON yanıtlarını garanti eden yapılandırılmış çıkış modlarını destekler. Bu, hatalı yanıtlarla ilgili karmaşık hata işlemi ihtiyacını ortadan kaldırır.
### Sözleşme Maddesi Tanımlama
Yasal sözleşmeler, belirli önem taşıyan belirli türde maddeler içerir: fesih hükümleri, sorumluluk sınırlamaları, tazminat gereksinimleri, fikri mülkiyet ödevleri ve gizlilik yükümlülükleri. AI destekli madde tanımlama, bu analizi yüksek doğrulukla otomatikleştirir.
Bu örnek, sahte odaklı bir JSON şeması ile `pdf.Query()` ardından sözleşme türünü, tarafları, kritik tarihleri ve risk seviyelerinde bireysel sözleşmeleri çıkarır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;
// Analyze contract clauses and identify key terms, risks, and critical dates
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("contract.pdf");
// Define JSON schema for contract analysis
string clauseQuery = @"Analyze this contract and identify key clauses. Return JSON:
ntractType"": ""string"",
rties"": [""string""],
fectiveDate"": ""string"",
auses"": [
{
""type"": ""Termination|Liability|Indemnification|Confidentiality|IP|Payment|Warranty|Other"",
""title"": ""string"",
""summary"": ""string"",
""riskLevel"": ""Low|Medium|High"",
""keyTerms"": [""string""]
}
iticalDates"": [
{
""description"": ""string"",
""date"": ""string""
}
erallRiskAssessment"": ""Low|Medium|High"",
commendations"": [""string""]
: termination rights, liability caps, indemnification, IP ownership, confidentiality, payment terms.
NLY valid JSON.";
string analysisJson = await pdf.Query(clauseQuery);
try
{
var analysis = JsonSerializer.Deserialize<JsonElement>(analysisJson);
string formatted = JsonSerializer.Serialize(analysis, new JsonSerializerOptions { WriteIndented = true });
Console.WriteLine("Contract Clause Analysis:");
Console.WriteLine(formatted);
File.WriteAllText("contract-analysis.json", formatted);
// Display high-risk clauses
Console.WriteLine("\n=== High Risk Clauses ===");
foreach (var clause in analysis.GetProperty("clauses").EnumerateArray())
{
if (clause.GetProperty("riskLevel").GetString() == "High")
{
Console.WriteLine($"- {clause.GetProperty("type")}: {clause.GetProperty("summary")}");
}
}
}
catch (JsonException)
{
Console.WriteLine("Unable to parse contract analysis");
File.WriteAllText("contract-analysis-raw.txt", analysisJson);
}
```
Bu yetenek, sözleşme incelemesini sıralı ve manuel bir süreçten otomatik ve ölçeklenebilir bir iş akışına dönüştürür. Hukuk ekipleri, yüzlerce sözleşme arasında yüksek riskli hükümlerin hızlı bir şekilde tanımlayabilir.
### Finansal Veri Ayrıştırma
Finansal belgeler, karmaşık anlatılar ve tabloların içine gömülü kritik nicel veriler içerir. AI destekli ayrıştırma, finansal belgelerde mükemmeldir çünkü bağlamı anlar - tarihsel sonuçlar ve ileriye dönük projeksiyonlar arasındaki farkı ayırt eder, sayıların binlerce mi yoksa milyonlarca mı olduğunu belirler ve farklı metrikler arasındaki ilişkileri anlar.
Kod, mali JSON şeması ile `pdf.Query()` kullanarak gelir tablosu verilerini, bilanço ölçümlerini ve ileriye yönelik rehberliği yapılandırılmış çıktıya dönüştürür.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;
// Extract financial metrics from annual reports and earnings documents
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("annual-report.pdf");
// Define JSON schema for financial extraction (numbers in millions)
string financialQuery = @"Extract financial metrics from this document. Return JSON:
portPeriod"": ""string"",
mpany"": ""string"",
rrency"": ""string"",
comeStatement"": {
""revenue"": number,
""costOfRevenue"": number,
""grossProfit"": number,
""operatingExpenses"": number,
""operatingIncome"": number,
""netIncome"": number,
""eps"": number
lanceSheet"": {
""totalAssets"": number,
""totalLiabilities"": number,
""shareholdersEquity"": number,
""cash"": number,
""totalDebt"": number
yMetrics"": {
""revenueGrowthYoY"": ""string"",
""grossMargin"": ""string"",
""operatingMargin"": ""string"",
""netMargin"": ""string"",
""debtToEquity"": number
idance"": {
""nextQuarterRevenue"": ""string"",
""fullYearRevenue"": ""string"",
""notes"": ""string""
for unavailable data. Numbers in millions unless stated.
NLY valid JSON.";
string financialJson = await pdf.Query(financialQuery);
try
{
var financials = JsonSerializer.Deserialize<JsonElement>(financialJson);
string formatted = JsonSerializer.Serialize(financials, new JsonSerializerOptions { WriteIndented = true });
Console.WriteLine("Extracted Financial Data:");
Console.WriteLine(formatted);
File.WriteAllText("financial-data.json", formatted);
}
catch (JsonException)
{
Console.WriteLine("Unable to parse financial data");
File.WriteAllText("financial-raw.txt", financialJson);
}
```
Çıkarılan yapılandırılmış veriler, finansal modelleme, zaman serisi veritabanları veya analiz platformlarına doğrudan aktarılabilir ve raporlama dönemleri genelinde metriklerin otomatik takibini sağlar.
### Özel Çıkartma Komutları
Birçok kuruluşun, özel alanlarına, belge formatlarına veya iş süreçlerine dayalı olarak benzersiz çıkarım gereksinimleri vardır. IronPDF'in yapay zeka entegrasyonu, özel çıkarım istemlerini tam olarak destekleyerek hangi bilginin çıkarılması gerektiğini ve nasıl yapılandırılacağını tam olarak tanımlamanızı sağlar.
Bu örnek, akademik makalelerden methology, güven seviyeleri ile ana bulgular ve sınırlamalar çıkaran araştırma odaklı bir şema ile `pdf.Query()` kullanmayı gösterir.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;
// Extract structured research metadata from academic papers
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("research-paper.pdf");
// Define JSON schema for research paper extraction
string researchQuery = @"Extract structured information from this research paper. Return JSON:
tle"": ""string"",
thors"": [""string""],
stitution"": ""string"",
blicationDate"": ""string"",
stract"": ""string"",
searchQuestion"": ""string"",
thodology"": {
""type"": ""Quantitative|Qualitative|Mixed Methods"",
""approach"": ""string"",
""sampleSize"": ""string"",
""dataCollection"": ""string""
yFindings"": [
{
""finding"": ""string"",
""significance"": ""string"",
""confidence"": ""High|Medium|Low""
}
mitations"": [""string""],
tureWork"": [""string""],
ywords"": [""string""]
extracting verifiable claims and noting uncertainty.
NLY valid JSON.";
string extractionResult = await pdf.Query(researchQuery);
try
{
var research = JsonSerializer.Deserialize<JsonElement>(extractionResult);
string formatted = JsonSerializer.Serialize(research, new JsonSerializerOptions { WriteIndented = true });
Console.WriteLine("Research Paper Extraction:");
Console.WriteLine(formatted);
File.WriteAllText("research-extraction.json", formatted);
// Display key findings with confidence levels
Console.WriteLine("\n=== Key Findings ===");
foreach (var finding in research.GetProperty("keyFindings").EnumerateArray())
{
string confidence = finding.GetProperty("confidence").GetString() ?? "Unknown";
Console.WriteLine($"[{confidence}] {finding.GetProperty("finding")}");
}
}
catch (JsonException)
{
Console.WriteLine("Unable to parse research extraction");
File.WriteAllText("research-raw.txt", extractionResult);
}
```
Özel istemler, yapay zeka destekli çıkarımı genel bir araçtan, özel ihtiyaçlarınıza göre uyarlanmış özel bir çözüme dönüştürür.
---
## Belgelerde Soru-Cevap
### Bir PDF Soru-Cevap Sistemi Kurma
Soru-cevap sistemleri, kullanıcıların doğal dilde sorular sormasına ve doğru, bağlamlı cevaplar almasına olanak tanıyarak PDF belgeleriyle etkileşime geçmesini sağlar. Temel desen, PDF'den metin çıkarmayı, kullanıcı sorusuyla bir isteme entegre etmeyi ve yapay zekadan cevap istemeyi içerir.
#### Girdi
<iframe loading="lazy" src="/static-assets/pdf/tutorials/ai-powered-pdf-processing-csharp/sample-legal-document.pdf" width="100%" height="400px">
</iframe>
<br />
Kod, dokümanı semantik arama için `pdf.Memorize()` ile indeksler, ardından kullanıcı sorularını yanıtlamak için `pdf.Query()` ile etkileşimli bir döngü başlatır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
// Interactive Q&A system for querying PDF documents
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("sample-legal-document.pdf");
// Memorize document to enable persistent querying
await pdf.Memorize();
Console.WriteLine("PDF Q&A System - Type 'exit' to quit\n");
Console.WriteLine($"Document loaded and memorized: {pdf.PageCount} pages\n");
// Interactive Q&A loop
while (true)
{
Console.Write("Your question: ");
string? question = Console.ReadLine();
if (string.IsNullOrWhiteSpace(question) || question.ToLower() == "exit")
break;
string answer = await pdf.Query(question);
Console.WriteLine($"\nAnswer: {answer}\n");
Console.WriteLine(new string('-', 50) + "\n");
}
Console.WriteLine("Q&A session ended.");
```
<br />
#### Konsol Çıkış
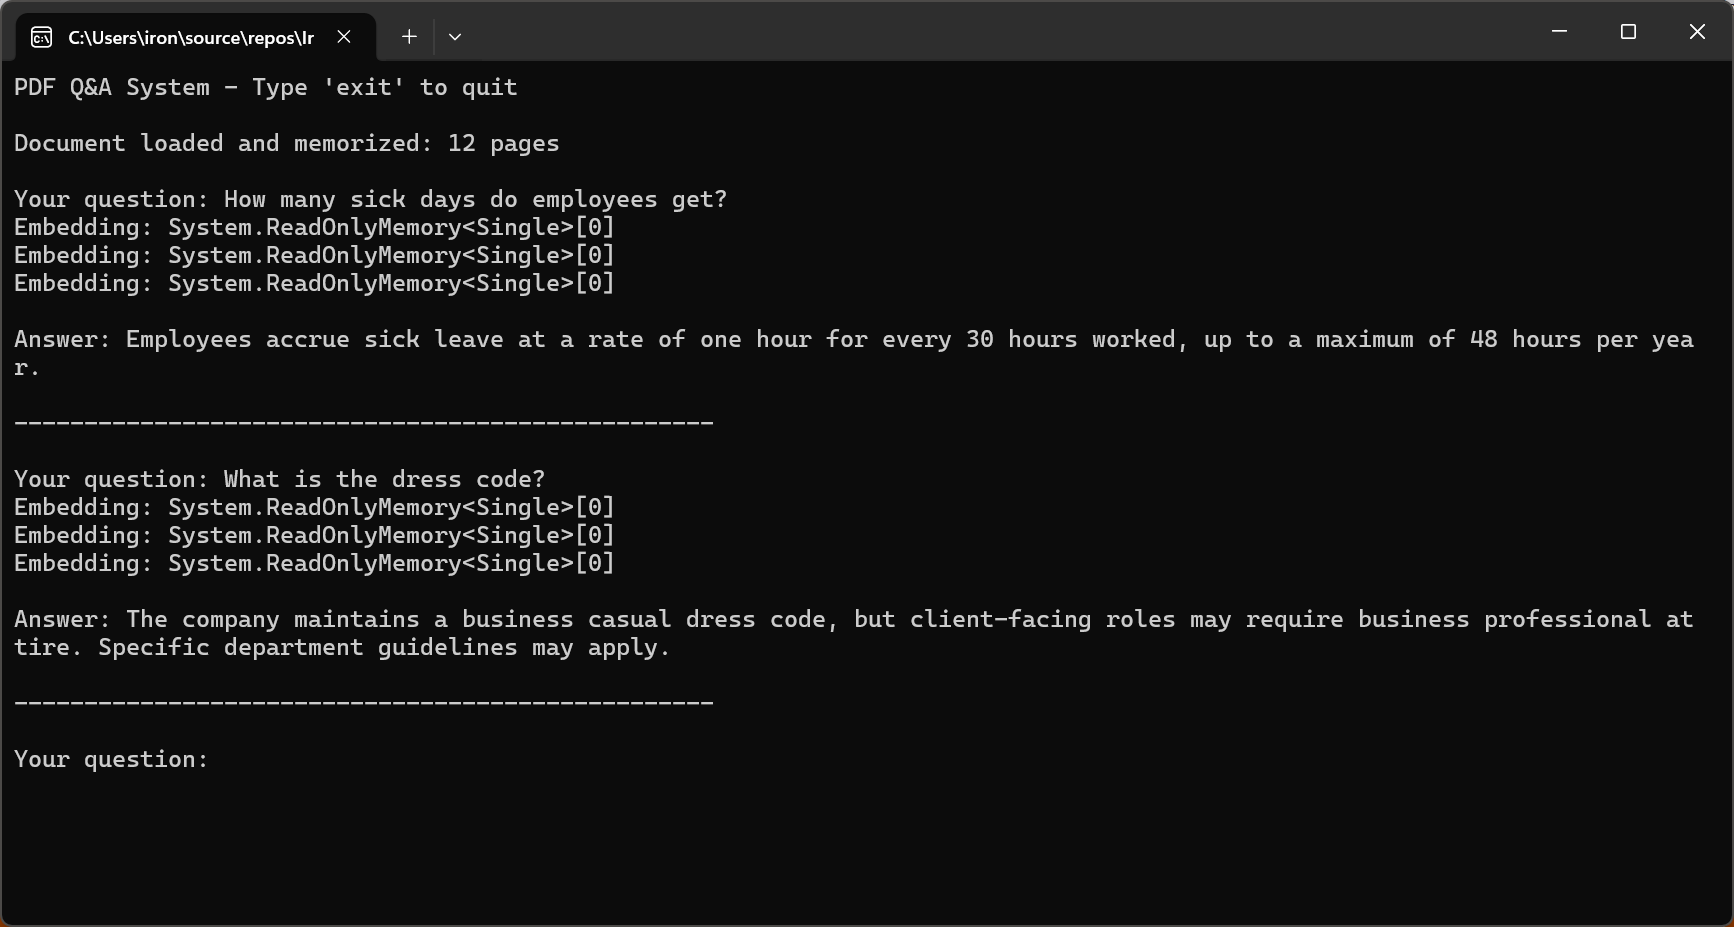
2026'da etkili soru-cevabın anahtarı, yapay zekayı yalnızca belge içeriğine dayalı cevap vermeye sınırlandırmaktır. GPT-5'in "güvenli tamamlamalar" eğitimi metodu ve Claude Sonnet 4.5'in geliştirilmiş hizalaması yanılsama oranlarını önemli ölçüde azaltır.
### Uzun Belgeleri Bağlam Pencerelerine Bölme
Gerçek dünya belgelerinin çoğu yapay zeka bağlam pencerelerini aşar. Bu belgelerin işlenmesi için etkili bölme stratejileri esastır. Bölme, belgeleri bağlam pencerelerine sığacak kadar küçük segmentlere bölerken anlamsal bütünlüğü korumayı içeren bir işlemdir.
Bu kod `pdf.Pages` üzerinden dolaşır, `DocumentChunk` nesnelerini yapılandırılabilir `maxChunkTokens` ve `overlapTokens` ile bağlam devamlılığı sağlamak için oluşturur.
```cs
using IronPdf;
// Split long documents into overlapping chunks for RAG systems
var pdf = PdfDocument.FromFile("long-document.pdf");
// Chunking configuration
int maxChunkTokens = 4000; // Leave room for prompts and responses
int overlapTokens = 200; // Overlap for context continuity
int approxCharsPerToken = 4; // Rough estimate for tokenization
int maxChunkChars = maxChunkTokens * approxCharsPerToken;
int overlapChars = overlapTokens * approxCharsPerToken;
var chunks = new List<DocumentChunk>();
var currentChunk = new System.Text.StringBuilder();
int chunkStartPage = 1;
int currentPage = 1;
for (int i = 0; i < pdf.PageCount; i++)
{
string pageText = pdf.Pages[i].Text;
currentPage = i + 1;
if (currentChunk.Length + pageText.Length > maxChunkChars && currentChunk.Length > 0)
{
chunks.Add(new DocumentChunk
{
Text = currentChunk.ToString(),
StartPage = chunkStartPage,
EndPage = currentPage - 1,
ChunkIndex = chunks.Count
});
// Create overlap with previous chunk for continuity
string overlap = currentChunk.Length > overlapChars
? currentChunk.ToString().Substring(currentChunk.Length - overlapChars)
: currentChunk.ToString();
currentChunk.Clear();
currentChunk.Append(overlap);
chunkStartPage = currentPage - 1;
}
currentChunk.AppendLine($"\n--- Page {currentPage} ---\n");
currentChunk.Append(pageText);
}
if (currentChunk.Length > 0)
{
chunks.Add(new DocumentChunk
{
Text = currentChunk.ToString(),
StartPage = chunkStartPage,
EndPage = currentPage,
ChunkIndex = chunks.Count
});
}
Console.WriteLine($"Document chunked into {chunks.Count} segments");
foreach (var chunk in chunks)
{
Console.WriteLine($" Chunk {chunk.ChunkIndex + 1}: Pages {chunk.StartPage}-{chunk.EndPage} ({chunk.Text.Length} chars)");
}
// Save chunk metadata for RAG indexing
File.WriteAllText("chunks-metadata.json", System.Text.Json.JsonSerializer.Serialize(
chunks.Select(c => new { c.ChunkIndex, c.StartPage, c.EndPage, Length = c.Text.Length }),
new System.Text.Json.JsonSerializerOptions { WriteIndented = true }
));
ic class DocumentChunk
public string Text { get; set; } = "";
public int StartPage { get; set; }
public int EndPage { get; set; }
public int ChunkIndex { get; set; }
```
<br />
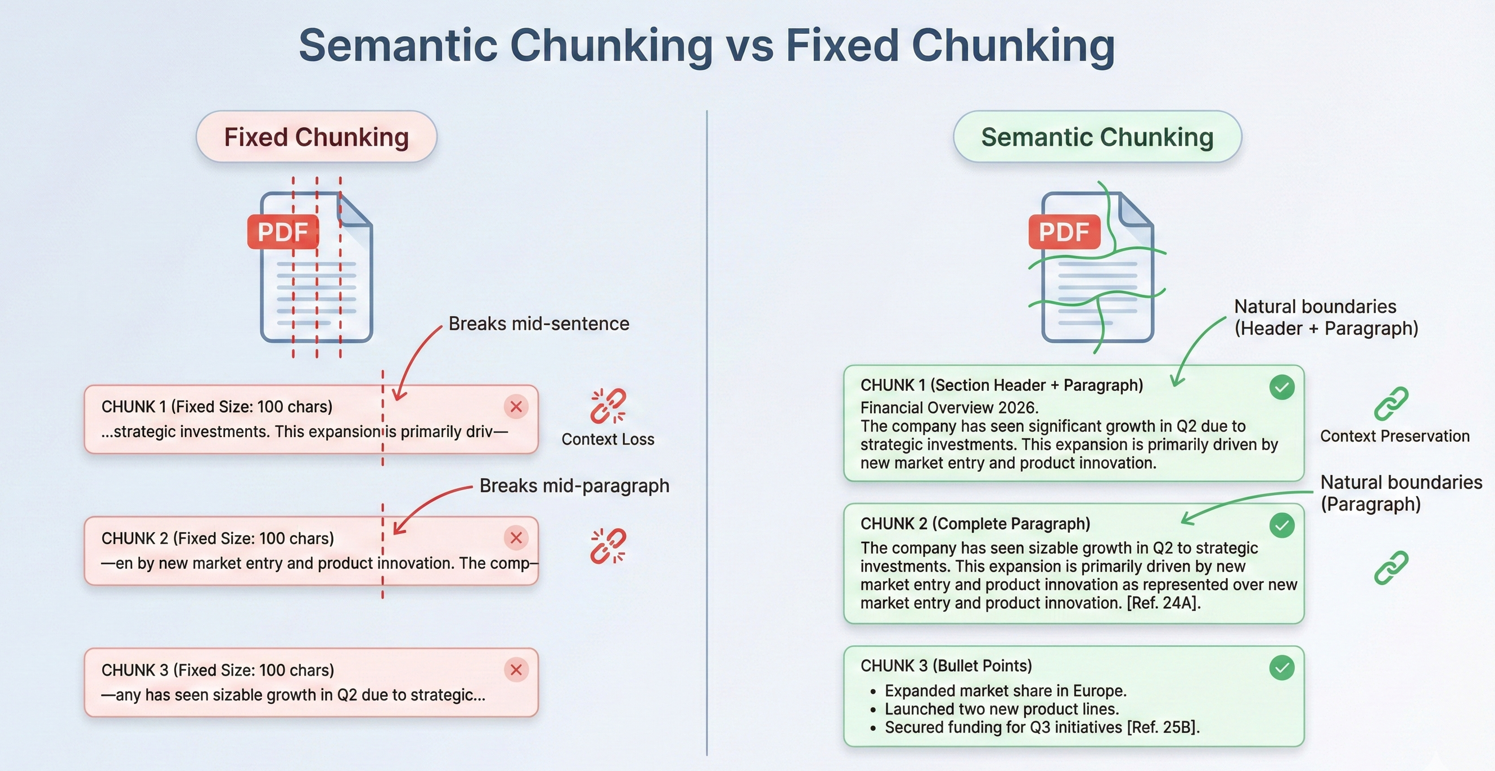
Çakışan parçalar, sınırlardan continuity sağlayarak, yapay zekanın ilgili bilgilerin parça sınırları boyunca yayıldığında bile yeterli bağlama sahip olmasını sağlar.
### RAG (Arama-Temelli Üretim) Desenleri
2026'da Yapay zeka destekli belge analizi için güçlü bir desen olan Arama-Temelli Üretim, belgelerin tamamını yapay zekaya vermektense sadece verilen bir sorgu için ilgili bölümleri önceden alır ve bu bölümleri cevap üretiminde bağlam olarak kullanır.
RAG iş akışı üç ana aşamaya sahiptir: belge hazırlama (bölme ve gömülen oluşturma), arama (ilgili parçaların aranması) ve üretim (yapay zeka yanıtları için bağlam olarak alınan parçaların kullanılması).
Kod `pdf.Memorize()` çağırarak birden çok PDF'i indeksler, ardından cevapları birleştirilmiş belge belleğinden almak için `pdf.Query()` kullanır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
// Retrieval-Augmented Generation (RAG) system for querying across multiple indexed documents
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Index all documents in folder
string[] documentPaths = Directory.GetFiles("documents/", "*.pdf");
Console.WriteLine($"Indexing {documentPaths.Length} documents...\n");
// Memorize each document (creates embeddings for retrieval)
foreach (string path in documentPaths)
{
var pdf = PdfDocument.FromFile(path);
await pdf.Memorize();
Console.WriteLine($"Indexed: {Path.GetFileName(path)} ({pdf.PageCount} pages)");
}
Console.WriteLine("\n=== RAG System Ready ===\n");
// Query across all indexed documents
string query = "What are the key compliance requirements for data retention?";
Console.WriteLine($"Query: {query}\n");
var searchPdf = PdfDocument.FromFile(documentPaths[0]);
string answer = await searchPdf.Query(query);
Console.WriteLine($"Answer: {answer}");
// Interactive query loop
Console.WriteLine("\n--- Enter questions (type 'exit' to quit) ---\n");
while (true)
{
Console.Write("Question: ");
string? userQuery = Console.ReadLine();
if (string.IsNullOrWhiteSpace(userQuery) || userQuery.ToLower() == "exit")
break;
string response = await searchPdf.Query(userQuery);
Console.WriteLine($"\nAnswer: {response}\n");
}
```
RAG sistemleri büyük belge koleksiyonlarını ele almada üstündür - hukuki dava veri tabanları, teknik dokümantasyon kütüphaneleri, araştırma arşivleri. Sadece ilgili parçaları alarak, cevap kalitesini korurken teorik olarak sınırsız belge boyutlarında etkili bir şekilde ölçeklenir.
### PDF Sayfalarından Kaynak Gösterme
Profesyonel uygulamalar için yapay zeka yanıtları doğrulanabilir olmalıdır. Kaynak gösterme yaklaşımı, bölme ve alma sırasında parça kökenleri hakkında meta verileri sağlamaktadır. Her parça, yalnızca metin içeriğini değil, aynı zamanda kaynak sayfa numaralarını, bölüm başlıklarını ve belgedeki konumunu da saklar.
#### Girdi
<iframe loading="lazy" src="/static-assets/pdf/tutorials/ai-powered-pdf-processing-csharp/sample-legal-document.pdf" width="100%" height="400px">
</iframe>
<br />
Kod, alıntı talimatları ile `pdf.Query()` kullanır, ardından regex ile sayfa referanslarını ayrıştırmak ve kaynakları doğrulamak için `ExtractCitedPages()` kullanır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.RegularExpressions;
// Answer questions with page citations and source verification
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
var pdf = PdfDocument.FromFile("sample-legal-document.pdf");
await pdf.Memorize();
string question = "What are the termination conditions in this agreement?";
// Request citations in query
string citationQuery = $@"{question}
T: Include specific page citations in your answer using the format (Page X) or (Pages X-Y).
e information that appears in the document.";
string answerWithCitations = await pdf.Query(citationQuery);
Console.WriteLine("Question: " + question);
Console.WriteLine("\nAnswer with Citations:");
Console.WriteLine(answerWithCitations);
// Extract cited page numbers using regex
var citedPages = ExtractCitedPages(answerWithCitations);
Console.WriteLine($"\nCited pages: {string.Join(", ", citedPages)}");
// Verify citations with page excerpts
Console.WriteLine("\n=== Source Verification ===");
foreach (int pageNum in citedPages.Take(3))
{
if (pageNum <= pdf.PageCount && pageNum > 0)
{
string pageText = pdf.Pages[pageNum - 1].Text;
string excerpt = pageText.Length > 200 ? pageText.Substring(0, 200) + "..." : pageText;
Console.WriteLine($"\nPage {pageNum} excerpt:\n{excerpt}");
}
}
// Extract page numbers from citation format (Page X) or (Pages X-Y)
List<int> ExtractCitedPages(string text)
{
var pages = new HashSet<int>();
var matches = Regex.Matches(text, @"\(Pages?\s*(\d+)(?:\s*-\s*(\d+))?\)", RegexOptions.IgnoreCase);
foreach (Match match in matches)
{
int startPage = int.Parse(match.Groups[1].Value);
pages.Add(startPage);
if (match.Groups[2].Success)
{
int endPage = int.Parse(match.Groups[2].Value);
for (int p = startPage; p <= endPage; p++)
pages.Add(p);
}
}
return pages.OrderBy(p => p).ToList();
}
```
<br />
#### Konsol Çıkış
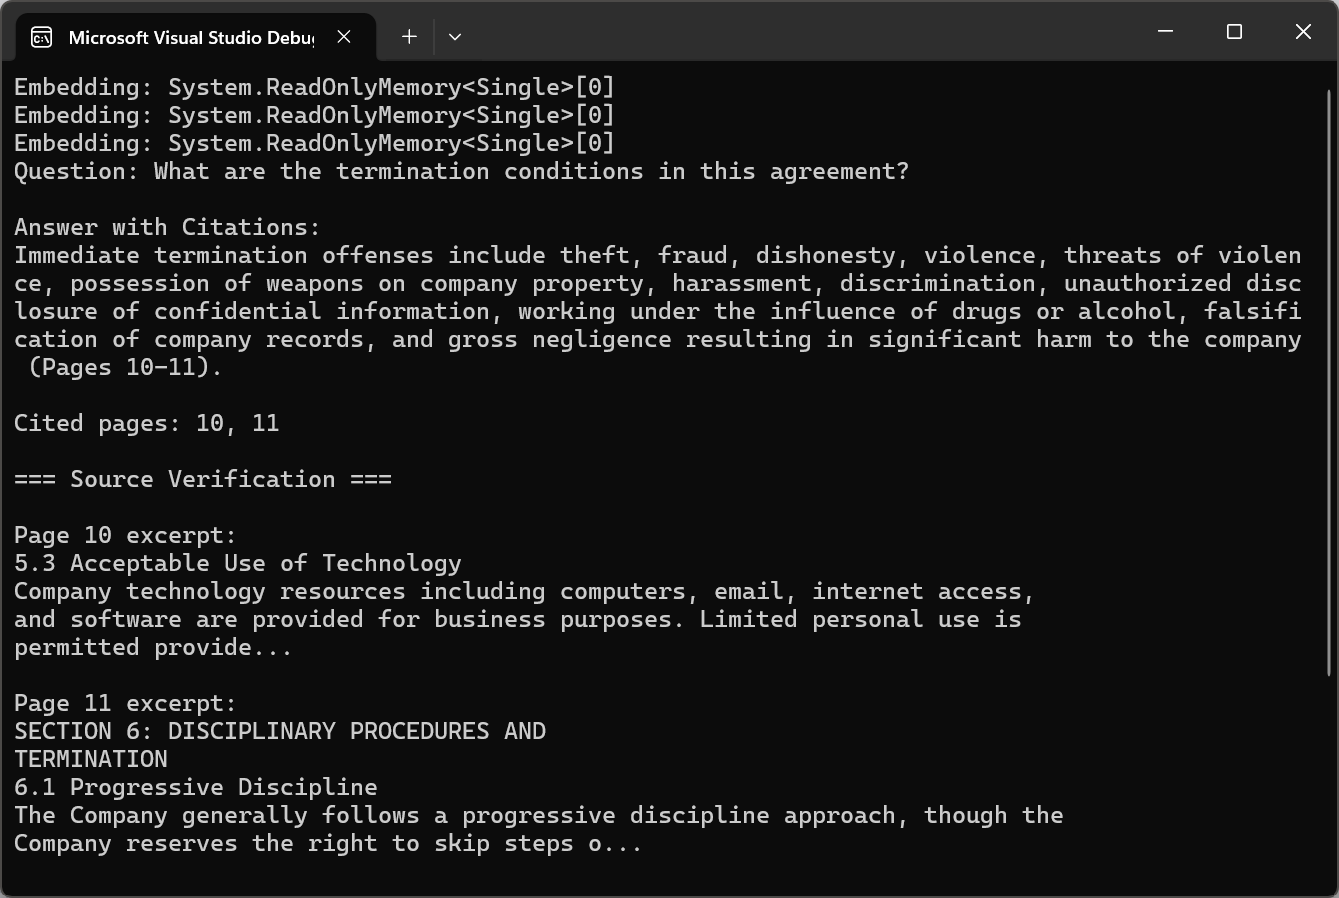
Kaynaklar, yapay zeka tarafından üretilen yanıtları opak çıktılardan şeffaf, doğrulanabilir bilgilere dönüştürür. Kullanıcılar kaynak materyali gözden geçirerek yanıtları doğrulamak ve yapay zeka destekli analize güven duymak için inceleyebilirler.
---
## Toplu Yapay Zeka İşleme
### Belge Kütüphanelerini Ölçekte İşleme
Kurumsal belge işlemi genellikle binlerce veya milyonlarca PDF'yi kapsar. Ölçeklenebilir toplu işlemenin temeli paralelleştirmedir. IronPDF, eşzamanlı PDF işlemiyle çapraz etkileşime izin veren thread-safe'tir.
Bu kod, `SemaphoreSlim` yapılandırılabilir `maxConcurrency` ile çoklu işleme yaparak her birini `pdf.Summarize()`'e çağırır ve sonuçları `ConcurrentBag` ile takip eder.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System;
using System.Collections.Concurrent;
using System.Text;
// Process multiple documents in parallel with rate limiting
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Configure parallel processing with rate limiting
int maxConcurrency = 3;
string inputFolder = "documents/";
string outputFolder = "summaries/";
Directory.CreateDirectory(outputFolder);
string[] pdfFiles = Directory.GetFiles(inputFolder, "*.pdf");
Console.WriteLine($"Processing {pdfFiles.Length} documents...\n");
var results = new ConcurrentBag<ProcessingResult>();
var semaphore = new SemaphoreSlim(maxConcurrency);
var tasks = pdfFiles.Select(async filePath =>
{
await semaphore.WaitAsync();
var result = new ProcessingResult { FilePath = filePath };
try
{
var stopwatch = System.Diagnostics.Stopwatch.StartNew();
var pdf = PdfDocument.FromFile(filePath);
string summary = await pdf.Summarize();
string outputPath = Path.Combine(outputFolder,
Path.GetFileNameWithoutExtension(filePath) + "-summary.txt");
await File.WriteAllTextAsync(outputPath, summary);
stopwatch.Stop();
result.Success = true;
result.ProcessingTime = stopwatch.Elapsed;
result.OutputPath = outputPath;
Console.WriteLine($"[OK] {Path.GetFileName(filePath)} ({stopwatch.ElapsedMilliseconds}ms)");
}
catch (Exception ex)
{
result.Success = false;
result.ErrorMessage = ex.Message;
Console.WriteLine($"[ERROR] {Path.GetFileName(filePath)}: {ex.Message}");
}
finally
{
semaphore.Release();
results.Add(result);
}
}).ToArray();
await Task.WhenAll(tasks);
// Generate processing report
var successful = results.Where(r => r.Success).ToList();
var failed = results.Where(r => !r.Success).ToList();
var report = new StringBuilder();
report.AppendLine("=== Batch Processing Report ===");
report.AppendLine($"Successful: {successful.Count}");
report.AppendLine($"Failed: {failed.Count}");
if (successful.Any())
{
var avgTime = TimeSpan.FromMilliseconds(successful.Average(r => r.ProcessingTime.TotalMilliseconds));
report.AppendLine($"Average processing time: {avgTime.TotalSeconds:F1}s");
}
if (failed.Any())
{
report.AppendLine("\nFailed documents:");
foreach (var fail in failed)
report.AppendLine($" - {Path.GetFileName(fail.FilePath)}: {fail.ErrorMessage}");
}
string reportText = report.ToString();
Console.WriteLine($"\n{reportText}");
File.WriteAllText(Path.Combine(outputFolder, "processing-report.txt"), reportText);
s ProcessingResult
public string FilePath { get; set; } = "";
public bool Success { get; set; }
public TimeSpan ProcessingTime { get; set; }
public string OutputPath { get; set; } = "";
public string ErrorMessage { get; set; } = "";
```
Ölçekte sağlam hata yönetimi kritiktir. Üretim sistemleri, üstel geri dönüşlerle yeniden deneme mantığı uygular, başarısız belgeler için ayrı hata kaydı yapar ve devam ettirilebilir proses sağlar.
### Maliyet Yönetimi ve Jeton Kullanımı
Yapay zeka API maliyetleri tipik olarak her jeton başına hesaplanır. 2026'da GPT-5, her milyon giriş jetonu için 1,25 $ ve her milyon çıkış jetonu için 10 $ ücretlendirilirken, Claude Sonnet 4.5 ise her milyon giriş jetonu için 3 $ ve her milyon çıkış jetonu için 15 $ maliyetindedir. Birincil maliyet optimizasyon stratejisi gereksiz jeton kullanımını en aza indirmektir.
OpenAI'in Batch API'si, işlem süreleri karşılığında (24 saate kadar) jeton maliyetlerinde %50 indirim sunar. Gecelik işlemler veya dönemsel analizler için toplu işlem önemli tasarruflar sağlar.
Kod `pdf.ExtractAllText()` kullanarak metni çıkarır, JSONL toplu istekler oluşturur, OpenAI dosya uç noktasına `HttpClient` ile yükler ve toplu API'ye gönderir.
```cs
using IronPdf;
using System.Text.Json;
using System.Net.Http.Headers;
// Use OpenAI Batch API for 50% cost savings on large-scale document processing
string openAiApiKey = "your-openai-api-key";
string inputFolder = "documents/";
// Prepare batch requests in JSONL format
var batchRequests = new List<string>();
string[] pdfFiles = Directory.GetFiles(inputFolder, "*.pdf");
Console.WriteLine($"Preparing batch for {pdfFiles.Length} documents...\n");
foreach (string filePath in pdfFiles)
{
var pdf = PdfDocument.FromFile(filePath);
string pdfText = pdf.ExtractAllText();
// Truncate to stay within batch API limits
if (pdfText.Length > 100000)
pdfText = pdfText.Substring(0, 100000) + "\n[Truncated...]";
var request = new
{
custom_id = Path.GetFileNameWithoutExtension(filePath),
method = "POST",
url = "/v1/chat/completions",
body = new
{
model = "gpt-4o",
messages = new[]
{
new { role = "system", content = "Summarize the following document concisely." },
new { role = "user", content = pdfText }
},
max_tokens = 1000
}
};
batchRequests.Add(JsonSerializer.Serialize(request));
}
// Create JSONL file
string batchFilePath = "batch-requests.jsonl";
File.WriteAllLines(batchFilePath, batchRequests);
Console.WriteLine($"Created batch file with {batchRequests.Count} requests");
// Upload file to OpenAI
using var httpClient = new HttpClient();
httpClient.DefaultRequestHeaders.Authorization = new AuthenticationHeaderValue("Bearer", openAiApiKey);
using var fileContent = new MultipartFormDataContent();
fileContent.Add(new ByteArrayContent(File.ReadAllBytes(batchFilePath)), "file", "batch-requests.jsonl");
fileContent.Add(new StringContent("batch"), "purpose");
var uploadResponse = await httpClient.PostAsync("https://api.openai.com/v1/files", fileContent);
var uploadResult = JsonSerializer.Deserialize<JsonElement>(await uploadResponse.Content.ReadAsStringAsync());
string fileId = uploadResult.GetProperty("id").GetString()!;
Console.WriteLine($"Uploaded file: {fileId}");
// Create batch job (24-hour completion window for 50% discount)
var batchJobRequest = new
{
input_file_id = fileId,
endpoint = "/v1/chat/completions",
completion_window = "24h"
};
var batchResponse = await httpClient.PostAsync(
"https://api.openai.com/v1/batches",
new StringContent(JsonSerializer.Serialize(batchJobRequest), System.Text.Encoding.UTF8, "application/json")
);
var batchResult = JsonSerializer.Deserialize<JsonElement>(await batchResponse.Content.ReadAsStringAsync());
string batchId = batchResult.GetProperty("id").GetString()!;
Console.WriteLine($"\nBatch job created: {batchId}");
Console.WriteLine("Job will complete within 24 hours");
Console.WriteLine($"Check status: GET https://api.openai.com/v1/batches/{batchId}");
File.WriteAllText("batch-job-id.txt", batchId);
Console.WriteLine("\nBatch ID saved to batch-job-id.txt");
```
Üretimde jeton kullanımını izlemek esastır. Birçok kuruluş, belgelerinin %80'inin daha küçük, daha ucuz modellerle işlenebileceğini, pahalı modellerin yalnızca karmaşık durumlar için ayrılabileceğini keşfeder.
### Önbellekleme ve Artımlı İşleme
Artımlı olarak güncellenen belge koleksiyonları için, zekice önbellekleme ve artımlı işleme stratejileri maliyetleri dramatik bir şekilde azaltır. Belge düzeyinde önbellekleme, değiştirilmemiş belgelerin gereksiz yeniden işlenmesini önleyerek, sonuçları kaynağın PDF'siyle birlikte bir karma olarak saklar.
`DocumentCacheManager` sınıfı `ComputeFileHash()` ile SHA256 kullanarak değişiklikleri algılar, sonuçları `CacheEntry` nesnelerine `LastAccessed` zaman damgaları ile depolar.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System;
using System.Collections.Generic;
using System.Security.Cryptography;
using System.Text.Json;
// Cache AI processing results using file hashes to avoid reprocessing unchanged documents
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Configure caching
string cacheFolder = "ai-cache/";
string documentsFolder = "documents/";
Directory.CreateDirectory(cacheFolder);
var cacheManager = new DocumentCacheManager(cacheFolder);
// Process documents with caching
string[] pdfFiles = Directory.GetFiles(documentsFolder, "*.pdf");
int cached = 0, processed = 0;
foreach (string filePath in pdfFiles)
{
string fileName = Path.GetFileName(filePath);
string fileHash = cacheManager.ComputeFileHash(filePath);
var cachedResult = cacheManager.GetCachedResult(fileName, fileHash);
if (cachedResult != null)
{
Console.WriteLine($"[CACHE HIT] {fileName}");
cached++;
continue;
}
Console.WriteLine($"[PROCESSING] {fileName}");
var pdf = PdfDocument.FromFile(filePath);
string summary = await pdf.Summarize();
cacheManager.CacheResult(fileName, fileHash, summary);
processed++;
}
Console.WriteLine($"\nProcessing complete: {cached} cached, {processed} newly processed");
Console.WriteLine($"Cost savings: {(cached * 100.0 / Math.Max(1, cached + processed)):F1}% served from cache");
ash-based cache manager with JSON index
s DocumentCacheManager
private readonly string _cacheFolder;
private readonly string _indexPath;
private Dictionary<string, CacheEntry> _index;
public DocumentCacheManager(string cacheFolder)
{
_cacheFolder = cacheFolder;
_indexPath = Path.Combine(cacheFolder, "cache-index.json");
_index = LoadIndex();
}
private Dictionary<string, CacheEntry> LoadIndex()
{
if (File.Exists(_indexPath))
{
string json = File.ReadAllText(_indexPath);
return JsonSerializer.Deserialize<Dictionary<string, CacheEntry>>(json) ?? new();
}
return new Dictionary<string, CacheEntry>();
}
private void SaveIndex()
{
string json = JsonSerializer.Serialize(_index, new JsonSerializerOptions { WriteIndented = true });
File.WriteAllText(_indexPath, json);
}
// SHA256 hash to detect file changes
public string ComputeFileHash(string filePath)
{
using var sha256 = SHA256.Create();
using var stream = File.OpenRead(filePath);
byte[] hash = sha256.ComputeHash(stream);
return Convert.ToHexString(hash);
}
public string? GetCachedResult(string fileName, string currentHash)
{
if (_index.TryGetValue(fileName, out var entry))
{
if (entry.FileHash == currentHash && File.Exists(entry.CachePath))
{
entry.LastAccessed = DateTime.UtcNow;
SaveIndex();
return File.ReadAllText(entry.CachePath);
}
}
return null;
}
public void CacheResult(string fileName, string fileHash, string result)
{
string cachePath = Path.Combine(_cacheFolder, $"{Path.GetFileNameWithoutExtension(fileName)}-{fileHash[..8]}.txt");
File.WriteAllText(cachePath, result);
_index[fileName] = new CacheEntry
{
FileHash = fileHash,
CachePath = cachePath,
CreatedAt = DateTime.UtcNow,
LastAccessed = DateTime.UtcNow
};
SaveIndex();
}
s CacheEntry
public string FileHash { get; set; } = "";
public string CachePath { get; set; } = "";
public DateTime CreatedAt { get; set; }
public DateTime LastAccessed { get; set; }
```
2026'da GPT-5 ve Claude Sonnet 4.5 ayrıca tekrar eden kalıplar için etkili jeton tüketimini %50-90 oranında azaltabilen otomatik istem önbellekleme özelliğine de sahiptir. Bu, büyük ölçekli operasyonlar için önemli bir maliyet tasarrufudur.
---
## Gerçek Dünyada Kullanım Durumları
### Hukuki Keşif ve Sözleşme Analizi
Hukuki keşif, geleneksel olarak yüz binlerce sayfayı manuel olarak inceleyen junior avukatlar gerektirir. Yapay zeka destekli keşif bu süreci dönüştürerek ilgili belgelerin hızlı bir şekilde tanımlanmasını, otomatik ayrıcalık incelemesini ve önemli delilsel gerçeklerin çıkarılmasını sağlar.
IronPDF'in AI entegrasyonu, ayrıcalık tespiti, önem derecelendirmesi, sorun tanımlama ve kilit tarih çıkarımı gibi sofistike hukuki iş akışlarına imkan tanır. Hukuk firmaları keşif inceleme sürelerini %70-80 oranında azaltarak daha büyük davaları daha küçük ekiplerle ele alabilmektedir.
2026'da gelişmiş doğruluk ve azalmış yanılsama oranlarıyla GPT-5 ve Claude Sonnet 4.5, hukuk profesyonellerinin giderek daha kritik kararlar için yapay zeka destekli analize güvenmelerini sağlar.
### Finansal Rapor Analizi
Finansal analistler kazanç raporları, SEC belgeleri ve analiz sunumlarından veri çıkarmak için büyük zaman harcarlar. Yapay zeka destekli finansal belge işleme bu çıkarmayı otomatikleştirerek analistlerin veri toplama yerine yoruma odaklanmasını sağlar.
Bu örnek, birden fazla 10-K dokümanını işleyerek `pdf.Query()` kullanır ve `CompanyFinancials` JSON şeması ile şirketler arasında gelir, marjlar ve risk faktörlerini çıkarır ve karşılaştırır.
```cs
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Collections.Generic;
using System.Text.Json;
using System.Text;
// Compare financial metrics across multiple company filings for sector analysis
// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";
// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
.AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
.Build();
var memory = new MemoryBuilder()
.WithMemoryStore(new VolatileMemoryStore())
.WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
.Build();
IronDocumentAI.Initialize(kernel, memory);
// Analyze company filings
string[] companyFilings = {
"filings/company-a-10k.pdf",
"filings/company-b-10k.pdf",
"filings/company-c-10k.pdf"
};
var sectorData = new List<CompanyFinancials>();
foreach (string filing in companyFilings)
{
Console.WriteLine($"Analyzing: {Path.GetFileName(filing)}");
var pdf = PdfDocument.FromFile(filing);
// Define JSON schema for 10-K extraction (numbers in millions USD)
string extractionQuery = @"Extract key financial metrics from this 10-K filing. Return JSON:
mpanyName"": ""string"",
scalYear"": ""string"",
venue"": number,
venueGrowth"": number,
ossMargin"": number,
eratingMargin"": number,
tIncome"": number,
s"": number,
talDebt"": number,
shPosition"": number,
ployeeCount"": number,
yRisks"": [""string""],
idance"": ""string""
in millions USD. Growth/margins as percentages.
NLY valid JSON.";
string result = await pdf.Query(extractionQuery);
try
{
var financials = JsonSerializer.Deserialize<CompanyFinancials>(result);
if (financials != null)
sectorData.Add(financials);
}
catch
{
Console.WriteLine($" Warning: Could not parse financials for {filing}");
}
}
// Generate sector comparison report
var report = new StringBuilder();
report.AppendLine("=== Sector Analysis Report ===\n");
report.AppendLine("Revenue Comparison (millions USD):");
foreach (var company in sectorData.OrderByDescending(c => c.Revenue))
report.AppendLine($" {company.CompanyName}: ${company.Revenue:N0} ({company.RevenueGrowth:+0.0;-0.0}% YoY)");
report.AppendLine("\nProfitability Margins:");
foreach (var company in sectorData.OrderByDescending(c => c.OperatingMargin))
report.AppendLine($" {company.CompanyName}: {company.GrossMargin:F1}% gross, {company.OperatingMargin:F1}% operating");
report.AppendLine("\nFinancial Health (Debt vs Cash):");
foreach (var company in sectorData)
{
double netDebt = company.TotalDebt - company.CashPosition;
string status = netDebt < 0 ? "Net Cash" : "Net Debt";
report.AppendLine($" {company.CompanyName}: {status} ${Math.Abs(netDebt):N0}M");
}
string reportText = report.ToString();
Console.WriteLine($"\n{reportText}");
File.WriteAllText("sector-analysis-report.txt", reportText);
// Save full JSON data
string outputJson = JsonSerializer.Serialize(sectorData, new JsonSerializerOptions { WriteIndented = true });
File.WriteAllText("sector-analysis.json", outputJson);
Console.WriteLine("Analysis saved to sector-analysis.json and sector-analysis-report.txt");
s CompanyFinancials
public string CompanyName { get; set; } = "";
public string FiscalYear { get; set; } = "";
public double Revenue { get; set; }
public double RevenueGrowth { get; set; }
public double GrossMargin { get; set; }
public double OperatingMargin { get; set; }
public double NetIncome { get; set; }
public double Eps { get; set; }
public double TotalDebt { get; set; }
public double CashPosition { get; set; }
public int EmployeeCount { get; set; }
public List<string> KeyRisks { get; set; } = new();
public string Guidance { get; set; } = "";
```
Yatırım firmaları, analistlerin daha geniş piyasa kapsama alanını izlemesine ve ortaya çıkan fırsatlara daha hızlı yanıt vermelerine olanak tanıyan AI destekli analizi kullanarak her gün binlerce belgesini işleyebilir.
### Araştırma Makalesi Özeti
Akademik araştırmalar her yıl milyonlarca makale üretir. Yapay zeka destekli özetleme, araştırmacıların makale önemini hızla değerlendirmelerine, anahtar bulguları anlamalarına ve detaylı okumayı gerektiren makaleleri tanımlamalarına yardımcı olur. Etkili araştırma özeti, araştırma sorusunu tanımlamalı, metodolojiyi açıklamalı, uygun uyarılarla birlikte anahtar bulguları özetlemeli ve sonuçları bağlam içinde yerleştirmelidir.
Araştırma kurumları, kurumsal bilgi tabanlarını sürdürmek, yeni yayınları otomatik olarak işlemek için AI özetlemesini kullanır. 2026'da GPT-5'in geliştirilmiş bilimsel muhakemesi ve Claude Sonnet 4.5'in geliştirilmiş analitik yetenekleriyle, akademik özetleme yeni doğruluk seviyelerine ulaşır.
### Hükümet Belgesi İşleme
Hükümet kurumları düzenlemeler, kamu yorumları, çevresel etki beyanları, dava dosyaları ve denetim raporları gibi devasa belge koleksiyonları üretir. AI destekli belge işleme, düzenleyici uyum analizi, çevresel etki değerlendirmesi ve yasama takibi yoluyla hükümet bilgilerinin harekete geçirilebilir hale gelmesini sağlar.
Kamusal yorum analizi, benzersiz zorluklar sunar - büyük düzenleyici öneriler yüz binlerce yorum alabilir. Yapay zeka sistemleri, yorumları konuya göre kategorize edebilir, ortak temaları belirleyebilir, koordineli kampanyaları tespit edebilir ve kurum yanıtını gerektiren özlü argümanları çıkarabilir.
2026 yapay zeka modelleri nesli, hükümet belgesi işlemeye benzersiz yetenekler getirerek demokratik şeffaflığı ve bilgili politika yapımını destekler.
---
## Hata Ayıklama ve Teknik Destek
### Yaygın Hatalar Üzerinde Hızlı Çözümler
- **Yavaş ilk render mı?** Normal. Chrome 2-3 saniyede başlatılır, sonra hızlanır.
- **Bulut sorunları mı?** En azından Azure B1 veya eşdeğer kaynakları kullanın.
- **Eksik varlıklar mı?** Temel yolları ayarlayın veya base64 olarak yerleştirin.
- **Eksik öğeler mi?** JavaScript yürütümü için RenderDelay ekleyin.
- **Bellek sorunları mı?** Performans düzeltmeleri için en son IronPDF sürümüne güncelleyin.
- **Form alanı sorunları mı?** Benzersiz adlar sağlayın ve en son sürüme güncelleyin.
### IronPDF'i Geliştiren Mühendislerden 7/24 Yardım Alın
IronPDF, 7/24 mühendis desteği sunar. HTML'den PDF'e dönüştürme veya yapay zeka entegrasyonu ile ilgili sorun mu yaşıyorsunuz? Bizimle iletişime geçin:
- [Kapsamlı hata ayıklama kılavuzu](https://ironpdf.com/troubleshooting/)
- [Performans optimizasyon stratejileri](https://ironpdf.com/troubleshooting/ironpdf-performance-assistance/)
- [Mühendislik destek istekleri](https://ironpdf.com/troubleshooting/engineering-request-pdf/)
- [Hızlı hata ayıklama kontrol listesi](https://ironpdf.com/troubleshooting/quick-ironpdf-troubleshooting/)
---
## Sonraki Adımlar
Yapay zeka güçlendirilmiş PDF işlemesini anladığınıza göre, bir sonraki adım IronPDF'in daha geniş yeteneklerini keşfetmektir. [OpenAI entegrasyon kılavuzu](https://ironpdf.com/how-to/openai/), özetleme, sorgulama ve ezberleme desenleri hakkında derinlemesine bilgi sağlarken, [metin ve resim çıkarma eğitimi](https://ironpdf.com/how-to/extract-text-and-images/) PDF'leri yapay zeka analiz öncesi nasıl ön işleyeceğinizi gösterir. Belge montaj iş akışları için toplu işleme için PDF'leri [birleştirme ve ayırmayı öğrenin](https://ironpdf.com/how-to/merge-or-split-pdfs/).
AI özelliklerinin ötesine geçmeye hazır olduğunuzda, [tam PDF düzenleme eğitimi](https://ironpdf.com/tutorials/csharp-edit-pdf-complete-tutorial/) su damgası, üstbilgi, altbilgi, formlar ve not eklemeler kapsamaktadır. Alternatif yapay zeka entegrasyon yaklaşımları için, [ChatGPT C# eğitimi](https://ironpdf.com/blog/using-ironpdf/chatgpt-csharp-tutorial/) farklı desenleri gösterir. Üretim dağıtımı, WebApps ve Fonksiyonlar için [Azure dağıtım kılavuzunda](https://ironpdf.com/troubleshooting/azure/) ve HTML, URL'ler ve ham içerikten PDF oluşturmayı kapsayan [C# PDF oluşturma eğitimi](https://ironpdf.com/how-to/create-new-pdfs/)nde ele alınır.
Başlamaya hazır mısınız? [Ücretsiz 30 günlük denemenizi başlatın](https://ironpdf.com/licensing/) Üretimde su damgaları olmadan test etmek için esnek lisanslama ile ekibinizle ölçeklenir. Yapay zeka entegrasyonu veya herhangi bir IronPDF özelliği ile ilgili sorularınız için [mühendislik destek ekibimiz](https://ironpdf.com/troubleshooting/engineering-request-pdf/) size yardımcı olmaktadır.
Yapay Zeka destekli PDF işleme IronPDF ile C# kullanarak .NET geliştiricileri, mevcut PDF iş akışlarının üzerinde belge özetlemesi, yapılandırılmış verilerin çıkarılması ve soru-cevap sistemleri oluşturma imkanı sunar. Bu, topluluk temelli Microsoft Semantic Kernel üzerine inşa edilen IronPdf.Extensions.AI paketi aracılığıyla gerçekleştirilir ve Azure OpenAI ve OpenAI modelleri ile sorunsuz birliktelik sağlar. İster yasal keşif araçları, ister finansal analiz hatları, ister belge zekası platformları inşa edin, IronPDF PDF çıkarma ve bağlam hazırlığını yönetir, böylece AI mantığına odaklanabilirsiniz.
Kısa-Özet: Hızlı Başlangıç Kılavuzu
Bu eğitim, C# .NET'te doküman özetleme, veri çıkartma ve akıllı sorgulama için IronPDF'nin AI hizmetlerine nasıl bağlanacağını ele alır.
Kimin için: Geliştiriciler, yasal keşif sistemleri, finansal analiz araçları, uyumluluk inceleme platformları veya büyük hacimli PDF dokümanlarından anlam çıkarması gereken her türlü uygulamayı inşa eden .NET geliştiricileri.
Ne inşa edeceksiniz: Tek doküman özetleme, özel şemalarla yapılandırılmış JSON veri çıkartma, doküman içeriği üzerinde soru-cevap, uzun dokümanlar için RAG hatları ve belge kütüphaneleri genelinde toplu AI işleme iş akışları.
Nerede çalışır: .NET 6+ ortamında Azure OpenAI veya OpenAI API anahtarına sahip herhangi bir yerde. AI uzantısı Microsoft Semantic Kernel ile entegre olur ve bağlam pencere yönetimi, bölümlendirme ve orkestrasyonu otomatik olarak yönetir.
Bu yaklaşımı ne zaman kullanılmalıdır: Uygulamanızın PDF'leri metin çıkarmanın ötesinde işlemesi gerektiğinde - sözleşme yükümlülüklerini anlamak, araştırma makalelerini özetlemek, finansal tabloları yapılandırılmış veriler olarak çıkarmak veya ölçekli bir şekilde doküman içeriği hakkında kullanıcı sorularını yanıtlamak.
Teknik açıdan neden önemlidir: Ham metin çıkartımı doküman yapısını kaybeder – tablolar karışık hale gelir, çok sütunlu düzenler anlamsız olur ve bölümler arasındaki anlamsal ilişkiler kaybolur. IronPDF, belgeleri yapısını koruyarak ve token sınırlarını yöneterek AI tüketimi için hazırlar, bu yüzden model düzenli, iyi organize edilmiş giriş alır.
Neden PDF'ler En Büyük Kullanılmamış Veri Kaynağıdır?
PDF'ler, modern işletmelerdeki yapılandırılmış iş bilgisinin en büyük deposunu temsil eder. Profesyonel belgeler - sözleşmeler, finansal beyanlar, uyum raporları, yasal özetler ve araştırma makaleleri - ağırlıklı olarak PDF formatında saklanmaktadır. Bu belgeler kritik iş zekası içerir: yükümlülük ve sorumlulukları tanımlayan sözleşme şartları, yatırım kararlarını yönlendiren finansal metrikler, uyumu sağlayan yasal gereklilikler ve strateji yönlendiren araştırma bulguları.
Ancak PDF işlemeye yönelik geleneksel yaklaşımlar ciddi şekilde sınırlıdır. Temel metin çıkartma araçları bir sayfadan ham karakterler çıkarabilir, ancak önemli bağlamı kaybederler: tablo yapıları karışık metne dönüşür, çok sütunlu düzenler anlamsız hale gelir ve bölümler arasındaki anlamsal ilişkiler kaybolur.
Kırılma noktası, AI'ın bağlamı ve yapıyı anlama yeteneğinden gelir. Modern LLM'ler sadece kelimeleri değil, aynı zamanda dokümanların organizasyonunu da anlar, sözleşme maddeleri veya finansal tablolar gibi desenleri tanır ve karmaşık düzenlerden bile anlam çıkarabilir. GPT-5'in gerçek zamanlı yönlendiriciye sahip birleşik muhakeme sistemi ve Claude Sonnet 4.5'in geliştirilmiş ajan becerileri, önceki modellere kıyasla önemli ölçüde azaltılmış halüsinasyon oranları göstererek, profesyonel doküman analizi için güvenilir hale getirmektedir.
LLM'ler Belge Yapısını Nasıl Anlar?
Büyük dil modelleri, PDF analizine gelişmiş doğal dil işleme yetenekleri getirir. GPT-5'in hibrit yapıları, görev karmaşıklığına dayalı olarak dinamik bir şekilde en uygun varyantı seçen gerçek zamanlı bir yönlendirici ile ana, mini, düşünme ve nano adlı birçok alt-model içerir – basit sorular daha hızlı modellere yönendirilirken, karmaşık muhakeme görevleri tam modeli kullanır.
Claude Opus 4.6, özellikle uzun süreli ajans görevlerinde mükemmeldir, bölümlere ayrılmış işlerde doğrudan koordine olan ajan ekipleri ve tüm doküman kütüphanelerini parçalamadan işleyebilen 1M-token bağlam penceresi ile.
Bu bağlamsal anlama, LLM'lerin gerçek anlamaya ihtiyaç duyan görevleri gerçekleştirmesini sağlar. Bir sözleşmeyi analiz ederken, bir LLM sadece "fesih" kelimesini içeren maddeleri değil, fesihin hangi koşullar altında izin verildiğini, gerekli bildirim gereksinimlerini ve sonuçta ortaya çıkan yükümlülükleri de anlar. Bu yeteneği sağlayan teknik temel, modern LLM'leri destekleyen transformer mimarisi olup, GPT-5'in bağlam penceresi 272.000 giriş tokens desteği sağlarken, Claude Sonnet 4.5'in 200K token penceresi kapsamlı belge kapsamı sağlar.
IronPDF'nin Dahili AI Entegrasyonu
IronPDF ve AI Uzantılarının Kurulumu
AI destekli PDF işlemeye başlamak için temel IronPDF kütüphanesi, AI uzantıları paketi ve Microsoft Semantic Kernel bağımlılıkları gereklidir.
Bu paketler, eksiksiz bir çözü sağlamak için birlikte çalışır. IronPDF tüm PDF ile ilgili işlemleri yönetir - metin çıkartma, sayfa işleme, format dönüştürme - AI uzantısı ise Microsoft Semantic Kernel aracılığıyla dil modelleri ile entegrasyonu yürütür.
Lütfen dikkate alın: Semantic Kernel paketleri deneysel API'ler içerir. Derleyici uyarılarını engellemek için <NoWarn>$(NoWarn);SKEXP0001;SKEXP0010;SKEXP0050</NoWarn>'i .csproj PropertyGroup bölümünüze ekleyin.
OpenAI/Azure API Anahtarınızı Yapılandırma
AI özelliklerinden yararlanabilmemiz için, bir AI hizmet sağlayıcısının erişimini yapılandırmanız gerekir. IronPDF'nin AI uzantısı hem OpenAI hem de Azure OpenAI'yi destekler. Azure OpenAI, genellikle gelişmiş güvenlik özellikleri, uyumluluk sertifikaları ve verileri belirli coğrafi bölgeler içinde saklama olanağı sağladığı için kurumsal uygulamalar için tercih edilir.
Azure OpenAI'yi yapılandırmak için, Azure portalından sohbet ve gömme modeller için Azure uç noktası URL'niz, API anahtarınız ve dağıtım adlarınız gerekir.
AI Motorunu Başlatma
IronPDF'nin AI uzantısı kapalı kapılar ardında Microsoft Semantic Kernel kullanır. Herhangi bir AI özelliğini kullanmadan önce, Azure OpenAI kimlik bilgilerinizi kullanarak çekirdek yazılımı başlatmanız ve doküman işleme için bellek deposunu yapılandırmanız gerekir.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Initialize IronPDF AI with Azure OpenAI credentials// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernel with Azure OpenAIvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();// Create memory store for document embeddingsvar memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();// Initialize IronPDF AIIronDocumentAI.Initialize(kernel, memory);Console.WriteLine("IronPDF AI initialized successfully with Azure OpenAI");
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Initialize IronPDF AI with Azure OpenAI credentials

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel with Azure OpenAI
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

// Create memory store for document embeddings
var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

// Initialize IronPDF AI
IronDocumentAI.Initialize(kernel, memory);

Console.WriteLine("IronPDF AI initialized successfully with Azure OpenAI");
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAI' Initialize IronPDF AI with Azure OpenAI credentials' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic Kernel with Azure OpenAIDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()' Create memory store for document embeddingsDim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()' Initialize IronPDF AIIronDocumentAI.Initialize(kernel, memory)Console.WriteLine("IronPDF AI initialized successfully with Azure OpenAI")
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI

' Initialize IronPDF AI with Azure OpenAI credentials

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel with Azure OpenAI
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

' Create memory store for document embeddings
Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

' Initialize IronPDF AI
IronDocumentAI.Initialize(kernel, memory)

Console.WriteLine("IronPDF AI initialized successfully with Azure OpenAI")
Başlatma iki anahtar bileşen yaratır:
Çekirdek: Azure OpenAI üzerinden sohbet tamamlama ve metin gömme üretimini yönetir
Bellek: Anlamsal arama ve alma işlemleri için doküman gömümlerini saklar
IronDocumentAI.Initialize() ile başlatıldıktan sonra, uygulamanız genelinde AI özelliklerini kullanabilirsiniz. Üretim uygulamaları için, kimlik bilgilerini ortamlarda veya Azure Key Vault'ta saklamak şiddetle tavsiye edilir.
IronPDF'nin AI Bağlamı için PDF'leri Nasıl Hazırladığı
AI destekli PDF işlemenin en zorlayıcı yönlerinden biri, belgeleri dil modelleri tarafından tüketilmek üzere hazırlamaktır. GPT-5, 272.000 giriş tokenine kadar desteklerken ve Claude Opus 4.6 şimdi 1M token bağlam penceresi sunarken, tek bir yasal sözleşme veya finansal rapor hala eski modellerin sınırını kolayca aşabilir.
IronPDF'nin AI uzantısı, bu karmaşıklığı zeki belge hazırlığı ile yönetir. Bir AI yöntemini çağırdığınızda, IronPDF önce PDF'den metin çıkarır ve yapısal bilgileri koruyarak - paragrafları tanımlar, tablo yapılarını muhafaza eder ve bölümler arasındaki ilişkileri korur.
Bağlam sınırlarını aşan belgeler için, IronPDF yapısal belgelerdeki doğal ayrılma noktalarında - bölüm başlıkları, sayfa sonları veya paragraf sınırları gibi stratejik bölümlendirme uygular.
Belgelerin Özetlenmesi
Tek Belge Özetleri
Belge özetleme, uzun belgeleri hemen sindirilebilir içgörülere dönüştürerek anında değer sağlar. Summarize yöntemi tüm iş akışını ele alır: metni çıkarır, AI tüketimi için hazırlar, dil modelinden bir özet talep eder ve sonuçları kaydeder.
Girdi
Kod, PdfDocument.FromFile() kullanarak bir PDF yükler ve kısa bir özet oluşturmak için pdf.Summarize()'i çağırır, ardından sonucu bir metin dosyasına kaydeder.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Summarize a PDF document using IronPDF AI// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);// Load and summarize PDFvar pdf = PdfDocument.FromFile("sample-report.pdf");string summary = await pdf.Summarize();Console.WriteLine("Document Summary:");Console.WriteLine(summary);File.WriteAllText("report-summary.txt", summary);Console.WriteLine("\nSummary saved to report-summary.txt");
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Summarize a PDF document using IronPDF AI

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Load and summarize PDF
var pdf = PdfDocument.FromFile("sample-report.pdf");
string summary = await pdf.Summarize();

Console.WriteLine("Document Summary:");
Console.WriteLine(summary);

File.WriteAllText("report-summary.txt", summary);
Console.WriteLine("\nSummary saved to report-summary.txt");
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI

' Summarize a PDF document using IronPDF AI

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Load and summarize PDF
Dim pdf = PdfDocument.FromFile("sample-report.pdf")
Dim summary As String = Await pdf.Summarize()

Console.WriteLine("Document Summary:")
Console.WriteLine(summary)

File.WriteAllText("report-summary.txt", summary)
Console.WriteLine(vbCrLf & "Summary saved to report-summary.txt")
Konsol Çıkış
Özetleme, yüksek kaliteli sonuçları sağlamak için sofistike ipuçları kullanır. 2026 yılında hem GPT-5 hem de Claude Sonnet 4.5, talimat takibi yeteneklerinde önemli ölçüde gelişmiş özellikler sunarak özetlerin temel bilgileri yakalarken kısa ve okunabilir kalmasını sağlar.
Belge özetleme teknikleri ve gelişmiş seçenekler hakkında daha ayrıntılı bir açıklama için lütfen nasıl yapılır kılavuzumuza başvurun.
Çok Belge Sentezi
Birçok gerçek dünya senaryosu, birden çok belge üzerinden bilgi sentezlemesini gerektirir. Bir hukuk ekibi, bir dizi sözleşme genelinde ortak maddeleri belirlemek isteyebilir veya bir mali analist, üç aylık raporlar genelinde metrikleri karşılaştırmak isteyebilir.
Çok belge sentezine yaklaşım, her belgeyi ayrı ayrı işleyerek anahtar bilgileri çıkarmak, ardından bu içgörüleri son sentez için bir araya getirmeyi içerir.
Bu örnek, birden çok PDF üzerinde dolaşarak her birine pdf.Summarize() çağrısı yapar, ardından birleştirilmiş özetlerle pdf.Query() kullanarak birleşik bir sentez oluşturur.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Synthesize insights across multiple related documents (e.g., quarterly reports into annual summary)// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);// Define documents to synthesizestring[] documentPaths = { "Q1-report.pdf", "Q2-report.pdf", "Q3-report.pdf", "Q4-report.pdf"};var documentSummaries = new List<string>();// Summarize each documentforeach (string path in documentPaths){ var pdf = PdfDocument.FromFile(path); string summary = await pdf.Summarize(); documentSummaries.Add($"=== {Path.GetFileName(path)} ===\n{summary}");Console.WriteLine($"Processed: {path}");}// Combine and synthesize across all documentsstring combinedSummaries = string.Join("\n\n", documentSummaries);var synthesisDoc = PdfDocument.FromFile(documentPaths[0]);string synthesisQuery = @"Based on the quarterly summaries below, provide an annual synthesis:ll trends across quarterschievements and challengesover-year patternss:inedSummaries;string synthesis = await synthesisDoc.Query(synthesisQuery);Console.WriteLine("\n=== AnnualSynthesis ===");Console.WriteLine(synthesis);File.WriteAllText("annual-synthesis.txt", synthesis);
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Synthesize insights across multiple related documents (e.g., quarterly reports into annual summary)

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Define documents to synthesize
string[] documentPaths = {
    "Q1-report.pdf",
    "Q2-report.pdf",
    "Q3-report.pdf",
    "Q4-report.pdf"
};

var documentSummaries = new List<string>();

// Summarize each document
foreach (string path in documentPaths)
{
    var pdf = PdfDocument.FromFile(path);
    string summary = await pdf.Summarize();
    documentSummaries.Add($"=== {Path.GetFileName(path)} ===\n{summary}");
    Console.WriteLine($"Processed: {path}");
}

// Combine and synthesize across all documents
string combinedSummaries = string.Join("\n\n", documentSummaries);

var synthesisDoc = PdfDocument.FromFile(documentPaths[0]);

string synthesisQuery = @"Based on the quarterly summaries below, provide an annual synthesis:
ll trends across quarters
chievements and challenges
over-year patterns

s:
inedSummaries;

string synthesis = await synthesisDoc.Query(synthesisQuery);

Console.WriteLine("\n=== Annual Synthesis ===");
Console.WriteLine(synthesis);

File.WriteAllText("annual-synthesis.txt", synthesis);
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.IO' Synthesize insights across multiple related documents (e.g., quarterly reports into annual summary)' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)' Define documents to synthesizeDim documentPaths AsString() = { "Q1-report.pdf", "Q2-report.pdf", "Q3-report.pdf", "Q4-report.pdf"}Dim documentSummaries = New List(OfString)()' Summarize each documentFor Each path AsStringIn documentPaths Dim pdf = PdfDocument.FromFile(path) Dim summary AsString = Await pdf.Summarize() documentSummaries.Add($"=== {Path.GetFileName(path)} ==={vbCrLf}{summary}")Console.WriteLine($"Processed: {path}")Next' Combine and synthesize across all documentsDim combinedSummaries AsString = String.Join(vbCrLf & vbCrLf, documentSummaries)Dim synthesisDoc = PdfDocument.FromFile(documentPaths(0))Dim synthesisQuery AsString = "Based on the quarterly summaries below, provide an annual synthesis:" & vbCrLf & "Overall trends across quarters" & vbCrLf & "Key achievements and challenges" & vbCrLf & "Year-over-year patterns" & vbCrLf & vbCrLf & combinedSummariesDim synthesis AsString = Await synthesisDoc.Query(synthesisQuery)Console.WriteLine(vbCrLf & "=== Annual Synthesis ===")Console.WriteLine(synthesis)File.WriteAllText("annual-synthesis.txt", synthesis)
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.IO

' Synthesize insights across multiple related documents (e.g., quarterly reports into annual summary)

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Define documents to synthesize
Dim documentPaths As String() = {
    "Q1-report.pdf",
    "Q2-report.pdf",
    "Q3-report.pdf",
    "Q4-report.pdf"
}

Dim documentSummaries = New List(Of String)()

' Summarize each document
For Each path As String In documentPaths
    Dim pdf = PdfDocument.FromFile(path)
    Dim summary As String = Await pdf.Summarize()
    documentSummaries.Add($"=== {Path.GetFileName(path)} ==={vbCrLf}{summary}")
    Console.WriteLine($"Processed: {path}")
Next

' Combine and synthesize across all documents
Dim combinedSummaries As String = String.Join(vbCrLf & vbCrLf, documentSummaries)

Dim synthesisDoc = PdfDocument.FromFile(documentPaths(0))

Dim synthesisQuery As String = "Based on the quarterly summaries below, provide an annual synthesis:" & vbCrLf &
    "Overall trends across quarters" & vbCrLf &
    "Key achievements and challenges" & vbCrLf &
    "Year-over-year patterns" & vbCrLf & vbCrLf &
    combinedSummaries

Dim synthesis As String = Await synthesisDoc.Query(synthesisQuery)

Console.WriteLine(vbCrLf & "=== Annual Synthesis ===")
Console.WriteLine(synthesis)

File.WriteAllText("annual-synthesis.txt", synthesis)
Bu model, büyük belge setlerine etkili bir şekilde ölçeklenir. Belgeleri paralel işleyerek ve ara sonuçları yöneterek, belgelerden oluşan yüzlerce veya binlerce belgeleri tutarlı bir sentez sağlarken analiz edebilirsiniz.
Yöneticilere Yönelik Özet Üretimi
Yönetici özetleri, standart özetlemeden farklı bir yaklaşım gerektirir. İçeriği basitçe özetlemek yerine, bir yönetici özeti en önemli iş bilgilerini belirlemeli, anahtar kararları veya önerileri vurgulamalı ve bulguları liderlik incelemesine uygun bir formatta sunmalıdır.
Kod, iş dili ile ana kararları, kritik bulguları, finansal etkileri ve risk değerlendirmesini talep eden yapılandırılmış bir komut istemi ile pdf.Query() kullanır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Generate executive summary from strategic documents for C-suite leadership// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("strategic-plan.pdf");string executiveQuery = @"Create an executive summary for C-suite leadership. Include:cisions Required:**ny decisions needing executive approvalal Findings:**5 most important findings (bullet points)ial Impact:**e/cost implications if mentionedssessment:**riority risks identifiedended Actions:**ate next stepser 500 words. Use business language appropriate for board presentation.";string executiveSummary = await pdf.Query(executiveQuery);File.WriteAllText("executive-summary.txt", executiveSummary);Console.WriteLine("Executive summary saved to executive-summary.txt");
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Generate executive summary from strategic documents for C-suite leadership

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("strategic-plan.pdf");

string executiveQuery = @"Create an executive summary for C-suite leadership. Include:

cisions Required:**
ny decisions needing executive approval

al Findings:**
5 most important findings (bullet points)

ial Impact:**
e/cost implications if mentioned

ssessment:**
riority risks identified

ended Actions:**
ate next steps

er 500 words. Use business language appropriate for board presentation.";

string executiveSummary = await pdf.Query(executiveQuery);

File.WriteAllText("executive-summary.txt", executiveSummary);
Console.WriteLine("Executive summary saved to executive-summary.txt");
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAI' Generate executive summary from strategic documents for C-suite leadership' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("strategic-plan.pdf")Dim executiveQuery AsString = "Create an executive summary for C-suite leadership. Include:cisions Required:**ny decisions needing executive approvalal Findings:**5 most important findings (bullet points)ial Impact:**e/cost implications if mentionedssessment:**riority risks identifiedended Actions:**ate next stepser 500 words. Use business language appropriate for board presentation."Dim executiveSummary AsString = Await pdf.Query(executiveQuery)File.WriteAllText("executive-summary.txt", executiveSummary)Console.WriteLine("Executive summary saved to executive-summary.txt")
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI

' Generate executive summary from strategic documents for C-suite leadership

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("strategic-plan.pdf")

Dim executiveQuery As String = "Create an executive summary for C-suite leadership. Include:

cisions Required:**
ny decisions needing executive approval

al Findings:**
5 most important findings (bullet points)

ial Impact:**
e/cost implications if mentioned

ssessment:**
riority risks identified

ended Actions:**
ate next steps

er 500 words. Use business language appropriate for board presentation."

Dim executiveSummary As String = Await pdf.Query(executiveQuery)

File.WriteAllText("executive-summary.txt", executiveSummary)
Console.WriteLine("Executive summary saved to executive-summary.txt")
Sonuçta ortaya çıkan yönetici özeti, karar vericilerin detaylarla boğmadan tam olarak ihtiyaç duyduğu bilgileri sağlamaya üzere eyleme dönük bilgileri önceliklendirir.
Akıllı Veri Çıkartımı
JSON'a Yapılandırılmış Veri Çıkartma
AI destekli PDF işlemesinin en güçlü uygulamalarından biri, yapılandırılmamış belgelerden yapılandırılmış veri çıkartmaktır. 2026'da başarılı yapılandırılmış çıkartmanın anahtarı, yapılandırılmış çıkış modlarına sahip JSON şemalarıdır. GPT-5, geliştirilmiş yapılandırılmış çıkışlar sunarken, Claude Sonnet 4.5, güvenilir veri çıkartımı için gelişmiş araç orkestrasyonu sunar.
Girdi
Kod, bir JSON şeması istemi ile pdf.Query() çağırır, ardından çıkarılan fatura verilerini ayrıştırmak ve doğrulamak için JsonSerializer.Deserialize() kullanır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;using System.Text.Json;// Extract structured invoice data as JSON from PDF// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("sample-invoice.pdf");// Define JSON schema for extractionstring extractionQuery = @"Extract invoice data and return as JSON with this exact structure:voiceNumber"": ""string"",voiceDate"": ""YYYY-MM-DD"",eDate"": ""YYYY-MM-DD"",ndor"": {""name"": ""string"",""address"": ""string"",""taxId"": ""string or null""stomer"": {""name"": ""string"",""address"": ""string""neItems"": [{ ""description"": ""string"", ""quantity"": number, ""unitPrice"": number, ""total"": number}btotal"": number,xRate"": number,xAmount"": number,tal"": number,rrency"": ""string""NLY valid JSON, no additional text.";string jsonResponse = await pdf.Query(extractionQuery);// Parse and save JSONtry{ var invoiceData = JsonSerializer.Deserialize<JsonElement>(jsonResponse); string formattedJson = JsonSerializer.Serialize(invoiceData, new JsonSerializerOptions { WriteIndented = true });Console.WriteLine("Extracted Invoice Data:");Console.WriteLine(formattedJson);File.WriteAllText("invoice-data.json", formattedJson);}catch (JsonException){Console.WriteLine("Unable to parse JSON response");File.WriteAllText("invoice-raw-response.txt", jsonResponse);}
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;

// Extract structured invoice data as JSON from PDF

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("sample-invoice.pdf");

// Define JSON schema for extraction
string extractionQuery = @"Extract invoice data and return as JSON with this exact structure:

voiceNumber"": ""string"",
voiceDate"": ""YYYY-MM-DD"",
eDate"": ""YYYY-MM-DD"",
ndor"": {
""name"": ""string"",
""address"": ""string"",
""taxId"": ""string or null""

stomer"": {
""name"": ""string"",
""address"": ""string""

neItems"": [
{
    ""description"": ""string"",
    ""quantity"": number,
    ""unitPrice"": number,
    ""total"": number
}

btotal"": number,
xRate"": number,
xAmount"": number,
tal"": number,
rrency"": ""string""


NLY valid JSON, no additional text.";

string jsonResponse = await pdf.Query(extractionQuery);

// Parse and save JSON
try
{
    var invoiceData = JsonSerializer.Deserialize<JsonElement>(jsonResponse);
    string formattedJson = JsonSerializer.Serialize(invoiceData, new JsonSerializerOptions { WriteIndented = true });

    Console.WriteLine("Extracted Invoice Data:");
    Console.WriteLine(formattedJson);

    File.WriteAllText("invoice-data.json", formattedJson);
}
catch (JsonException)
{
    Console.WriteLine("Unable to parse JSON response");
    File.WriteAllText("invoice-raw-response.txt", jsonResponse);
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Text.Json' Extract structured invoice data as JSON from PDF' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("sample-invoice.pdf")' Define JSON schema for extractionDim extractionQuery AsString = "Extract invoice data and return as JSON with this exact structure:voiceNumber"": ""string"",voiceDate"": ""YYYY-MM-DD"",eDate"": ""YYYY-MM-DD"",ndor"": {""name"": ""string"",""address"": ""string"",""taxId"": ""string or null""stomer"": {""name"": ""string"",""address"": ""string""neItems"": [{ ""description"": ""string"", ""quantity"": number, ""unitPrice"": number, ""total"": number}btotal"": number,xRate"": number,xAmount"": number,tal"": number,rrency"": ""string""NLY valid JSON, no additional text."Dim jsonResponse AsString = Await pdf.QueryAsync(extractionQuery)' Parse and save JSONTry Dim invoiceData = JsonSerializer.Deserialize(OfJsonElement)(jsonResponse) Dim formattedJson AsString = JsonSerializer.Serialize(invoiceData, New JsonSerializerOptionsWith {.WriteIndented = True})Console.WriteLine("Extracted Invoice Data:")Console.WriteLine(formattedJson)File.WriteAllText("invoice-data.json", formattedJson)Catch ex AsJsonExceptionConsole.WriteLine("Unable to parse JSON response")File.WriteAllText("invoice-raw-response.txt", jsonResponse)EndTry
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Text.Json

' Extract structured invoice data as JSON from PDF

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("sample-invoice.pdf")

' Define JSON schema for extraction
Dim extractionQuery As String = "Extract invoice data and return as JSON with this exact structure:

voiceNumber"": ""string"",
voiceDate"": ""YYYY-MM-DD"",
eDate"": ""YYYY-MM-DD"",
ndor"": {
""name"": ""string"",
""address"": ""string"",
""taxId"": ""string or null""

stomer"": {
""name"": ""string"",
""address"": ""string""

neItems"": [
{
    ""description"": ""string"",
    ""quantity"": number,
    ""unitPrice"": number,
    ""total"": number
}

btotal"": number,
xRate"": number,
xAmount"": number,
tal"": number,
rrency"": ""string""

NLY valid JSON, no additional text."

Dim jsonResponse As String = Await pdf.QueryAsync(extractionQuery)

' Parse and save JSON
Try
    Dim invoiceData = JsonSerializer.Deserialize(Of JsonElement)(jsonResponse)
    Dim formattedJson As String = JsonSerializer.Serialize(invoiceData, New JsonSerializerOptions With {.WriteIndented = True})

    Console.WriteLine("Extracted Invoice Data:")
    Console.WriteLine(formattedJson)

    File.WriteAllText("invoice-data.json", formattedJson)
Catch ex As JsonException
    Console.WriteLine("Unable to parse JSON response")
    File.WriteAllText("invoice-raw-response.txt", jsonResponse)
End Try
Üretilen JSON Dosya Ekran Görüntüsünün Bir Bölümü
2026'daki modern AI modelleri, sağlanan şemalara uygun geçerli JSON yanıtlarını garanti eden yapılandırılmış çıkış modlarını destekler. Bu, hatalı yanıtlarla ilgili karmaşık hata işlemi ihtiyacını ortadan kaldırır.
Sözleşme Maddesi Tanımlama
Yasal sözleşmeler, belirli önem taşıyan belirli türde maddeler içerir: fesih hükümleri, sorumluluk sınırlamaları, tazminat gereksinimleri, fikri mülkiyet ödevleri ve gizlilik yükümlülükleri. AI destekli madde tanımlama, bu analizi yüksek doğrulukla otomatikleştirir.
Bu örnek, sahte odaklı bir JSON şeması ile pdf.Query() ardından sözleşme türünü, tarafları, kritik tarihleri ve risk seviyelerinde bireysel sözleşmeleri çıkarır.
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;

// Analyze contract clauses and identify key terms, risks, and critical dates

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("contract.pdf");

// Define JSON schema for contract analysis
string clauseQuery = @"Analyze this contract and identify key clauses. Return JSON:

ntractType"": ""string"",
rties"": [""string""],
fectiveDate"": ""string"",
auses"": [
{
    ""type"": ""Termination|Liability|Indemnification|Confidentiality|IP|Payment|Warranty|Other"",
    ""title"": ""string"",
    ""summary"": ""string"",
    ""riskLevel"": ""Low|Medium|High"",
    ""keyTerms"": [""string""]
}

iticalDates"": [
{
    ""description"": ""string"",
    ""date"": ""string""
}

erallRiskAssessment"": ""Low|Medium|High"",
commendations"": [""string""]


: termination rights, liability caps, indemnification, IP ownership, confidentiality, payment terms.
NLY valid JSON.";

string analysisJson = await pdf.Query(clauseQuery);

try
{
    var analysis = JsonSerializer.Deserialize<JsonElement>(analysisJson);
    string formatted = JsonSerializer.Serialize(analysis, new JsonSerializerOptions { WriteIndented = true });

    Console.WriteLine("Contract Clause Analysis:");
    Console.WriteLine(formatted);

    File.WriteAllText("contract-analysis.json", formatted);

    // Display high-risk clauses
    Console.WriteLine("\n=== High Risk Clauses ===");
    foreach (var clause in analysis.GetProperty("clauses").EnumerateArray())
    {
        if (clause.GetProperty("riskLevel").GetString() == "High")
        {
            Console.WriteLine($"- {clause.GetProperty("type")}: {clause.GetProperty("summary")}");
        }
    }
}
catch (JsonException)
{
    Console.WriteLine("Unable to parse contract analysis");
    File.WriteAllText("contract-analysis-raw.txt", analysisJson);
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Text.Json' Analyze contract clauses and identify key terms, risks, and critical dates' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("contract.pdf")' Define JSON schema for contract analysisDim clauseQuery AsString = "Analyze this contract and identify key clauses. Return JSON:ntractType"": ""string"",rties"": [""string""],fectiveDate"": ""string"",auses"": [{ ""type"": ""Termination|Liability|Indemnification|Confidentiality|IP|Payment|Warranty|Other"", ""title"": ""string"", ""summary"": ""string"", ""riskLevel"": ""Low|Medium|High"", ""keyTerms"": [""string""]}iticalDates"": [{ ""description"": ""string"", ""date"": ""string""}erallRiskAssessment"": ""Low|Medium|High"",commendations"": [""string""]: termination rights, liability caps, indemnification, IP ownership, confidentiality, payment terms.NLY valid JSON."Dim analysisJson AsString = Await pdf.Query(clauseQuery)Try Dim analysis = JsonSerializer.Deserialize(OfJsonElement)(analysisJson) Dim formatted AsString = JsonSerializer.Serialize(analysis, New JsonSerializerOptionsWith {.WriteIndented = True})Console.WriteLine("Contract Clause Analysis:")Console.WriteLine(formatted)File.WriteAllText("contract-analysis.json", formatted) ' Display high-risk clausesConsole.WriteLine(vbCrLf & "=== High Risk Clauses ===") For Each clause In analysis.GetProperty("clauses").EnumerateArray() If clause.GetProperty("riskLevel").GetString() = "High" ThenConsole.WriteLine($"- {clause.GetProperty("type")}: {clause.GetProperty("summary")}") End If NextCatch ex AsJsonExceptionConsole.WriteLine("Unable to parse contract analysis")File.WriteAllText("contract-analysis-raw.txt", analysisJson)EndTry
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Text.Json

' Analyze contract clauses and identify key terms, risks, and critical dates

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("contract.pdf")

' Define JSON schema for contract analysis
Dim clauseQuery As String = "Analyze this contract and identify key clauses. Return JSON:

ntractType"": ""string"",
rties"": [""string""],
fectiveDate"": ""string"",
auses"": [
{
    ""type"": ""Termination|Liability|Indemnification|Confidentiality|IP|Payment|Warranty|Other"",
    ""title"": ""string"",
    ""summary"": ""string"",
    ""riskLevel"": ""Low|Medium|High"",
    ""keyTerms"": [""string""]
}

iticalDates"": [
{
    ""description"": ""string"",
    ""date"": ""string""
}

erallRiskAssessment"": ""Low|Medium|High"",
commendations"": [""string""]

: termination rights, liability caps, indemnification, IP ownership, confidentiality, payment terms.
NLY valid JSON."

Dim analysisJson As String = Await pdf.Query(clauseQuery)

Try
    Dim analysis = JsonSerializer.Deserialize(Of JsonElement)(analysisJson)
    Dim formatted As String = JsonSerializer.Serialize(analysis, New JsonSerializerOptions With {.WriteIndented = True})

    Console.WriteLine("Contract Clause Analysis:")
    Console.WriteLine(formatted)

    File.WriteAllText("contract-analysis.json", formatted)

    ' Display high-risk clauses
    Console.WriteLine(vbCrLf & "=== High Risk Clauses ===")
    For Each clause In analysis.GetProperty("clauses").EnumerateArray()
        If clause.GetProperty("riskLevel").GetString() = "High" Then
            Console.WriteLine($"- {clause.GetProperty("type")}: {clause.GetProperty("summary")}")
        End If
    Next
Catch ex As JsonException
    Console.WriteLine("Unable to parse contract analysis")
    File.WriteAllText("contract-analysis-raw.txt", analysisJson)
End Try
Bu yetenek, sözleşme incelemesini sıralı ve manuel bir süreçten otomatik ve ölçeklenebilir bir iş akışına dönüştürür. Hukuk ekipleri, yüzlerce sözleşme arasında yüksek riskli hükümlerin hızlı bir şekilde tanımlayabilir.
Finansal Veri Ayrıştırma
Finansal belgeler, karmaşık anlatılar ve tabloların içine gömülü kritik nicel veriler içerir. AI destekli ayrıştırma, finansal belgelerde mükemmeldir çünkü bağlamı anlar - tarihsel sonuçlar ve ileriye dönük projeksiyonlar arasındaki farkı ayırt eder, sayıların binlerce mi yoksa milyonlarca mı olduğunu belirler ve farklı metrikler arasındaki ilişkileri anlar.
Kod, mali JSON şeması ile pdf.Query() kullanarak gelir tablosu verilerini, bilanço ölçümlerini ve ileriye yönelik rehberliği yapılandırılmış çıktıya dönüştürür.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;using System.Text.Json;// Extract financial metrics from annual reports and earnings documents// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("annual-report.pdf");// Define JSON schema for financial extraction (numbers in millions)string financialQuery = @"Extract financial metrics from this document. Return JSON:portPeriod"": ""string"",mpany"": ""string"",rrency"": ""string"",comeStatement"": {""revenue"": number,""costOfRevenue"": number,""grossProfit"": number,""operatingExpenses"": number,""operatingIncome"": number,""netIncome"": number,""eps"": numberlanceSheet"": {""totalAssets"": number,""totalLiabilities"": number,""shareholdersEquity"": number,""cash"": number,""totalDebt"": numberyMetrics"": {""revenueGrowthYoY"": ""string"",""grossMargin"": ""string"",""operatingMargin"": ""string"",""netMargin"": ""string"",""debtToEquity"": numberidance"": {""nextQuarterRevenue"": ""string"",""fullYearRevenue"": ""string"",""notes"": ""string"" for unavailable data. Numbers in millions unless stated.NLY valid JSON.";string financialJson = await pdf.Query(financialQuery);try{ var financials = JsonSerializer.Deserialize<JsonElement>(financialJson); string formatted = JsonSerializer.Serialize(financials, new JsonSerializerOptions { WriteIndented = true });Console.WriteLine("Extracted Financial Data:");Console.WriteLine(formatted);File.WriteAllText("financial-data.json", formatted);}catch (JsonException){Console.WriteLine("Unable to parse financial data");File.WriteAllText("financial-raw.txt", financialJson);}
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;

// Extract financial metrics from annual reports and earnings documents

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("annual-report.pdf");

// Define JSON schema for financial extraction (numbers in millions)
string financialQuery = @"Extract financial metrics from this document. Return JSON:

portPeriod"": ""string"",
mpany"": ""string"",
rrency"": ""string"",
comeStatement"": {
""revenue"": number,
""costOfRevenue"": number,
""grossProfit"": number,
""operatingExpenses"": number,
""operatingIncome"": number,
""netIncome"": number,
""eps"": number

lanceSheet"": {
""totalAssets"": number,
""totalLiabilities"": number,
""shareholdersEquity"": number,
""cash"": number,
""totalDebt"": number

yMetrics"": {
""revenueGrowthYoY"": ""string"",
""grossMargin"": ""string"",
""operatingMargin"": ""string"",
""netMargin"": ""string"",
""debtToEquity"": number

idance"": {
""nextQuarterRevenue"": ""string"",
""fullYearRevenue"": ""string"",
""notes"": ""string""


 for unavailable data. Numbers in millions unless stated.
NLY valid JSON.";

string financialJson = await pdf.Query(financialQuery);

try
{
    var financials = JsonSerializer.Deserialize<JsonElement>(financialJson);
    string formatted = JsonSerializer.Serialize(financials, new JsonSerializerOptions { WriteIndented = true });

    Console.WriteLine("Extracted Financial Data:");
    Console.WriteLine(formatted);

    File.WriteAllText("financial-data.json", formatted);
}
catch (JsonException)
{
    Console.WriteLine("Unable to parse financial data");
    File.WriteAllText("financial-raw.txt", financialJson);
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Text.Json' Extract financial metrics from annual reports and earnings documents' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("annual-report.pdf")' Define JSON schema for financial extraction (numbers in millions)Dim financialQuery AsString = "Extract financial metrics from this document. Return JSON:portPeriod"": ""string"",mpany"": ""string"",rrency"": ""string"",comeStatement"": {""revenue"": number,""costOfRevenue"": number,""grossProfit"": number,""operatingExpenses"": number,""operatingIncome"": number,""netIncome"": number,""eps"": numberlanceSheet"": {""totalAssets"": number,""totalLiabilities"": number,""shareholdersEquity"": number,""cash"": number,""totalDebt"": numberyMetrics"": {""revenueGrowthYoY"": ""string"",""grossMargin"": ""string"",""operatingMargin"": ""string"",""netMargin"": ""string"",""debtToEquity"": numberidance"": {""nextQuarterRevenue"": ""string"",""fullYearRevenue"": ""string"",""notes"": ""string"" for unavailable data. Numbers in millions unless stated.NLY valid JSON."Dim financialJson AsString = Await pdf.Query(financialQuery)Try Dim financials = JsonSerializer.Deserialize(OfJsonElement)(financialJson) Dim formatted AsString = JsonSerializer.Serialize(financials, New JsonSerializerOptionsWith {.WriteIndented = True})Console.WriteLine("Extracted Financial Data:")Console.WriteLine(formatted)File.WriteAllText("financial-data.json", formatted)Catch ex AsJsonExceptionConsole.WriteLine("Unable to parse financial data")File.WriteAllText("financial-raw.txt", financialJson)EndTry
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Text.Json

' Extract financial metrics from annual reports and earnings documents

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("annual-report.pdf")

' Define JSON schema for financial extraction (numbers in millions)
Dim financialQuery As String = "Extract financial metrics from this document. Return JSON:

portPeriod"": ""string"",
mpany"": ""string"",
rrency"": ""string"",
comeStatement"": {
""revenue"": number,
""costOfRevenue"": number,
""grossProfit"": number,
""operatingExpenses"": number,
""operatingIncome"": number,
""netIncome"": number,
""eps"": number

lanceSheet"": {
""totalAssets"": number,
""totalLiabilities"": number,
""shareholdersEquity"": number,
""cash"": number,
""totalDebt"": number

yMetrics"": {
""revenueGrowthYoY"": ""string"",
""grossMargin"": ""string"",
""operatingMargin"": ""string"",
""netMargin"": ""string"",
""debtToEquity"": number

idance"": {
""nextQuarterRevenue"": ""string"",
""fullYearRevenue"": ""string"",
""notes"": ""string""


 for unavailable data. Numbers in millions unless stated.
NLY valid JSON."

Dim financialJson As String = Await pdf.Query(financialQuery)

Try
    Dim financials = JsonSerializer.Deserialize(Of JsonElement)(financialJson)
    Dim formatted As String = JsonSerializer.Serialize(financials, New JsonSerializerOptions With {.WriteIndented = True})

    Console.WriteLine("Extracted Financial Data:")
    Console.WriteLine(formatted)

    File.WriteAllText("financial-data.json", formatted)
Catch ex As JsonException
    Console.WriteLine("Unable to parse financial data")
    File.WriteAllText("financial-raw.txt", financialJson)
End Try
Çıkarılan yapılandırılmış veriler, finansal modelleme, zaman serisi veritabanları veya analiz platformlarına doğrudan aktarılabilir ve raporlama dönemleri genelinde metriklerin otomatik takibini sağlar.
Özel Çıkartma Komutları
Birçok kuruluşun, özel alanlarına, belge formatlarına veya iş süreçlerine dayalı olarak benzersiz çıkarım gereksinimleri vardır. IronPDF'in yapay zeka entegrasyonu, özel çıkarım istemlerini tam olarak destekleyerek hangi bilginin çıkarılması gerektiğini ve nasıl yapılandırılacağını tam olarak tanımlamanızı sağlar.
Bu örnek, akademik makalelerden methology, güven seviyeleri ile ana bulgular ve sınırlamalar çıkaran araştırma odaklı bir şema ile pdf.Query() kullanmayı gösterir.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;using System.Text.Json;// Extract structured research metadata from academic papers// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("research-paper.pdf");// Define JSON schema for research paper extractionstring researchQuery = @"Extract structured information from this research paper. Return JSON:tle"": ""string"",thors"": [""string""],stitution"": ""string"",blicationDate"": ""string"",stract"": ""string"",searchQuestion"": ""string"",thodology"": {""type"": ""Quantitative|Qualitative|Mixed Methods"",""approach"": ""string"",""sampleSize"": ""string"",""dataCollection"": ""string""yFindings"": [{ ""finding"": ""string"", ""significance"": ""string"", ""confidence"": ""High|Medium|Low""}mitations"": [""string""],tureWork"": [""string""],ywords"": [""string""] extracting verifiable claims and noting uncertainty.NLY valid JSON.";string extractionResult = await pdf.Query(researchQuery);try{ var research = JsonSerializer.Deserialize<JsonElement>(extractionResult); string formatted = JsonSerializer.Serialize(research, new JsonSerializerOptions { WriteIndented = true });Console.WriteLine("Research Paper Extraction:");Console.WriteLine(formatted);File.WriteAllText("research-extraction.json", formatted); // Display key findings with confidence levelsConsole.WriteLine("\n=== Key Findings ==="); foreach (var finding in research.GetProperty("keyFindings").EnumerateArray()) { string confidence = finding.GetProperty("confidence").GetString() ?? "Unknown";Console.WriteLine($"[{confidence}] {finding.GetProperty("finding")}"); }}catch (JsonException){Console.WriteLine("Unable to parse research extraction");File.WriteAllText("research-raw.txt", extractionResult);}
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.Json;

// Extract structured research metadata from academic papers

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("research-paper.pdf");

// Define JSON schema for research paper extraction
string researchQuery = @"Extract structured information from this research paper. Return JSON:

tle"": ""string"",
thors"": [""string""],
stitution"": ""string"",
blicationDate"": ""string"",
stract"": ""string"",
searchQuestion"": ""string"",
thodology"": {
""type"": ""Quantitative|Qualitative|Mixed Methods"",
""approach"": ""string"",
""sampleSize"": ""string"",
""dataCollection"": ""string""

yFindings"": [
{
    ""finding"": ""string"",
    ""significance"": ""string"",
    ""confidence"": ""High|Medium|Low""
}

mitations"": [""string""],
tureWork"": [""string""],
ywords"": [""string""]


 extracting verifiable claims and noting uncertainty.
NLY valid JSON.";

string extractionResult = await pdf.Query(researchQuery);

try
{
    var research = JsonSerializer.Deserialize<JsonElement>(extractionResult);
    string formatted = JsonSerializer.Serialize(research, new JsonSerializerOptions { WriteIndented = true });

    Console.WriteLine("Research Paper Extraction:");
    Console.WriteLine(formatted);

    File.WriteAllText("research-extraction.json", formatted);

    // Display key findings with confidence levels
    Console.WriteLine("\n=== Key Findings ===");
    foreach (var finding in research.GetProperty("keyFindings").EnumerateArray())
    {
        string confidence = finding.GetProperty("confidence").GetString() ?? "Unknown";
        Console.WriteLine($"[{confidence}] {finding.GetProperty("finding")}");
    }
}
catch (JsonException)
{
    Console.WriteLine("Unable to parse research extraction");
    File.WriteAllText("research-raw.txt", extractionResult);
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Text.Json' Extract structured research metadata from academic papers' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("research-paper.pdf")' Define JSON schema for research paper extractionDim researchQuery AsString = "Extract structured information from this research paper. Return JSON:tle"": ""string"",thors"": [""string""],stitution"": ""string"",blicationDate"": ""string"",stract"": ""string"",searchQuestion"": ""string"",thodology"": {""type"": ""Quantitative|Qualitative|Mixed Methods"",""approach"": ""string"",""sampleSize"": ""string"",""dataCollection"": ""string""yFindings"": [{ ""finding"": ""string"", ""significance"": ""string"", ""confidence"": ""High|Medium|Low""}mitations"": [""string""],tureWork"": [""string""],ywords"": [""string""] extracting verifiable claims and noting uncertainty.NLY valid JSON."Dim extractionResult AsString = Await pdf.Query(researchQuery)Try Dim research = JsonSerializer.Deserialize(OfJsonElement)(extractionResult) Dim formatted AsString = JsonSerializer.Serialize(research, New JsonSerializerOptionsWith {.WriteIndented = True})Console.WriteLine("Research Paper Extraction:")Console.WriteLine(formatted)File.WriteAllText("research-extraction.json", formatted) ' Display key findings with confidence levelsConsole.WriteLine(vbCrLf & "=== Key Findings ===") For Each finding In research.GetProperty("keyFindings").EnumerateArray() Dim confidence AsString = finding.GetProperty("confidence").GetString() OrElse"Unknown"Console.WriteLine($"[{confidence}] {finding.GetProperty("finding")}") NextCatch ex AsJsonExceptionConsole.WriteLine("Unable to parse research extraction")File.WriteAllText("research-raw.txt", extractionResult)EndTry
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Text.Json

' Extract structured research metadata from academic papers

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("research-paper.pdf")

' Define JSON schema for research paper extraction
Dim researchQuery As String = "Extract structured information from this research paper. Return JSON:

tle"": ""string"",
thors"": [""string""],
stitution"": ""string"",
blicationDate"": ""string"",
stract"": ""string"",
searchQuestion"": ""string"",
thodology"": {
""type"": ""Quantitative|Qualitative|Mixed Methods"",
""approach"": ""string"",
""sampleSize"": ""string"",
""dataCollection"": ""string""

yFindings"": [
{
    ""finding"": ""string"",
    ""significance"": ""string"",
    ""confidence"": ""High|Medium|Low""
}

mitations"": [""string""],
tureWork"": [""string""],
ywords"": [""string""]

 extracting verifiable claims and noting uncertainty.
NLY valid JSON."

Dim extractionResult As String = Await pdf.Query(researchQuery)

Try
    Dim research = JsonSerializer.Deserialize(Of JsonElement)(extractionResult)
    Dim formatted As String = JsonSerializer.Serialize(research, New JsonSerializerOptions With {.WriteIndented = True})

    Console.WriteLine("Research Paper Extraction:")
    Console.WriteLine(formatted)

    File.WriteAllText("research-extraction.json", formatted)

    ' Display key findings with confidence levels
    Console.WriteLine(vbCrLf & "=== Key Findings ===")
    For Each finding In research.GetProperty("keyFindings").EnumerateArray()
        Dim confidence As String = finding.GetProperty("confidence").GetString() OrElse "Unknown"
        Console.WriteLine($"[{confidence}] {finding.GetProperty("finding")}")
    Next
Catch ex As JsonException
    Console.WriteLine("Unable to parse research extraction")
    File.WriteAllText("research-raw.txt", extractionResult)
End Try
Özel istemler, yapay zeka destekli çıkarımı genel bir araçtan, özel ihtiyaçlarınıza göre uyarlanmış özel bir çözüme dönüştürür.
Bu türden favori kütüphanem IronPDF'dir. PDF dosyalarının hızlı ve verimli bir şekilde işlenmesine olanak tanır. Ayrıca, PDF/A formatına dışa aktarma ve dijital imzalama gibi birçok değerli özelliğe sahiptir.
IronOCR, manuel işleme maliyetinden yıllık 40.000 USD tasarruf etmemizi sağlıyor, üretkenliği artırıyor ve yüksek etkili görevler için kaynakları serbest bırakıyor. Kesinlikle tavsiye ederim.
Soru-cevap sistemleri, kullanıcıların doğal dilde sorular sormasına ve doğru, bağlamlı cevaplar almasına olanak tanıyarak PDF belgeleriyle etkileşime geçmesini sağlar. Temel desen, PDF'den metin çıkarmayı, kullanıcı sorusuyla bir isteme entegre etmeyi ve yapay zekadan cevap istemeyi içerir.
Girdi
Kod, dokümanı semantik arama için pdf.Memorize() ile indeksler, ardından kullanıcı sorularını yanıtlamak için pdf.Query() ile etkileşimli bir döngü başlatır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Interactive Q&A system for querying PDF documents// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("sample-legal-document.pdf");// Memorize document to enable persistent queryingawait pdf.Memorize();Console.WriteLine("PDF Q&A System - Type 'exit' to quit\n");Console.WriteLine($"Document loaded and memorized: {pdf.PageCount} pages\n");// Interactive Q&A loopwhile (true){Console.Write("Your question: "); string? question = Console.ReadLine(); if (string.IsNullOrWhiteSpace(question) || question.ToLower() == "exit") break; string answer = await pdf.Query(question);Console.WriteLine($"\nAnswer: {answer}\n");Console.WriteLine(new string('-', 50) + "\n");}Console.WriteLine("Q&A session ended.");
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Interactive Q&A system for querying PDF documents

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("sample-legal-document.pdf");

// Memorize document to enable persistent querying
await pdf.Memorize();

Console.WriteLine("PDF Q&A System - Type 'exit' to quit\n");
Console.WriteLine($"Document loaded and memorized: {pdf.PageCount} pages\n");

// Interactive Q&A loop
while (true)
{
    Console.Write("Your question: ");
    string? question = Console.ReadLine();

    if (string.IsNullOrWhiteSpace(question) || question.ToLower() == "exit")
        break;

    string answer = await pdf.Query(question);

    Console.WriteLine($"\nAnswer: {answer}\n");
    Console.WriteLine(new string('-', 50) + "\n");
}

Console.WriteLine("Q&A session ended.");
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAI' Interactive Q&A system for querying PDF documents' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("sample-legal-document.pdf")' Memorize document to enable persistent queryingAwait pdf.Memorize()Console.WriteLine("PDF Q&A System - Type 'exit' to quit" & vbCrLf)Console.WriteLine($"Document loaded and memorized: {pdf.PageCount} pages" & vbCrLf)' Interactive Q&A loopWhile TrueConsole.Write("Your question: ") Dim question AsString = Console.ReadLine() IfString.IsNullOrWhiteSpace(question) OrElse question.ToLower() = "exit" ThenExitWhile End If Dim answer AsString = Await pdf.Query(question)Console.WriteLine($"{vbCrLf}Answer: {answer}{vbCrLf}")Console.WriteLine(New String("-"c, 50) & vbCrLf)EndWhileConsole.WriteLine("Q&A session ended.")
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI

' Interactive Q&A system for querying PDF documents

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("sample-legal-document.pdf")

' Memorize document to enable persistent querying
Await pdf.Memorize()

Console.WriteLine("PDF Q&A System - Type 'exit' to quit" & vbCrLf)
Console.WriteLine($"Document loaded and memorized: {pdf.PageCount} pages" & vbCrLf)

' Interactive Q&A loop
While True
    Console.Write("Your question: ")
    Dim question As String = Console.ReadLine()

    If String.IsNullOrWhiteSpace(question) OrElse question.ToLower() = "exit" Then
        Exit While
    End If

    Dim answer As String = Await pdf.Query(question)

    Console.WriteLine($"{vbCrLf}Answer: {answer}{vbCrLf}")
    Console.WriteLine(New String("-"c, 50) & vbCrLf)
End While

Console.WriteLine("Q&A session ended.")
Konsol Çıkış
2026'da etkili soru-cevabın anahtarı, yapay zekayı yalnızca belge içeriğine dayalı cevap vermeye sınırlandırmaktır. GPT-5'in "güvenli tamamlamalar" eğitimi metodu ve Claude Sonnet 4.5'in geliştirilmiş hizalaması yanılsama oranlarını önemli ölçüde azaltır.
Uzun Belgeleri Bağlam Pencerelerine Bölme
Gerçek dünya belgelerinin çoğu yapay zeka bağlam pencerelerini aşar. Bu belgelerin işlenmesi için etkili bölme stratejileri esastır. Bölme, belgeleri bağlam pencerelerine sığacak kadar küçük segmentlere bölerken anlamsal bütünlüğü korumayı içeren bir işlemdir.
Bu kod pdf.Pages üzerinden dolaşır, DocumentChunk nesnelerini yapılandırılabilir maxChunkTokens ve overlapTokens ile bağlam devamlılığı sağlamak için oluşturur.
using IronPdf;// Split long documents into overlapping chunks for RAG systemsvar pdf = PdfDocument.FromFile("long-document.pdf");// Chunking configurationint maxChunkTokens = 4000; // Leave room for prompts and responsesint overlapTokens = 200; // Overlap for context continuityint approxCharsPerToken = 4; // Rough estimate for tokenizationint maxChunkChars = maxChunkTokens * approxCharsPerToken;int overlapChars = overlapTokens * approxCharsPerToken;var chunks = new List<DocumentChunk>();var currentChunk = new System.Text.StringBuilder();int chunkStartPage = 1;int currentPage = 1;for (int i = 0; i < pdf.PageCount; i++){ string pageText = pdf.Pages[i].Text; currentPage = i + 1; if (currentChunk.Length + pageText.Length > maxChunkChars && currentChunk.Length > 0) { chunks.Add(new DocumentChunk {Text = currentChunk.ToString(),StartPage = chunkStartPage,EndPage = currentPage - 1,ChunkIndex = chunks.Count }); // Create overlap with previous chunk for continuity string overlap = currentChunk.Length > overlapChars ? currentChunk.ToString().Substring(currentChunk.Length - overlapChars) : currentChunk.ToString(); currentChunk.Clear(); currentChunk.Append(overlap); chunkStartPage = currentPage - 1; } currentChunk.AppendLine($"\n--- Page {currentPage} ---\n"); currentChunk.Append(pageText);}if (currentChunk.Length > 0){ chunks.Add(new DocumentChunk {Text = currentChunk.ToString(),StartPage = chunkStartPage,EndPage = currentPage,ChunkIndex = chunks.Count });}Console.WriteLine($"Document chunked into {chunks.Count} segments");foreach (var chunk in chunks){Console.WriteLine($" Chunk {chunk.ChunkIndex + 1}: Pages {chunk.StartPage}-{chunk.EndPage} ({chunk.Text.Length} chars)");}// Save chunk metadata for RAG indexingFile.WriteAllText("chunks-metadata.json", System.Text.Json.JsonSerializer.Serialize( chunks.Select(c => new { c.ChunkIndex, c.StartPage, c.EndPage, Length = c.Text.Length }), new System.Text.Json.JsonSerializerOptions { WriteIndented = true }));ic class DocumentChunkpublic string Text { get; set; } = "";public intStartPage { get; set; }public intEndPage { get; set; }public intChunkIndex { get; set; }
using IronPdf;

// Split long documents into overlapping chunks for RAG systems

var pdf = PdfDocument.FromFile("long-document.pdf");

// Chunking configuration
int maxChunkTokens = 4000;      // Leave room for prompts and responses
int overlapTokens = 200;        // Overlap for context continuity
int approxCharsPerToken = 4;    // Rough estimate for tokenization

int maxChunkChars = maxChunkTokens * approxCharsPerToken;
int overlapChars = overlapTokens * approxCharsPerToken;

var chunks = new List<DocumentChunk>();
var currentChunk = new System.Text.StringBuilder();
int chunkStartPage = 1;
int currentPage = 1;

for (int i = 0; i < pdf.PageCount; i++)
{
    string pageText = pdf.Pages[i].Text;
    currentPage = i + 1;

    if (currentChunk.Length + pageText.Length > maxChunkChars && currentChunk.Length > 0)
    {
        chunks.Add(new DocumentChunk
        {
            Text = currentChunk.ToString(),
            StartPage = chunkStartPage,
            EndPage = currentPage - 1,
            ChunkIndex = chunks.Count
        });

        // Create overlap with previous chunk for continuity
        string overlap = currentChunk.Length > overlapChars
            ? currentChunk.ToString().Substring(currentChunk.Length - overlapChars)
            : currentChunk.ToString();

        currentChunk.Clear();
        currentChunk.Append(overlap);
        chunkStartPage = currentPage - 1;
    }

    currentChunk.AppendLine($"\n--- Page {currentPage} ---\n");
    currentChunk.Append(pageText);
}

if (currentChunk.Length > 0)
{
    chunks.Add(new DocumentChunk
    {
        Text = currentChunk.ToString(),
        StartPage = chunkStartPage,
        EndPage = currentPage,
        ChunkIndex = chunks.Count
    });
}

Console.WriteLine($"Document chunked into {chunks.Count} segments");
foreach (var chunk in chunks)
{
    Console.WriteLine($"  Chunk {chunk.ChunkIndex + 1}: Pages {chunk.StartPage}-{chunk.EndPage} ({chunk.Text.Length} chars)");
}

// Save chunk metadata for RAG indexing
File.WriteAllText("chunks-metadata.json", System.Text.Json.JsonSerializer.Serialize(
    chunks.Select(c => new { c.ChunkIndex, c.StartPage, c.EndPage, Length = c.Text.Length }),
    new System.Text.Json.JsonSerializerOptions { WriteIndented = true }
));


ic class DocumentChunk

public string Text { get; set; } = "";
public int StartPage { get; set; }
public int EndPage { get; set; }
public int ChunkIndex { get; set; }
ImportsIronPdfImportsSystem.IOImportsSystem.TextImportsSystem.Text.Json' Split long documents into overlapping chunks for RAG systemsDim pdf = PdfDocument.FromFile("long-document.pdf")' Chunking configurationDim maxChunkTokens AsInteger = 4000 ' Leave room for prompts and responsesDim overlapTokens AsInteger = 200 ' Overlap for context continuityDim approxCharsPerToken AsInteger = 4 ' Rough estimate for tokenizationDim maxChunkChars AsInteger = maxChunkTokens * approxCharsPerTokenDim overlapChars AsInteger = overlapTokens * approxCharsPerTokenDim chunks As New List(OfDocumentChunk)()Dim currentChunk As New StringBuilder()Dim chunkStartPage AsInteger = 1Dim currentPage AsInteger = 1For i AsInteger = 0 To pdf.PageCount - 1 Dim pageText AsString = pdf.Pages(i).Text currentPage = i + 1 If currentChunk.Length + pageText.Length > maxChunkChars AndAlso currentChunk.Length > 0 Then chunks.Add(New DocumentChunkWith { .Text = currentChunk.ToString(), .StartPage = chunkStartPage, .EndPage = currentPage - 1, .ChunkIndex = chunks.Count }) ' Create overlap with previous chunk for continuity Dim overlap AsString = If(currentChunk.Length > overlapChars, currentChunk.ToString().Substring(currentChunk.Length - overlapChars), currentChunk.ToString()) currentChunk.Clear() currentChunk.Append(overlap) chunkStartPage = currentPage - 1 End If currentChunk.AppendLine(vbCrLf & "--- Page " & currentPage & " ---" & vbCrLf) currentChunk.Append(pageText)NextIf currentChunk.Length > 0 Then chunks.Add(New DocumentChunkWith { .Text = currentChunk.ToString(), .StartPage = chunkStartPage, .EndPage = currentPage, .ChunkIndex = chunks.Count })End IfConsole.WriteLine($"Document chunked into {chunks.Count} segments")For Each chunk In chunksConsole.WriteLine($" Chunk {chunk.ChunkIndex + 1}: Pages {chunk.StartPage}-{chunk.EndPage} ({chunk.Text.Length} chars)")Next' Save chunk metadata for RAG indexingFile.WriteAllText("chunks-metadata.json", JsonSerializer.Serialize( chunks.Select(Function(c) New With {.ChunkIndex = c.ChunkIndex, .StartPage = c.StartPage, .EndPage = c.EndPage, .Length = c.Text.Length}), New JsonSerializerOptionsWith {.WriteIndented = True}))Public Class DocumentChunk Public Property TextAsString = "" Public Property StartPageAsInteger Public Property EndPageAsInteger Public Property ChunkIndexAsIntegerEnd Class
Imports IronPdf
Imports System.IO
Imports System.Text
Imports System.Text.Json

' Split long documents into overlapping chunks for RAG systems

Dim pdf = PdfDocument.FromFile("long-document.pdf")

' Chunking configuration
Dim maxChunkTokens As Integer = 4000      ' Leave room for prompts and responses
Dim overlapTokens As Integer = 200        ' Overlap for context continuity
Dim approxCharsPerToken As Integer = 4    ' Rough estimate for tokenization

Dim maxChunkChars As Integer = maxChunkTokens * approxCharsPerToken
Dim overlapChars As Integer = overlapTokens * approxCharsPerToken

Dim chunks As New List(Of DocumentChunk)()
Dim currentChunk As New StringBuilder()
Dim chunkStartPage As Integer = 1
Dim currentPage As Integer = 1

For i As Integer = 0 To pdf.PageCount - 1
    Dim pageText As String = pdf.Pages(i).Text
    currentPage = i + 1

    If currentChunk.Length + pageText.Length > maxChunkChars AndAlso currentChunk.Length > 0 Then
        chunks.Add(New DocumentChunk With {
            .Text = currentChunk.ToString(),
            .StartPage = chunkStartPage,
            .EndPage = currentPage - 1,
            .ChunkIndex = chunks.Count
        })

        ' Create overlap with previous chunk for continuity
        Dim overlap As String = If(currentChunk.Length > overlapChars,
            currentChunk.ToString().Substring(currentChunk.Length - overlapChars),
            currentChunk.ToString())

        currentChunk.Clear()
        currentChunk.Append(overlap)
        chunkStartPage = currentPage - 1
    End If

    currentChunk.AppendLine(vbCrLf & "--- Page " & currentPage & " ---" & vbCrLf)
    currentChunk.Append(pageText)
Next

If currentChunk.Length > 0 Then
    chunks.Add(New DocumentChunk With {
        .Text = currentChunk.ToString(),
        .StartPage = chunkStartPage,
        .EndPage = currentPage,
        .ChunkIndex = chunks.Count
    })
End If

Console.WriteLine($"Document chunked into {chunks.Count} segments")
For Each chunk In chunks
    Console.WriteLine($"  Chunk {chunk.ChunkIndex + 1}: Pages {chunk.StartPage}-{chunk.EndPage} ({chunk.Text.Length} chars)")
Next

' Save chunk metadata for RAG indexing
File.WriteAllText("chunks-metadata.json", JsonSerializer.Serialize(
    chunks.Select(Function(c) New With {.ChunkIndex = c.ChunkIndex, .StartPage = c.StartPage, .EndPage = c.EndPage, .Length = c.Text.Length}),
    New JsonSerializerOptions With {.WriteIndented = True}
))

Public Class DocumentChunk
    Public Property Text As String = ""
    Public Property StartPage As Integer
    Public Property EndPage As Integer
    Public Property ChunkIndex As Integer
End Class
Çakışan parçalar, sınırlardan continuity sağlayarak, yapay zekanın ilgili bilgilerin parça sınırları boyunca yayıldığında bile yeterli bağlama sahip olmasını sağlar.
RAG (Arama-Temelli Üretim) Desenleri
2026'da Yapay zeka destekli belge analizi için güçlü bir desen olan Arama-Temelli Üretim, belgelerin tamamını yapay zekaya vermektense sadece verilen bir sorgu için ilgili bölümleri önceden alır ve bu bölümleri cevap üretiminde bağlam olarak kullanır.
RAG iş akışı üç ana aşamaya sahiptir: belge hazırlama (bölme ve gömülen oluşturma), arama (ilgili parçaların aranması) ve üretim (yapay zeka yanıtları için bağlam olarak alınan parçaların kullanılması).
Kod pdf.Memorize() çağırarak birden çok PDF'i indeksler, ardından cevapları birleştirilmiş belge belleğinden almak için pdf.Query() kullanır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;// Retrieval-Augmented Generation (RAG) system for querying across multiple indexed documents// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);// Index all documents in folderstring[] documentPaths = Directory.GetFiles("documents/", "*.pdf");Console.WriteLine($"Indexing {documentPaths.Length} documents...\n");// Memorize each document (creates embeddings for retrieval)foreach (string path in documentPaths){ var pdf = PdfDocument.FromFile(path); await pdf.Memorize();Console.WriteLine($"Indexed: {Path.GetFileName(path)} ({pdf.PageCount} pages)");}Console.WriteLine("\n=== RAG System Ready ===\n");// Query across all indexed documentsstring query = "What are the key compliance requirements for data retention?";Console.WriteLine($"Query: {query}\n");var searchPdf = PdfDocument.FromFile(documentPaths[0]);string answer = await searchPdf.Query(query);Console.WriteLine($"Answer: {answer}");// Interactive query loopConsole.WriteLine("\n--- Enter questions (type 'exit' to quit) ---\n");while (true){Console.Write("Question: "); string? userQuery = Console.ReadLine(); if (string.IsNullOrWhiteSpace(userQuery) || userQuery.ToLower() == "exit") break; string response = await searchPdf.Query(userQuery);Console.WriteLine($"\nAnswer: {response}\n");}
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;

// Retrieval-Augmented Generation (RAG) system for querying across multiple indexed documents

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Index all documents in folder
string[] documentPaths = Directory.GetFiles("documents/", "*.pdf");

Console.WriteLine($"Indexing {documentPaths.Length} documents...\n");

// Memorize each document (creates embeddings for retrieval)
foreach (string path in documentPaths)
{
    var pdf = PdfDocument.FromFile(path);
    await pdf.Memorize();
    Console.WriteLine($"Indexed: {Path.GetFileName(path)} ({pdf.PageCount} pages)");
}

Console.WriteLine("\n=== RAG System Ready ===\n");

// Query across all indexed documents
string query = "What are the key compliance requirements for data retention?";

Console.WriteLine($"Query: {query}\n");

var searchPdf = PdfDocument.FromFile(documentPaths[0]);
string answer = await searchPdf.Query(query);

Console.WriteLine($"Answer: {answer}");

// Interactive query loop
Console.WriteLine("\n--- Enter questions (type 'exit' to quit) ---\n");

while (true)
{
    Console.Write("Question: ");
    string? userQuery = Console.ReadLine();

    if (string.IsNullOrWhiteSpace(userQuery) || userQuery.ToLower() == "exit")
        break;

    string response = await searchPdf.Query(userQuery);
    Console.WriteLine($"\nAnswer: {response}\n");
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.IO' Retrieval-Augmented Generation (RAG) system for querying across multiple indexed documents' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)' Index all documents in folderDim documentPaths AsString() = Directory.GetFiles("documents/", "*.pdf")Console.WriteLine($"Indexing {documentPaths.Length} documents..." & vbCrLf)' Memorize each document (creates embeddings for retrieval)For Each path AsStringIn documentPaths Dim pdf = PdfDocument.FromFile(path)Await pdf.Memorize()Console.WriteLine($"Indexed: {Path.GetFileName(path)} ({pdf.PageCount} pages)")NextConsole.WriteLine(vbCrLf & "=== RAG System Ready ===" & vbCrLf)' Query across all indexed documentsDim query AsString = "What are the key compliance requirements for data retention?"Console.WriteLine($"Query: {query}" & vbCrLf)Dim searchPdf = PdfDocument.FromFile(documentPaths(0))Dim answer AsString = Await searchPdf.Query(query)Console.WriteLine($"Answer: {answer}")' Interactive query loopConsole.WriteLine(vbCrLf & "--- Enter questions (type 'exit' to quit) ---" & vbCrLf)While TrueConsole.Write("Question: ") Dim userQuery AsString = Console.ReadLine() IfString.IsNullOrWhiteSpace(userQuery) OrElse userQuery.ToLower() = "exit" ThenExitWhile End If Dim response AsString = Await searchPdf.Query(userQuery)Console.WriteLine(vbCrLf & $"Answer: {response}" & vbCrLf)EndWhile
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.IO

' Retrieval-Augmented Generation (RAG) system for querying across multiple indexed documents

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Index all documents in folder
Dim documentPaths As String() = Directory.GetFiles("documents/", "*.pdf")

Console.WriteLine($"Indexing {documentPaths.Length} documents..." & vbCrLf)

' Memorize each document (creates embeddings for retrieval)
For Each path As String In documentPaths
    Dim pdf = PdfDocument.FromFile(path)
    Await pdf.Memorize()
    Console.WriteLine($"Indexed: {Path.GetFileName(path)} ({pdf.PageCount} pages)")
Next

Console.WriteLine(vbCrLf & "=== RAG System Ready ===" & vbCrLf)

' Query across all indexed documents
Dim query As String = "What are the key compliance requirements for data retention?"

Console.WriteLine($"Query: {query}" & vbCrLf)

Dim searchPdf = PdfDocument.FromFile(documentPaths(0))
Dim answer As String = Await searchPdf.Query(query)

Console.WriteLine($"Answer: {answer}")

' Interactive query loop
Console.WriteLine(vbCrLf & "--- Enter questions (type 'exit' to quit) ---" & vbCrLf)

While True
    Console.Write("Question: ")
    Dim userQuery As String = Console.ReadLine()

    If String.IsNullOrWhiteSpace(userQuery) OrElse userQuery.ToLower() = "exit" Then
        Exit While
    End If

    Dim response As String = Await searchPdf.Query(userQuery)
    Console.WriteLine(vbCrLf & $"Answer: {response}" & vbCrLf)
End While
RAG sistemleri büyük belge koleksiyonlarını ele almada üstündür - hukuki dava veri tabanları, teknik dokümantasyon kütüphaneleri, araştırma arşivleri. Sadece ilgili parçaları alarak, cevap kalitesini korurken teorik olarak sınırsız belge boyutlarında etkili bir şekilde ölçeklenir.
PDF Sayfalarından Kaynak Gösterme
Profesyonel uygulamalar için yapay zeka yanıtları doğrulanabilir olmalıdır. Kaynak gösterme yaklaşımı, bölme ve alma sırasında parça kökenleri hakkında meta verileri sağlamaktadır. Her parça, yalnızca metin içeriğini değil, aynı zamanda kaynak sayfa numaralarını, bölüm başlıklarını ve belgedeki konumunu da saklar.
Girdi
Kod, alıntı talimatları ile pdf.Query() kullanır, ardından regex ile sayfa referanslarını ayrıştırmak ve kaynakları doğrulamak için ExtractCitedPages() kullanır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;using System.Text.RegularExpressions;// Answer questions with page citations and source verification// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);var pdf = PdfDocument.FromFile("sample-legal-document.pdf");await pdf.Memorize();string question = "What are the termination conditions in this agreement?";// Request citations in querystring citationQuery = $@"{question}T: Include specific page citations in your answer using the format (Page X) or (Pages X-Y).e information that appears in the document.";string answerWithCitations = await pdf.Query(citationQuery);Console.WriteLine("Question: " + question);Console.WriteLine("\nAnswer with Citations:");Console.WriteLine(answerWithCitations);// Extract cited page numbers using regexvar citedPages = ExtractCitedPages(answerWithCitations);Console.WriteLine($"\nCited pages: {string.Join(", ", citedPages)}");// Verify citations with page excerptsConsole.WriteLine("\n=== Source Verification ===");foreach (int pageNum in citedPages.Take(3)){ if (pageNum <= pdf.PageCount && pageNum > 0) { string pageText = pdf.Pages[pageNum - 1].Text; string excerpt = pageText.Length > 200 ? pageText.Substring(0, 200) + "..." : pageText;Console.WriteLine($"\nPage {pageNum} excerpt:\n{excerpt}"); }}// Extract page numbers from citation format (Page X) or (Pages X-Y)List<int> ExtractCitedPages(string text){ var pages = new HashSet<int>(); var matches = Regex.Matches(text, @"\(Pages?\s*(\d+)(?:\s*-\s*(\d+))?\)", RegexOptions.IgnoreCase); foreach (Match match in matches) { int startPage = int.Parse(match.Groups[1].Value); pages.Add(startPage); if (match.Groups[2].Success) { int endPage = int.Parse(match.Groups[2].Value); for (int p = startPage; p <= endPage; p++) pages.Add(p); } } return pages.OrderBy(p => p).ToList();}
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Text.RegularExpressions;

// Answer questions with page citations and source verification

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

var pdf = PdfDocument.FromFile("sample-legal-document.pdf");
await pdf.Memorize();

string question = "What are the termination conditions in this agreement?";

// Request citations in query
string citationQuery = $@"{question}

T: Include specific page citations in your answer using the format (Page X) or (Pages X-Y).
e information that appears in the document.";

string answerWithCitations = await pdf.Query(citationQuery);

Console.WriteLine("Question: " + question);
Console.WriteLine("\nAnswer with Citations:");
Console.WriteLine(answerWithCitations);

// Extract cited page numbers using regex
var citedPages = ExtractCitedPages(answerWithCitations);
Console.WriteLine($"\nCited pages: {string.Join(", ", citedPages)}");

// Verify citations with page excerpts
Console.WriteLine("\n=== Source Verification ===");
foreach (int pageNum in citedPages.Take(3))
{
    if (pageNum <= pdf.PageCount && pageNum > 0)
    {
        string pageText = pdf.Pages[pageNum - 1].Text;
        string excerpt = pageText.Length > 200 ? pageText.Substring(0, 200) + "..." : pageText;
        Console.WriteLine($"\nPage {pageNum} excerpt:\n{excerpt}");
    }
}

// Extract page numbers from citation format (Page X) or (Pages X-Y)
List<int> ExtractCitedPages(string text)
{
    var pages = new HashSet<int>();
    var matches = Regex.Matches(text, @"\(Pages?\s*(\d+)(?:\s*-\s*(\d+))?\)", RegexOptions.IgnoreCase);

    foreach (Match match in matches)
    {
        int startPage = int.Parse(match.Groups[1].Value);
        pages.Add(startPage);

        if (match.Groups[2].Success)
        {
            int endPage = int.Parse(match.Groups[2].Value);
            for (int p = startPage; p <= endPage; p++)
                pages.Add(p);
        }
    }
    return pages.OrderBy(p => p).ToList();
}
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Text.RegularExpressions' Answer questions with page citations and source verification' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)Dim pdf = PdfDocument.FromFile("sample-legal-document.pdf")Await pdf.Memorize()Dim question AsString = "What are the termination conditions in this agreement?"' Request citations in queryDim citationQuery AsString = $"{question}T: Include specific page citations in your answer using the format (Page X) or (Pages X-Y).e information that appears in the document."Dim answerWithCitations AsString = Await pdf.Query(citationQuery)Console.WriteLine("Question: " & question)Console.WriteLine(vbCrLf & "Answer with Citations:")Console.WriteLine(answerWithCitations)' Extract cited page numbers using regexDim citedPages = ExtractCitedPages(answerWithCitations)Console.WriteLine(vbCrLf & "Cited pages: " & String.Join(", ", citedPages))' Verify citations with page excerptsConsole.WriteLine(vbCrLf & "=== Source Verification ===")For Each pageNum AsIntegerIn citedPages.Take(3) If pageNum <= pdf.PageCountAndAlso pageNum > 0 Then Dim pageText AsString = pdf.Pages(pageNum - 1).Text Dim excerpt AsString = If(pageText.Length > 200, pageText.Substring(0, 200) & "...", pageText)Console.WriteLine(vbCrLf & "Page " & pageNum & " excerpt:" & vbCrLf & excerpt) End IfNext' Extract page numbers from citation format (Page X) or (Pages X-Y)FunctionExtractCitedPages(ByVal text AsString) AsList(OfInteger) Dim pages = New HashSet(OfInteger)() Dim matches = Regex.Matches(text, "\((Pages?)\s*(\d+)(?:\s*-\s*(\d+))?\)", RegexOptions.IgnoreCase) For Each match AsMatchIn matches Dim startPage AsInteger = Integer.Parse(match.Groups(2).Value) pages.Add(startPage) If match.Groups(3).SuccessThen Dim endPage AsInteger = Integer.Parse(match.Groups(3).Value) For p AsInteger = startPage To endPage pages.Add(p) Next End If Next Return pages.OrderBy(Function(p) p).ToList()End Function
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Text.RegularExpressions

' Answer questions with page citations and source verification

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

Dim pdf = PdfDocument.FromFile("sample-legal-document.pdf")
Await pdf.Memorize()

Dim question As String = "What are the termination conditions in this agreement?"

' Request citations in query
Dim citationQuery As String = $"{question}

T: Include specific page citations in your answer using the format (Page X) or (Pages X-Y).
e information that appears in the document."

Dim answerWithCitations As String = Await pdf.Query(citationQuery)

Console.WriteLine("Question: " & question)
Console.WriteLine(vbCrLf & "Answer with Citations:")
Console.WriteLine(answerWithCitations)

' Extract cited page numbers using regex
Dim citedPages = ExtractCitedPages(answerWithCitations)
Console.WriteLine(vbCrLf & "Cited pages: " & String.Join(", ", citedPages))

' Verify citations with page excerpts
Console.WriteLine(vbCrLf & "=== Source Verification ===")
For Each pageNum As Integer In citedPages.Take(3)
    If pageNum <= pdf.PageCount AndAlso pageNum > 0 Then
        Dim pageText As String = pdf.Pages(pageNum - 1).Text
        Dim excerpt As String = If(pageText.Length > 200, pageText.Substring(0, 200) & "...", pageText)
        Console.WriteLine(vbCrLf & "Page " & pageNum & " excerpt:" & vbCrLf & excerpt)
    End If
Next

' Extract page numbers from citation format (Page X) or (Pages X-Y)
Function ExtractCitedPages(ByVal text As String) As List(Of Integer)
    Dim pages = New HashSet(Of Integer)()
    Dim matches = Regex.Matches(text, "\((Pages?)\s*(\d+)(?:\s*-\s*(\d+))?\)", RegexOptions.IgnoreCase)

    For Each match As Match In matches
        Dim startPage As Integer = Integer.Parse(match.Groups(2).Value)
        pages.Add(startPage)

        If match.Groups(3).Success Then
            Dim endPage As Integer = Integer.Parse(match.Groups(3).Value)
            For p As Integer = startPage To endPage
                pages.Add(p)
            Next
        End If
    Next
    Return pages.OrderBy(Function(p) p).ToList()
End Function
Konsol Çıkış
Kaynaklar, yapay zeka tarafından üretilen yanıtları opak çıktılardan şeffaf, doğrulanabilir bilgilere dönüştürür. Kullanıcılar kaynak materyali gözden geçirerek yanıtları doğrulamak ve yapay zeka destekli analize güven duymak için inceleyebilirler.
Toplu Yapay Zeka İşleme
Belge Kütüphanelerini Ölçekte İşleme
Kurumsal belge işlemi genellikle binlerce veya milyonlarca PDF'yi kapsar. Ölçeklenebilir toplu işlemenin temeli paralelleştirmedir. IronPDF, eşzamanlı PDF işlemiyle çapraz etkileşime izin veren thread-safe'tir.
Bu kod, SemaphoreSlim yapılandırılabilir maxConcurrency ile çoklu işleme yaparak her birini pdf.Summarize()'e çağırır ve sonuçları ConcurrentBag ile takip eder.
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System;
using System.Collections.Concurrent;
using System.Text;

// Process multiple documents in parallel with rate limiting

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Configure parallel processing with rate limiting
int maxConcurrency = 3;
string inputFolder = "documents/";
string outputFolder = "summaries/";

Directory.CreateDirectory(outputFolder);

string[] pdfFiles = Directory.GetFiles(inputFolder, "*.pdf");
Console.WriteLine($"Processing {pdfFiles.Length} documents...\n");

var results = new ConcurrentBag<ProcessingResult>();
var semaphore = new SemaphoreSlim(maxConcurrency);

var tasks = pdfFiles.Select(async filePath =>
{
    await semaphore.WaitAsync();
    var result = new ProcessingResult { FilePath = filePath };

    try
    {
        var stopwatch = System.Diagnostics.Stopwatch.StartNew();

        var pdf = PdfDocument.FromFile(filePath);
        string summary = await pdf.Summarize();

        string outputPath = Path.Combine(outputFolder,
            Path.GetFileNameWithoutExtension(filePath) + "-summary.txt");
        await File.WriteAllTextAsync(outputPath, summary);

        stopwatch.Stop();
        result.Success = true;
        result.ProcessingTime = stopwatch.Elapsed;
        result.OutputPath = outputPath;

        Console.WriteLine($"[OK] {Path.GetFileName(filePath)} ({stopwatch.ElapsedMilliseconds}ms)");
    }
    catch (Exception ex)
    {
        result.Success = false;
        result.ErrorMessage = ex.Message;
        Console.WriteLine($"[ERROR] {Path.GetFileName(filePath)}: {ex.Message}");
    }
    finally
    {
        semaphore.Release();
        results.Add(result);
    }
}).ToArray();

await Task.WhenAll(tasks);

// Generate processing report
var successful = results.Where(r => r.Success).ToList();
var failed = results.Where(r => !r.Success).ToList();

var report = new StringBuilder();
report.AppendLine("=== Batch Processing Report ===");
report.AppendLine($"Successful: {successful.Count}");
report.AppendLine($"Failed: {failed.Count}");

if (successful.Any())
{
    var avgTime = TimeSpan.FromMilliseconds(successful.Average(r => r.ProcessingTime.TotalMilliseconds));
    report.AppendLine($"Average processing time: {avgTime.TotalSeconds:F1}s");
}

if (failed.Any())
{
    report.AppendLine("\nFailed documents:");
    foreach (var fail in failed)
        report.AppendLine($"  - {Path.GetFileName(fail.FilePath)}: {fail.ErrorMessage}");
}

string reportText = report.ToString();
Console.WriteLine($"\n{reportText}");
File.WriteAllText(Path.Combine(outputFolder, "processing-report.txt"), reportText);


s ProcessingResult

public string FilePath { get; set; } = "";
public bool Success { get; set; }
public TimeSpan ProcessingTime { get; set; }
public string OutputPath { get; set; } = "";
public string ErrorMessage { get; set; } = "";
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystemImportsSystem.Collections.ConcurrentImportsSystem.TextImportsSystem.IOImportsSystem.LinqImportsSystem.ThreadingImportsSystem.Threading.Tasks' Process multiple documents in parallel with rate limiting' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)' Configure parallel processing with rate limitingDim maxConcurrency AsInteger = 3Dim inputFolder AsString = "documents/"Dim outputFolder AsString = "summaries/"Directory.CreateDirectory(outputFolder)Dim pdfFiles AsString() = Directory.GetFiles(inputFolder, "*.pdf")Console.WriteLine($"Processing {pdfFiles.Length} documents...{vbCrLf}")Dim results = New ConcurrentBag(OfProcessingResult)()Dim semaphore = New SemaphoreSlim(maxConcurrency)Dim tasks = pdfFiles.Select(Async Function(filePath)Await semaphore.WaitAsync() Dim result = New ProcessingResultWith {.FilePath = filePath}Try Dim stopwatch = System.Diagnostics.Stopwatch.StartNew() Dim pdf = PdfDocument.FromFile(filePath) Dim summary AsString = Await pdf.Summarize() Dim outputPath = Path.Combine(outputFolder, Path.GetFileNameWithoutExtension(filePath) & "-summary.txt")AwaitFile.WriteAllTextAsync(outputPath, summary) stopwatch.Stop() result.Success = True result.ProcessingTime = stopwatch.Elapsed result.OutputPath = outputPathConsole.WriteLine($"[OK] {Path.GetFileName(filePath)} ({stopwatch.ElapsedMilliseconds}ms)")Catch ex AsException result.Success = False result.ErrorMessage = ex.MessageConsole.WriteLine($"[ERROR] {Path.GetFileName(filePath)}: {ex.Message}")Finally semaphore.Release() results.Add(result)EndTry End Function).ToArray()AwaitTask.WhenAll(tasks)' Generate processing reportDim successful = results.Where(Function(r) r.Success).ToList()Dim failed = results.Where(Function(r) Not r.Success).ToList()Dim report = New StringBuilder()report.AppendLine("=== Batch Processing Report ===")report.AppendLine($"Successful: {successful.Count}")report.AppendLine($"Failed: {failed.Count}")If successful.Any() Then Dim avgTime = TimeSpan.FromMilliseconds(successful.Average(Function(r) r.ProcessingTime.TotalMilliseconds)) report.AppendLine($"Average processing time: {avgTime.TotalSeconds:F1}s")End IfIf failed.Any() Then report.AppendLine($"{vbCrLf}Failed documents:") For Each fail In failed report.AppendLine($" - {Path.GetFileName(fail.FilePath)}: {fail.ErrorMessage}") NextEnd IfDim reportText AsString = report.ToString()Console.WriteLine($"{vbCrLf}{reportText}")File.WriteAllText(Path.Combine(outputFolder, "processing-report.txt"), reportText)Public Class ProcessingResult Public Property FilePathAsString = "" Public Property SuccessAsBoolean Public Property ProcessingTimeAsTimeSpan Public Property OutputPathAsString = "" Public Property ErrorMessageAsString = ""End Class
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System
Imports System.Collections.Concurrent
Imports System.Text
Imports System.IO
Imports System.Linq
Imports System.Threading
Imports System.Threading.Tasks

' Process multiple documents in parallel with rate limiting

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Configure parallel processing with rate limiting
Dim maxConcurrency As Integer = 3
Dim inputFolder As String = "documents/"
Dim outputFolder As String = "summaries/"

Directory.CreateDirectory(outputFolder)

Dim pdfFiles As String() = Directory.GetFiles(inputFolder, "*.pdf")
Console.WriteLine($"Processing {pdfFiles.Length} documents...{vbCrLf}")

Dim results = New ConcurrentBag(Of ProcessingResult)()
Dim semaphore = New SemaphoreSlim(maxConcurrency)

Dim tasks = pdfFiles.Select(Async Function(filePath)
                                Await semaphore.WaitAsync()
                                Dim result = New ProcessingResult With {.FilePath = filePath}

                                Try
                                    Dim stopwatch = System.Diagnostics.Stopwatch.StartNew()

                                    Dim pdf = PdfDocument.FromFile(filePath)
                                    Dim summary As String = Await pdf.Summarize()

                                    Dim outputPath = Path.Combine(outputFolder, Path.GetFileNameWithoutExtension(filePath) & "-summary.txt")
                                    Await File.WriteAllTextAsync(outputPath, summary)

                                    stopwatch.Stop()
                                    result.Success = True
                                    result.ProcessingTime = stopwatch.Elapsed
                                    result.OutputPath = outputPath

                                    Console.WriteLine($"[OK] {Path.GetFileName(filePath)} ({stopwatch.ElapsedMilliseconds}ms)")
                                Catch ex As Exception
                                    result.Success = False
                                    result.ErrorMessage = ex.Message
                                    Console.WriteLine($"[ERROR] {Path.GetFileName(filePath)}: {ex.Message}")
                                Finally
                                    semaphore.Release()
                                    results.Add(result)
                                End Try
                            End Function).ToArray()

Await Task.WhenAll(tasks)

' Generate processing report
Dim successful = results.Where(Function(r) r.Success).ToList()
Dim failed = results.Where(Function(r) Not r.Success).ToList()

Dim report = New StringBuilder()
report.AppendLine("=== Batch Processing Report ===")
report.AppendLine($"Successful: {successful.Count}")
report.AppendLine($"Failed: {failed.Count}")

If successful.Any() Then
    Dim avgTime = TimeSpan.FromMilliseconds(successful.Average(Function(r) r.ProcessingTime.TotalMilliseconds))
    report.AppendLine($"Average processing time: {avgTime.TotalSeconds:F1}s")
End If

If failed.Any() Then
    report.AppendLine($"{vbCrLf}Failed documents:")
    For Each fail In failed
        report.AppendLine($"  - {Path.GetFileName(fail.FilePath)}: {fail.ErrorMessage}")
    Next
End If

Dim reportText As String = report.ToString()
Console.WriteLine($"{vbCrLf}{reportText}")
File.WriteAllText(Path.Combine(outputFolder, "processing-report.txt"), reportText)

Public Class ProcessingResult
    Public Property FilePath As String = ""
    Public Property Success As Boolean
    Public Property ProcessingTime As TimeSpan
    Public Property OutputPath As String = ""
    Public Property ErrorMessage As String = ""
End Class
Ölçekte sağlam hata yönetimi kritiktir. Üretim sistemleri, üstel geri dönüşlerle yeniden deneme mantığı uygular, başarısız belgeler için ayrı hata kaydı yapar ve devam ettirilebilir proses sağlar.
Maliyet Yönetimi ve Jeton Kullanımı
Yapay zeka API maliyetleri tipik olarak her jeton başına hesaplanır. 2026'da GPT-5, her milyon giriş jetonu için 1,25 $ ve her milyon çıkış jetonu için 10 $ ücretlendirilirken, Claude Sonnet 4.5 ise her milyon giriş jetonu için 3 $ ve her milyon çıkış jetonu için 15 $ maliyetindedir. Birincil maliyet optimizasyon stratejisi gereksiz jeton kullanımını en aza indirmektir.
OpenAI'in Batch API'si, işlem süreleri karşılığında (24 saate kadar) jeton maliyetlerinde %50 indirim sunar. Gecelik işlemler veya dönemsel analizler için toplu işlem önemli tasarruflar sağlar.
Kod pdf.ExtractAllText() kullanarak metni çıkarır, JSONL toplu istekler oluşturur, OpenAI dosya uç noktasına HttpClient ile yükler ve toplu API'ye gönderir.
using IronPdf;using System.Text.Json;using System.Net.Http.Headers;// Use OpenAI Batch API for 50% cost savings on large-scale document processingstring openAiApiKey = "your-openai-api-key";string inputFolder = "documents/";// Prepare batch requests in JSONL formatvar batchRequests = new List<string>();string[] pdfFiles = Directory.GetFiles(inputFolder, "*.pdf");Console.WriteLine($"Preparing batch for {pdfFiles.Length} documents...\n");foreach (string filePath in pdfFiles){ var pdf = PdfDocument.FromFile(filePath); string pdfText = pdf.ExtractAllText(); // Truncate to stay within batch API limits if (pdfText.Length > 100000) pdfText = pdfText.Substring(0, 100000) + "\n[Truncated...]"; var request = new { custom_id = Path.GetFileNameWithoutExtension(filePath), method = "POST", url = "/v1/chat/completions", body = new { model = "gpt-4o", messages = new[] { new { role = "system", content = "Summarize the following document concisely." }, new { role = "user", content = pdfText } }, max_tokens = 1000 } }; batchRequests.Add(JsonSerializer.Serialize(request));}// Create JSONL filestring batchFilePath = "batch-requests.jsonl";File.WriteAllLines(batchFilePath, batchRequests);Console.WriteLine($"Created batch file with {batchRequests.Count} requests");// Upload file to OpenAIusing var httpClient = new HttpClient();httpClient.DefaultRequestHeaders.Authorization = new AuthenticationHeaderValue("Bearer", openAiApiKey);using var fileContent = new MultipartFormDataContent();fileContent.Add(new ByteArrayContent(File.ReadAllBytes(batchFilePath)), "file", "batch-requests.jsonl");fileContent.Add(new StringContent("batch"), "purpose");var uploadResponse = await httpClient.PostAsync("https://api.openai.com/v1/files", fileContent);var uploadResult = JsonSerializer.Deserialize<JsonElement>(await uploadResponse.Content.ReadAsStringAsync());string fileId = uploadResult.GetProperty("id").GetString()!;Console.WriteLine($"Uploaded file: {fileId}");// Create batch job (24-hour completion window for 50% discount)var batchJobRequest = new{ input_file_id = fileId, endpoint = "/v1/chat/completions", completion_window = "24h"};var batchResponse = await httpClient.PostAsync( "https://api.openai.com/v1/batches", new StringContent(JsonSerializer.Serialize(batchJobRequest), System.Text.Encoding.UTF8, "application/json"));var batchResult = JsonSerializer.Deserialize<JsonElement>(await batchResponse.Content.ReadAsStringAsync());string batchId = batchResult.GetProperty("id").GetString()!;Console.WriteLine($"\nBatch job created: {batchId}");Console.WriteLine("Job will complete within 24 hours");Console.WriteLine($"Check status: GET https://api.openai.com/v1/batches/{batchId}");File.WriteAllText("batch-job-id.txt", batchId);Console.WriteLine("\nBatch ID saved to batch-job-id.txt");
using IronPdf;
using System.Text.Json;
using System.Net.Http.Headers;

// Use OpenAI Batch API for 50% cost savings on large-scale document processing

string openAiApiKey = "your-openai-api-key";
string inputFolder = "documents/";

// Prepare batch requests in JSONL format
var batchRequests = new List<string>();
string[] pdfFiles = Directory.GetFiles(inputFolder, "*.pdf");

Console.WriteLine($"Preparing batch for {pdfFiles.Length} documents...\n");

foreach (string filePath in pdfFiles)
{
    var pdf = PdfDocument.FromFile(filePath);
    string pdfText = pdf.ExtractAllText();

    // Truncate to stay within batch API limits
    if (pdfText.Length > 100000)
        pdfText = pdfText.Substring(0, 100000) + "\n[Truncated...]";

    var request = new
    {
        custom_id = Path.GetFileNameWithoutExtension(filePath),
        method = "POST",
        url = "/v1/chat/completions",
        body = new
        {
            model = "gpt-4o",
            messages = new[]
            {
                new { role = "system", content = "Summarize the following document concisely." },
                new { role = "user", content = pdfText }
            },
            max_tokens = 1000
        }
    };

    batchRequests.Add(JsonSerializer.Serialize(request));
}

// Create JSONL file
string batchFilePath = "batch-requests.jsonl";
File.WriteAllLines(batchFilePath, batchRequests);
Console.WriteLine($"Created batch file with {batchRequests.Count} requests");

// Upload file to OpenAI
using var httpClient = new HttpClient();
httpClient.DefaultRequestHeaders.Authorization = new AuthenticationHeaderValue("Bearer", openAiApiKey);

using var fileContent = new MultipartFormDataContent();
fileContent.Add(new ByteArrayContent(File.ReadAllBytes(batchFilePath)), "file", "batch-requests.jsonl");
fileContent.Add(new StringContent("batch"), "purpose");

var uploadResponse = await httpClient.PostAsync("https://api.openai.com/v1/files", fileContent);
var uploadResult = JsonSerializer.Deserialize<JsonElement>(await uploadResponse.Content.ReadAsStringAsync());
string fileId = uploadResult.GetProperty("id").GetString()!;
Console.WriteLine($"Uploaded file: {fileId}");

// Create batch job (24-hour completion window for 50% discount)
var batchJobRequest = new
{
    input_file_id = fileId,
    endpoint = "/v1/chat/completions",
    completion_window = "24h"
};

var batchResponse = await httpClient.PostAsync(
    "https://api.openai.com/v1/batches",
    new StringContent(JsonSerializer.Serialize(batchJobRequest), System.Text.Encoding.UTF8, "application/json")
);

var batchResult = JsonSerializer.Deserialize<JsonElement>(await batchResponse.Content.ReadAsStringAsync());
string batchId = batchResult.GetProperty("id").GetString()!;

Console.WriteLine($"\nBatch job created: {batchId}");
Console.WriteLine("Job will complete within 24 hours");
Console.WriteLine($"Check status: GET https://api.openai.com/v1/batches/{batchId}");

File.WriteAllText("batch-job-id.txt", batchId);
Console.WriteLine("\nBatch ID saved to batch-job-id.txt");
ImportsIronPdfImportsSystem.Text.JsonImportsSystem.Net.Http.Headers' Use OpenAI Batch API for 50% cost savings on large-scale document processingDim openAiApiKey AsString = "your-openai-api-key"Dim inputFolder AsString = "documents/"' Prepare batch requests in JSONL formatDim batchRequests As New List(OfString)()Dim pdfFiles AsString() = Directory.GetFiles(inputFolder, "*.pdf")Console.WriteLine($"Preparing batch for {pdfFiles.Length} documents..." & vbCrLf)For Each filePath AsStringIn pdfFiles Dim pdf = PdfDocument.FromFile(filePath) Dim pdfText AsString = pdf.ExtractAllText() ' Truncate to stay within batch API limits If pdfText.Length > 100000 Then pdfText = pdfText.Substring(0, 100000) & vbCrLf & "[Truncated...]" End If Dim request = New With { .custom_id = Path.GetFileNameWithoutExtension(filePath), .method = "POST", .url = "/v1/chat/completions", .body = New With { .model = "gpt-4o", .messages = New Object() { New With {.role = "system", .content = "Summarize the following document concisely."}, New With {.role = "user", .content = pdfText} }, .max_tokens = 1000 } } batchRequests.Add(JsonSerializer.Serialize(request))Next' Create JSONL fileDim batchFilePath AsString = "batch-requests.jsonl"File.WriteAllLines(batchFilePath, batchRequests)Console.WriteLine($"Created batch file with {batchRequests.Count} requests")' Upload file to OpenAIUsing httpClient As New HttpClient() httpClient.DefaultRequestHeaders.Authorization = New AuthenticationHeaderValue("Bearer", openAiApiKey)Using fileContent As New MultipartFormDataContent() fileContent.Add(New ByteArrayContent(File.ReadAllBytes(batchFilePath)), "file", "batch-requests.jsonl") fileContent.Add(New StringContent("batch"), "purpose") Dim uploadResponse = Await httpClient.PostAsync("https://api.openai.com/v1/files", fileContent) Dim uploadResult = JsonSerializer.Deserialize(OfJsonElement)(Await uploadResponse.Content.ReadAsStringAsync()) Dim fileId AsString = uploadResult.GetProperty("id").GetString()Console.WriteLine($"Uploaded file: {fileId}") ' Create batch job (24-hour completion window for 50% discount) Dim batchJobRequest = New With { .input_file_id = fileId, .endpoint = "/v1/chat/completions", .completion_window = "24h" } Dim batchResponse = Await httpClient.PostAsync( "https://api.openai.com/v1/batches", New StringContent(JsonSerializer.Serialize(batchJobRequest), System.Text.Encoding.UTF8, "application/json") ) Dim batchResult = JsonSerializer.Deserialize(OfJsonElement)(Await batchResponse.Content.ReadAsStringAsync()) Dim batchId AsString = batchResult.GetProperty("id").GetString()Console.WriteLine(vbCrLf & $"Batch job created: {batchId}")Console.WriteLine("Job will complete within 24 hours")Console.WriteLine($"Check status: GET https://api.openai.com/v1/batches/{batchId}")File.WriteAllText("batch-job-id.txt", batchId)Console.WriteLine(vbCrLf & "Batch ID saved to batch-job-id.txt")EndUsingEndUsing
Imports IronPdf
Imports System.Text.Json
Imports System.Net.Http.Headers

' Use OpenAI Batch API for 50% cost savings on large-scale document processing

Dim openAiApiKey As String = "your-openai-api-key"
Dim inputFolder As String = "documents/"

' Prepare batch requests in JSONL format
Dim batchRequests As New List(Of String)()
Dim pdfFiles As String() = Directory.GetFiles(inputFolder, "*.pdf")

Console.WriteLine($"Preparing batch for {pdfFiles.Length} documents..." & vbCrLf)

For Each filePath As String In pdfFiles
    Dim pdf = PdfDocument.FromFile(filePath)
    Dim pdfText As String = pdf.ExtractAllText()

    ' Truncate to stay within batch API limits
    If pdfText.Length > 100000 Then
        pdfText = pdfText.Substring(0, 100000) & vbCrLf & "[Truncated...]"
    End If

    Dim request = New With {
        .custom_id = Path.GetFileNameWithoutExtension(filePath),
        .method = "POST",
        .url = "/v1/chat/completions",
        .body = New With {
            .model = "gpt-4o",
            .messages = New Object() {
                New With {.role = "system", .content = "Summarize the following document concisely."},
                New With {.role = "user", .content = pdfText}
            },
            .max_tokens = 1000
        }
    }

    batchRequests.Add(JsonSerializer.Serialize(request))
Next

' Create JSONL file
Dim batchFilePath As String = "batch-requests.jsonl"
File.WriteAllLines(batchFilePath, batchRequests)
Console.WriteLine($"Created batch file with {batchRequests.Count} requests")

' Upload file to OpenAI
Using httpClient As New HttpClient()
    httpClient.DefaultRequestHeaders.Authorization = New AuthenticationHeaderValue("Bearer", openAiApiKey)

    Using fileContent As New MultipartFormDataContent()
        fileContent.Add(New ByteArrayContent(File.ReadAllBytes(batchFilePath)), "file", "batch-requests.jsonl")
        fileContent.Add(New StringContent("batch"), "purpose")

        Dim uploadResponse = Await httpClient.PostAsync("https://api.openai.com/v1/files", fileContent)
        Dim uploadResult = JsonSerializer.Deserialize(Of JsonElement)(Await uploadResponse.Content.ReadAsStringAsync())
        Dim fileId As String = uploadResult.GetProperty("id").GetString()
        Console.WriteLine($"Uploaded file: {fileId}")

        ' Create batch job (24-hour completion window for 50% discount)
        Dim batchJobRequest = New With {
            .input_file_id = fileId,
            .endpoint = "/v1/chat/completions",
            .completion_window = "24h"
        }

        Dim batchResponse = Await httpClient.PostAsync(
            "https://api.openai.com/v1/batches",
            New StringContent(JsonSerializer.Serialize(batchJobRequest), System.Text.Encoding.UTF8, "application/json")
        )

        Dim batchResult = JsonSerializer.Deserialize(Of JsonElement)(Await batchResponse.Content.ReadAsStringAsync())
        Dim batchId As String = batchResult.GetProperty("id").GetString()

        Console.WriteLine(vbCrLf & $"Batch job created: {batchId}")
        Console.WriteLine("Job will complete within 24 hours")
        Console.WriteLine($"Check status: GET https://api.openai.com/v1/batches/{batchId}")

        File.WriteAllText("batch-job-id.txt", batchId)
        Console.WriteLine(vbCrLf & "Batch ID saved to batch-job-id.txt")
    End Using
End Using
Üretimde jeton kullanımını izlemek esastır. Birçok kuruluş, belgelerinin %80'inin daha küçük, daha ucuz modellerle işlenebileceğini, pahalı modellerin yalnızca karmaşık durumlar için ayrılabileceğini keşfeder.
Önbellekleme ve Artımlı İşleme
Artımlı olarak güncellenen belge koleksiyonları için, zekice önbellekleme ve artımlı işleme stratejileri maliyetleri dramatik bir şekilde azaltır. Belge düzeyinde önbellekleme, değiştirilmemiş belgelerin gereksiz yeniden işlenmesini önleyerek, sonuçları kaynağın PDF'siyle birlikte bir karma olarak saklar.
DocumentCacheManager sınıfı ComputeFileHash() ile SHA256 kullanarak değişiklikleri algılar, sonuçları CacheEntry nesnelerine LastAccessed zaman damgaları ile depolar.
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System;
using System.Collections.Generic;
using System.Security.Cryptography;
using System.Text.Json;

// Cache AI processing results using file hashes to avoid reprocessing unchanged documents

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Configure caching
string cacheFolder = "ai-cache/";
string documentsFolder = "documents/";

Directory.CreateDirectory(cacheFolder);

var cacheManager = new DocumentCacheManager(cacheFolder);

// Process documents with caching
string[] pdfFiles = Directory.GetFiles(documentsFolder, "*.pdf");
int cached = 0, processed = 0;

foreach (string filePath in pdfFiles)
{
    string fileName = Path.GetFileName(filePath);
    string fileHash = cacheManager.ComputeFileHash(filePath);

    var cachedResult = cacheManager.GetCachedResult(fileName, fileHash);

    if (cachedResult != null)
    {
        Console.WriteLine($"[CACHE HIT] {fileName}");
        cached++;
        continue;
    }

    Console.WriteLine($"[PROCESSING] {fileName}");
    var pdf = PdfDocument.FromFile(filePath);
    string summary = await pdf.Summarize();

    cacheManager.CacheResult(fileName, fileHash, summary);
    processed++;
}

Console.WriteLine($"\nProcessing complete: {cached} cached, {processed} newly processed");
Console.WriteLine($"Cost savings: {(cached * 100.0 / Math.Max(1, cached + processed)):F1}% served from cache");


ash-based cache manager with JSON index
s DocumentCacheManager

private readonly string _cacheFolder;
private readonly string _indexPath;
private Dictionary<string, CacheEntry> _index;

public DocumentCacheManager(string cacheFolder)
{
    _cacheFolder = cacheFolder;
    _indexPath = Path.Combine(cacheFolder, "cache-index.json");
    _index = LoadIndex();
}

private Dictionary<string, CacheEntry> LoadIndex()
{
    if (File.Exists(_indexPath))
    {
        string json = File.ReadAllText(_indexPath);
        return JsonSerializer.Deserialize<Dictionary<string, CacheEntry>>(json) ?? new();
    }
    return new Dictionary<string, CacheEntry>();
}

private void SaveIndex()
{
    string json = JsonSerializer.Serialize(_index, new JsonSerializerOptions { WriteIndented = true });
    File.WriteAllText(_indexPath, json);
}

// SHA256 hash to detect file changes
public string ComputeFileHash(string filePath)
{
    using var sha256 = SHA256.Create();
    using var stream = File.OpenRead(filePath);
    byte[] hash = sha256.ComputeHash(stream);
    return Convert.ToHexString(hash);
}

public string? GetCachedResult(string fileName, string currentHash)
{
    if (_index.TryGetValue(fileName, out var entry))
    {
        if (entry.FileHash == currentHash && File.Exists(entry.CachePath))
        {
            entry.LastAccessed = DateTime.UtcNow;
            SaveIndex();
            return File.ReadAllText(entry.CachePath);
        }
    }
    return null;
}

public void CacheResult(string fileName, string fileHash, string result)
{
    string cachePath = Path.Combine(_cacheFolder, $"{Path.GetFileNameWithoutExtension(fileName)}-{fileHash[..8]}.txt");
    File.WriteAllText(cachePath, result);

    _index[fileName] = new CacheEntry
    {
        FileHash = fileHash,
        CachePath = cachePath,
        CreatedAt = DateTime.UtcNow,
        LastAccessed = DateTime.UtcNow
    };

    SaveIndex();
}


s CacheEntry

public string FileHash { get; set; } = "";
public string CachePath { get; set; } = "";
public DateTime CreatedAt { get; set; }
public DateTime LastAccessed { get; set; }
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystemImportsSystem.Collections.GenericImportsSystem.Security.CryptographyImportsSystem.Text.Json' Cache AI processing results using file hashes to avoid reprocessing unchanged documents' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)' Configure cachingDim cacheFolder AsString = "ai-cache/"Dim documentsFolder AsString = "documents/"Directory.CreateDirectory(cacheFolder)Dim cacheManager = New DocumentCacheManager(cacheFolder)' Process documents with cachingDim pdfFiles AsString() = Directory.GetFiles(documentsFolder, "*.pdf")Dim cached AsInteger = 0, processed AsInteger = 0For Each filePath AsStringIn pdfFiles Dim fileName AsString = Path.GetFileName(filePath) Dim fileHash AsString = cacheManager.ComputeFileHash(filePath) Dim cachedResult AsString = cacheManager.GetCachedResult(fileName, fileHash) If cachedResult IsNot Nothing ThenConsole.WriteLine($"[CACHE HIT] {fileName}") cached += 1 Continue For End IfConsole.WriteLine($"[PROCESSING] {fileName}") Dim pdf = PdfDocument.FromFile(filePath) Dim summary AsString = Await pdf.Summarize() cacheManager.CacheResult(fileName, fileHash, summary) processed += 1NextConsole.WriteLine(vbCrLf & $"Processing complete: {cached} cached, {processed} newly processed")Console.WriteLine($"Cost savings: {(cached * 100.0 / Math.Max(1, cached + processed)):F1}% served from cache")' Hash-based cache manager with JSON indexPublic Class DocumentCacheManager PrivateReadOnly _cacheFolder AsString PrivateReadOnly _indexPath AsString Private _index AsDictionary(OfString, CacheEntry) Public Sub New(cacheFolder AsString) _cacheFolder = cacheFolder _indexPath = Path.Combine(cacheFolder, "cache-index.json") _index = LoadIndex() End Sub Private Function LoadIndex() AsDictionary(OfString, CacheEntry) IfFile.Exists(_indexPath) Then Dim json AsString = File.ReadAllText(_indexPath) ReturnJsonSerializer.Deserialize(OfDictionary(OfString, CacheEntry))(json) OrElse New Dictionary(OfString, CacheEntry)() End If Return New Dictionary(OfString, CacheEntry)() End Function Private Sub SaveIndex() Dim json AsString = JsonSerializer.Serialize(_index, New JsonSerializerOptionsWith {.WriteIndented = True})File.WriteAllText(_indexPath, json) End Sub ' SHA256 hash to detect file changes Public Function ComputeFileHash(filePath AsString) AsStringUsing sha256 = SHA256.Create()Using stream = File.OpenRead(filePath) Dim hash AsByte() = sha256.ComputeHash(stream) ReturnConvert.ToHexString(hash)EndUsingEndUsing End Function Public Function GetCachedResult(fileName AsString, currentHash AsString) AsString If _index.TryGetValue(fileName, entry) Then If entry.FileHash = currentHash AndAlsoFile.Exists(entry.CachePath) Then entry.LastAccessed = DateTime.UtcNowSaveIndex() ReturnFile.ReadAllText(entry.CachePath) End If End If Return Nothing End Function Public Sub CacheResult(fileName AsString, fileHash AsString, result AsString) Dim cachePath AsString = Path.Combine(_cacheFolder, $"{Path.GetFileNameWithoutExtension(fileName)}-{fileHash.Substring(0, 8)}.txt")File.WriteAllText(cachePath, result) _index(fileName) = New CacheEntryWith { .FileHash = fileHash, .CachePath = cachePath, .CreatedAt = DateTime.UtcNow, .LastAccessed = DateTime.UtcNow }SaveIndex() End SubEnd ClassPublic Class CacheEntry Public Property FileHashAsString = "" Public Property CachePathAsString = "" Public Property CreatedAtAsDateTime Public Property LastAccessedAsDateTimeEnd Class
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System
Imports System.Collections.Generic
Imports System.Security.Cryptography
Imports System.Text.Json

' Cache AI processing results using file hashes to avoid reprocessing unchanged documents

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Configure caching
Dim cacheFolder As String = "ai-cache/"
Dim documentsFolder As String = "documents/"

Directory.CreateDirectory(cacheFolder)

Dim cacheManager = New DocumentCacheManager(cacheFolder)

' Process documents with caching
Dim pdfFiles As String() = Directory.GetFiles(documentsFolder, "*.pdf")
Dim cached As Integer = 0, processed As Integer = 0

For Each filePath As String In pdfFiles
    Dim fileName As String = Path.GetFileName(filePath)
    Dim fileHash As String = cacheManager.ComputeFileHash(filePath)

    Dim cachedResult As String = cacheManager.GetCachedResult(fileName, fileHash)

    If cachedResult IsNot Nothing Then
        Console.WriteLine($"[CACHE HIT] {fileName}")
        cached += 1
        Continue For
    End If

    Console.WriteLine($"[PROCESSING] {fileName}")
    Dim pdf = PdfDocument.FromFile(filePath)
    Dim summary As String = Await pdf.Summarize()

    cacheManager.CacheResult(fileName, fileHash, summary)
    processed += 1
Next

Console.WriteLine(vbCrLf & $"Processing complete: {cached} cached, {processed} newly processed")
Console.WriteLine($"Cost savings: {(cached * 100.0 / Math.Max(1, cached + processed)):F1}% served from cache")

' Hash-based cache manager with JSON index
Public Class DocumentCacheManager

    Private ReadOnly _cacheFolder As String
    Private ReadOnly _indexPath As String
    Private _index As Dictionary(Of String, CacheEntry)

    Public Sub New(cacheFolder As String)
        _cacheFolder = cacheFolder
        _indexPath = Path.Combine(cacheFolder, "cache-index.json")
        _index = LoadIndex()
    End Sub

    Private Function LoadIndex() As Dictionary(Of String, CacheEntry)
        If File.Exists(_indexPath) Then
            Dim json As String = File.ReadAllText(_indexPath)
            Return JsonSerializer.Deserialize(Of Dictionary(Of String, CacheEntry))(json) OrElse New Dictionary(Of String, CacheEntry)()
        End If
        Return New Dictionary(Of String, CacheEntry)()
    End Function

    Private Sub SaveIndex()
        Dim json As String = JsonSerializer.Serialize(_index, New JsonSerializerOptions With {.WriteIndented = True})
        File.WriteAllText(_indexPath, json)
    End Sub

    ' SHA256 hash to detect file changes
    Public Function ComputeFileHash(filePath As String) As String
        Using sha256 = SHA256.Create()
            Using stream = File.OpenRead(filePath)
                Dim hash As Byte() = sha256.ComputeHash(stream)
                Return Convert.ToHexString(hash)
            End Using
        End Using
    End Function

    Public Function GetCachedResult(fileName As String, currentHash As String) As String
        If _index.TryGetValue(fileName, entry) Then
            If entry.FileHash = currentHash AndAlso File.Exists(entry.CachePath) Then
                entry.LastAccessed = DateTime.UtcNow
                SaveIndex()
                Return File.ReadAllText(entry.CachePath)
            End If
        End If
        Return Nothing
    End Function

    Public Sub CacheResult(fileName As String, fileHash As String, result As String)
        Dim cachePath As String = Path.Combine(_cacheFolder, $"{Path.GetFileNameWithoutExtension(fileName)}-{fileHash.Substring(0, 8)}.txt")
        File.WriteAllText(cachePath, result)

        _index(fileName) = New CacheEntry With {
            .FileHash = fileHash,
            .CachePath = cachePath,
            .CreatedAt = DateTime.UtcNow,
            .LastAccessed = DateTime.UtcNow
        }

        SaveIndex()
    End Sub

End Class

Public Class CacheEntry

    Public Property FileHash As String = ""
    Public Property CachePath As String = ""
    Public Property CreatedAt As DateTime
    Public Property LastAccessed As DateTime

End Class
2026'da GPT-5 ve Claude Sonnet 4.5 ayrıca tekrar eden kalıplar için etkili jeton tüketimini %50-90 oranında azaltabilen otomatik istem önbellekleme özelliğine de sahiptir. Bu, büyük ölçekli operasyonlar için önemli bir maliyet tasarrufudur.
Gerçek Dünyada Kullanım Durumları
Hukuki Keşif ve Sözleşme Analizi
Hukuki keşif, geleneksel olarak yüz binlerce sayfayı manuel olarak inceleyen junior avukatlar gerektirir. Yapay zeka destekli keşif bu süreci dönüştürerek ilgili belgelerin hızlı bir şekilde tanımlanmasını, otomatik ayrıcalık incelemesini ve önemli delilsel gerçeklerin çıkarılmasını sağlar.
IronPDF'in AI entegrasyonu, ayrıcalık tespiti, önem derecelendirmesi, sorun tanımlama ve kilit tarih çıkarımı gibi sofistike hukuki iş akışlarına imkan tanır. Hukuk firmaları keşif inceleme sürelerini %70-80 oranında azaltarak daha büyük davaları daha küçük ekiplerle ele alabilmektedir.
2026'da gelişmiş doğruluk ve azalmış yanılsama oranlarıyla GPT-5 ve Claude Sonnet 4.5, hukuk profesyonellerinin giderek daha kritik kararlar için yapay zeka destekli analize güvenmelerini sağlar.
Finansal Rapor Analizi
Finansal analistler kazanç raporları, SEC belgeleri ve analiz sunumlarından veri çıkarmak için büyük zaman harcarlar. Yapay zeka destekli finansal belge işleme bu çıkarmayı otomatikleştirerek analistlerin veri toplama yerine yoruma odaklanmasını sağlar.
Bu örnek, birden fazla 10-K dokümanını işleyerek pdf.Query() kullanır ve CompanyFinancials JSON şeması ile şirketler arasında gelir, marjlar ve risk faktörlerini çıkarır ve karşılaştırır.
using IronPdf;using IronPdf.AI;using Microsoft.SemanticKernel;using Microsoft.SemanticKernel.Memory;using Microsoft.SemanticKernel.Connectors.OpenAI;using System.Collections.Generic;using System.Text.Json;using System.Text;// Compare financial metrics across multiple company filings for sector analysis// Azure OpenAI configurationstring azureEndpoint = "https://your-resource.openai.azure.com/";string apiKey = "your-azure-api-key";string chatDeployment = "gpt-4o";string embeddingDeployment = "text-embedding-ada-002";// Initialize Semantic Kernelvar kernel = Kernel.CreateBuilder() .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) .Build();var memory = new MemoryBuilder() .WithMemoryStore(new VolatileMemoryStore()) .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) .Build();IronDocumentAI.Initialize(kernel, memory);// Analyze company filingsstring[] companyFilings = { "filings/company-a-10k.pdf", "filings/company-b-10k.pdf", "filings/company-c-10k.pdf"};var sectorData = new List<CompanyFinancials>();foreach (string filing in companyFilings){Console.WriteLine($"Analyzing: {Path.GetFileName(filing)}"); var pdf = PdfDocument.FromFile(filing); // Define JSON schema for 10-K extraction (numbers in millions USD) string extractionQuery = @"Extract key financial metrics from this 10-K filing. Return JSON:mpanyName"": ""string"",scalYear"": ""string"",venue"": number,venueGrowth"": number,ossMargin"": number,eratingMargin"": number,tIncome"": number,s"": number,talDebt"": number,shPosition"": number,ployeeCount"": number,yRisks"": [""string""],idance"": ""string""in millions USD. Growth/margins as percentages.NLY valid JSON."; string result = await pdf.Query(extractionQuery); try { var financials = JsonSerializer.Deserialize<CompanyFinancials>(result); if (financials != null) sectorData.Add(financials); } catch {Console.WriteLine($" Warning: Could not parse financials for {filing}"); }}// Generate sector comparison reportvar report = new StringBuilder();report.AppendLine("=== Sector Analysis Report ===\n");report.AppendLine("Revenue Comparison (millions USD):");foreach (var company in sectorData.OrderByDescending(c => c.Revenue)) report.AppendLine($" {company.CompanyName}: ${company.Revenue:N0} ({company.RevenueGrowth:+0.0;-0.0}% YoY)");report.AppendLine("\nProfitability Margins:");foreach (var company in sectorData.OrderByDescending(c => c.OperatingMargin)) report.AppendLine($" {company.CompanyName}: {company.GrossMargin:F1}% gross, {company.OperatingMargin:F1}% operating");report.AppendLine("\nFinancial Health (Debt vs Cash):");foreach (var company in sectorData){ double netDebt = company.TotalDebt - company.CashPosition; string status = netDebt < 0 ? "Net Cash" : "Net Debt"; report.AppendLine($" {company.CompanyName}: {status} ${Math.Abs(netDebt):N0}M");}string reportText = report.ToString();Console.WriteLine($"\n{reportText}");File.WriteAllText("sector-analysis-report.txt", reportText);// Save full JSON datastring outputJson = JsonSerializer.Serialize(sectorData, new JsonSerializerOptions { WriteIndented = true });File.WriteAllText("sector-analysis.json", outputJson);Console.WriteLine("Analysis saved to sector-analysis.json and sector-analysis-report.txt");s CompanyFinancialspublic stringCompanyName { get; set; } = "";public stringFiscalYear { get; set; } = "";public doubleRevenue { get; set; }public doubleRevenueGrowth { get; set; }public doubleGrossMargin { get; set; }public doubleOperatingMargin { get; set; }public doubleNetIncome { get; set; }public doubleEps { get; set; }public doubleTotalDebt { get; set; }public doubleCashPosition { get; set; }public intEmployeeCount { get; set; }publicList<string> KeyRisks { get; set; } = new();public stringGuidance { get; set; } = "";
using IronPdf;
using IronPdf.AI;
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Memory;
using Microsoft.SemanticKernel.Connectors.OpenAI;
using System.Collections.Generic;
using System.Text.Json;
using System.Text;

// Compare financial metrics across multiple company filings for sector analysis

// Azure OpenAI configuration
string azureEndpoint = "https://your-resource.openai.azure.com/";
string apiKey = "your-azure-api-key";
string chatDeployment = "gpt-4o";
string embeddingDeployment = "text-embedding-ada-002";

// Initialize Semantic Kernel
var kernel = Kernel.CreateBuilder()
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey)
    .Build();

var memory = new MemoryBuilder()
    .WithMemoryStore(new VolatileMemoryStore())
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey)
    .Build();

IronDocumentAI.Initialize(kernel, memory);

// Analyze company filings
string[] companyFilings = {
    "filings/company-a-10k.pdf",
    "filings/company-b-10k.pdf",
    "filings/company-c-10k.pdf"
};

var sectorData = new List<CompanyFinancials>();

foreach (string filing in companyFilings)
{
    Console.WriteLine($"Analyzing: {Path.GetFileName(filing)}");

    var pdf = PdfDocument.FromFile(filing);

    // Define JSON schema for 10-K extraction (numbers in millions USD)
    string extractionQuery = @"Extract key financial metrics from this 10-K filing. Return JSON:

mpanyName"": ""string"",
scalYear"": ""string"",
venue"": number,
venueGrowth"": number,
ossMargin"": number,
eratingMargin"": number,
tIncome"": number,
s"": number,
talDebt"": number,
shPosition"": number,
ployeeCount"": number,
yRisks"": [""string""],
idance"": ""string""


in millions USD. Growth/margins as percentages.
NLY valid JSON.";

    string result = await pdf.Query(extractionQuery);

    try
    {
        var financials = JsonSerializer.Deserialize<CompanyFinancials>(result);
        if (financials != null)
            sectorData.Add(financials);
    }
    catch
    {
        Console.WriteLine($"  Warning: Could not parse financials for {filing}");
    }
}

// Generate sector comparison report
var report = new StringBuilder();
report.AppendLine("=== Sector Analysis Report ===\n");

report.AppendLine("Revenue Comparison (millions USD):");
foreach (var company in sectorData.OrderByDescending(c => c.Revenue))
    report.AppendLine($"  {company.CompanyName}: ${company.Revenue:N0} ({company.RevenueGrowth:+0.0;-0.0}% YoY)");

report.AppendLine("\nProfitability Margins:");
foreach (var company in sectorData.OrderByDescending(c => c.OperatingMargin))
    report.AppendLine($"  {company.CompanyName}: {company.GrossMargin:F1}% gross, {company.OperatingMargin:F1}% operating");

report.AppendLine("\nFinancial Health (Debt vs Cash):");
foreach (var company in sectorData)
{
    double netDebt = company.TotalDebt - company.CashPosition;
    string status = netDebt < 0 ? "Net Cash" : "Net Debt";
    report.AppendLine($"  {company.CompanyName}: {status} ${Math.Abs(netDebt):N0}M");
}

string reportText = report.ToString();
Console.WriteLine($"\n{reportText}");
File.WriteAllText("sector-analysis-report.txt", reportText);

// Save full JSON data
string outputJson = JsonSerializer.Serialize(sectorData, new JsonSerializerOptions { WriteIndented = true });
File.WriteAllText("sector-analysis.json", outputJson);

Console.WriteLine("Analysis saved to sector-analysis.json and sector-analysis-report.txt");


s CompanyFinancials

public string CompanyName { get; set; } = "";
public string FiscalYear { get; set; } = "";
public double Revenue { get; set; }
public double RevenueGrowth { get; set; }
public double GrossMargin { get; set; }
public double OperatingMargin { get; set; }
public double NetIncome { get; set; }
public double Eps { get; set; }
public double TotalDebt { get; set; }
public double CashPosition { get; set; }
public int EmployeeCount { get; set; }
public List<string> KeyRisks { get; set; } = new();
public string Guidance { get; set; } = "";
ImportsIronPdfImportsIronPdf.AIImportsMicrosoft.SemanticKernelImportsMicrosoft.SemanticKernel.MemoryImportsMicrosoft.SemanticKernel.Connectors.OpenAIImportsSystem.Collections.GenericImportsSystem.Text.JsonImportsSystem.TextImportsSystem.IO' Compare financial metrics across multiple company filings for sector analysis' Azure OpenAI configurationDim azureEndpoint AsString = "https://your-resource.openai.azure.com/"Dim apiKey AsString = "your-azure-api-key"Dim chatDeployment AsString = "gpt-4o"Dim embeddingDeployment AsString = "text-embedding-ada-002"' Initialize Semantic KernelDim kernel = Kernel.CreateBuilder() _ .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _ .Build()Dim memory = New MemoryBuilder() _ .WithMemoryStore(New VolatileMemoryStore()) _ .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _ .Build()IronDocumentAI.Initialize(kernel, memory)' Analyze company filingsDim companyFilings AsString() = { "filings/company-a-10k.pdf", "filings/company-b-10k.pdf", "filings/company-c-10k.pdf"}Dim sectorData = New List(OfCompanyFinancials)()For Each filing AsStringIn companyFilingsConsole.WriteLine($"Analyzing: {Path.GetFileName(filing)}") Dim pdf = PdfDocument.FromFile(filing) ' Define JSON schema for 10-K extraction (numbers in millions USD) Dim extractionQuery AsString = "Extract key financial metrics from this 10-K filing. Return JSON:mpanyName"": ""string"",scalYear"": ""string"",venue"": number,venueGrowth"": number,ossMargin"": number,eratingMargin"": number,tIncome"": number,s"": number,talDebt"": number,shPosition"": number,ployeeCount"": number,yRisks"": [""string""],idance"": ""string""in millions USD. Growth/margins as percentages.NLY valid JSON." Dim result AsString = Await pdf.Query(extractionQuery)Try Dim financials = JsonSerializer.Deserialize(OfCompanyFinancials)(result) If financials IsNot Nothing Then sectorData.Add(financials) End IfCatchConsole.WriteLine($" Warning: Could not parse financials for {filing}")EndTryNext' Generate sector comparison reportDim report = New StringBuilder()report.AppendLine("=== Sector Analysis Report ===" & vbCrLf)report.AppendLine("Revenue Comparison (millions USD):")For Each company In sectorData.OrderByDescending(Function(c) c.Revenue) report.AppendLine($" {company.CompanyName}: ${company.Revenue:N0} ({company.RevenueGrowth:+0.0;-0.0}% YoY)")Nextreport.AppendLine(vbCrLf & "Profitability Margins:")For Each company In sectorData.OrderByDescending(Function(c) c.OperatingMargin) report.AppendLine($" {company.CompanyName}: {company.GrossMargin:F1}% gross, {company.OperatingMargin:F1}% operating")Nextreport.AppendLine(vbCrLf & "Financial Health (Debt vs Cash):")For Each company In sectorData Dim netDebt AsDouble = company.TotalDebt - company.CashPosition Dim status AsString = If(netDebt < 0, "Net Cash", "Net Debt") report.AppendLine($" {company.CompanyName}: {status} ${Math.Abs(netDebt):N0}M")NextDim reportText AsString = report.ToString()Console.WriteLine(vbCrLf & reportText)File.WriteAllText("sector-analysis-report.txt", reportText)' Save full JSON dataDim outputJson AsString = JsonSerializer.Serialize(sectorData, New JsonSerializerOptionsWith {.WriteIndented = True})File.WriteAllText("sector-analysis.json", outputJson)Console.WriteLine("Analysis saved to sector-analysis.json and sector-analysis-report.txt")Public Class CompanyFinancials Public Property CompanyNameAsString = "" Public Property FiscalYearAsString = "" Public Property RevenueAsDouble Public Property RevenueGrowthAsDouble Public Property GrossMarginAsDouble Public Property OperatingMarginAsDouble Public Property NetIncomeAsDouble Public Property EpsAsDouble Public Property TotalDebtAsDouble Public Property CashPositionAsDouble Public Property EmployeeCountAsInteger Public Property KeyRisksAsList(OfString) = New List(OfString)() Public Property GuidanceAsString = ""End Class
Imports IronPdf
Imports IronPdf.AI
Imports Microsoft.SemanticKernel
Imports Microsoft.SemanticKernel.Memory
Imports Microsoft.SemanticKernel.Connectors.OpenAI
Imports System.Collections.Generic
Imports System.Text.Json
Imports System.Text
Imports System.IO

' Compare financial metrics across multiple company filings for sector analysis

' Azure OpenAI configuration
Dim azureEndpoint As String = "https://your-resource.openai.azure.com/"
Dim apiKey As String = "your-azure-api-key"
Dim chatDeployment As String = "gpt-4o"
Dim embeddingDeployment As String = "text-embedding-ada-002"

' Initialize Semantic Kernel
Dim kernel = Kernel.CreateBuilder() _
    .AddAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .AddAzureOpenAIChatCompletion(chatDeployment, azureEndpoint, apiKey) _
    .Build()

Dim memory = New MemoryBuilder() _
    .WithMemoryStore(New VolatileMemoryStore()) _
    .WithAzureOpenAITextEmbeddingGeneration(embeddingDeployment, azureEndpoint, apiKey) _
    .Build()

IronDocumentAI.Initialize(kernel, memory)

' Analyze company filings
Dim companyFilings As String() = {
    "filings/company-a-10k.pdf",
    "filings/company-b-10k.pdf",
    "filings/company-c-10k.pdf"
}

Dim sectorData = New List(Of CompanyFinancials)()

For Each filing As String In companyFilings
    Console.WriteLine($"Analyzing: {Path.GetFileName(filing)}")

    Dim pdf = PdfDocument.FromFile(filing)

    ' Define JSON schema for 10-K extraction (numbers in millions USD)
    Dim extractionQuery As String = "Extract key financial metrics from this 10-K filing. Return JSON:

mpanyName"": ""string"",
scalYear"": ""string"",
venue"": number,
venueGrowth"": number,
ossMargin"": number,
eratingMargin"": number,
tIncome"": number,
s"": number,
talDebt"": number,
shPosition"": number,
ployeeCount"": number,
yRisks"": [""string""],
idance"": ""string""


in millions USD. Growth/margins as percentages.
NLY valid JSON."

    Dim result As String = Await pdf.Query(extractionQuery)

    Try
        Dim financials = JsonSerializer.Deserialize(Of CompanyFinancials)(result)
        If financials IsNot Nothing Then
            sectorData.Add(financials)
        End If
    Catch
        Console.WriteLine($"  Warning: Could not parse financials for {filing}")
    End Try
Next

' Generate sector comparison report
Dim report = New StringBuilder()
report.AppendLine("=== Sector Analysis Report ===" & vbCrLf)

report.AppendLine("Revenue Comparison (millions USD):")
For Each company In sectorData.OrderByDescending(Function(c) c.Revenue)
    report.AppendLine($"  {company.CompanyName}: ${company.Revenue:N0} ({company.RevenueGrowth:+0.0;-0.0}% YoY)")
Next

report.AppendLine(vbCrLf & "Profitability Margins:")
For Each company In sectorData.OrderByDescending(Function(c) c.OperatingMargin)
    report.AppendLine($"  {company.CompanyName}: {company.GrossMargin:F1}% gross, {company.OperatingMargin:F1}% operating")
Next

report.AppendLine(vbCrLf & "Financial Health (Debt vs Cash):")
For Each company In sectorData
    Dim netDebt As Double = company.TotalDebt - company.CashPosition
    Dim status As String = If(netDebt < 0, "Net Cash", "Net Debt")
    report.AppendLine($"  {company.CompanyName}: {status} ${Math.Abs(netDebt):N0}M")
Next

Dim reportText As String = report.ToString()
Console.WriteLine(vbCrLf & reportText)
File.WriteAllText("sector-analysis-report.txt", reportText)

' Save full JSON data
Dim outputJson As String = JsonSerializer.Serialize(sectorData, New JsonSerializerOptions With {.WriteIndented = True})
File.WriteAllText("sector-analysis.json", outputJson)

Console.WriteLine("Analysis saved to sector-analysis.json and sector-analysis-report.txt")

Public Class CompanyFinancials
    Public Property CompanyName As String = ""
    Public Property FiscalYear As String = ""
    Public Property Revenue As Double
    Public Property RevenueGrowth As Double
    Public Property GrossMargin As Double
    Public Property OperatingMargin As Double
    Public Property NetIncome As Double
    Public Property Eps As Double
    Public Property TotalDebt As Double
    Public Property CashPosition As Double
    Public Property EmployeeCount As Integer
    Public Property KeyRisks As List(Of String) = New List(Of String)()
    Public Property Guidance As String = ""
End Class
Yatırım firmaları, analistlerin daha geniş piyasa kapsama alanını izlemesine ve ortaya çıkan fırsatlara daha hızlı yanıt vermelerine olanak tanıyan AI destekli analizi kullanarak her gün binlerce belgesini işleyebilir.
Araştırma Makalesi Özeti
Akademik araştırmalar her yıl milyonlarca makale üretir. Yapay zeka destekli özetleme, araştırmacıların makale önemini hızla değerlendirmelerine, anahtar bulguları anlamalarına ve detaylı okumayı gerektiren makaleleri tanımlamalarına yardımcı olur. Etkili araştırma özeti, araştırma sorusunu tanımlamalı, metodolojiyi açıklamalı, uygun uyarılarla birlikte anahtar bulguları özetlemeli ve sonuçları bağlam içinde yerleştirmelidir.
Araştırma kurumları, kurumsal bilgi tabanlarını sürdürmek, yeni yayınları otomatik olarak işlemek için AI özetlemesini kullanır. 2026'da GPT-5'in geliştirilmiş bilimsel muhakemesi ve Claude Sonnet 4.5'in geliştirilmiş analitik yetenekleriyle, akademik özetleme yeni doğruluk seviyelerine ulaşır.
Hükümet Belgesi İşleme
Hükümet kurumları düzenlemeler, kamu yorumları, çevresel etki beyanları, dava dosyaları ve denetim raporları gibi devasa belge koleksiyonları üretir. AI destekli belge işleme, düzenleyici uyum analizi, çevresel etki değerlendirmesi ve yasama takibi yoluyla hükümet bilgilerinin harekete geçirilebilir hale gelmesini sağlar.
Kamusal yorum analizi, benzersiz zorluklar sunar - büyük düzenleyici öneriler yüz binlerce yorum alabilir. Yapay zeka sistemleri, yorumları konuya göre kategorize edebilir, ortak temaları belirleyebilir, koordineli kampanyaları tespit edebilir ve kurum yanıtını gerektiren özlü argümanları çıkarabilir.
2026 yapay zeka modelleri nesli, hükümet belgesi işlemeye benzersiz yetenekler getirerek demokratik şeffaflığı ve bilgili politika yapımını destekler.
Hata Ayıklama ve Teknik Destek
Yaygın Hatalar Üzerinde Hızlı Çözümler
Yavaş ilk render mı? Normal. Chrome 2-3 saniyede başlatılır, sonra hızlanır.
Bulut sorunları mı? En azından Azure B1 veya eşdeğer kaynakları kullanın.
Eksik varlıklar mı? Temel yolları ayarlayın veya base64 olarak yerleştirin.
Eksik öğeler mi? JavaScript yürütümü için RenderDelay ekleyin.
Bellek sorunları mı? Performans düzeltmeleri için en son IronPDF sürümüne güncelleyin.
Form alanı sorunları mı? Benzersiz adlar sağlayın ve en son sürüme güncelleyin.
IronPDF'i Geliştiren Mühendislerden 7/24 Yardım Alın
IronPDF, 7/24 mühendis desteği sunar. HTML'den PDF'e dönüştürme veya yapay zeka entegrasyonu ile ilgili sorun mu yaşıyorsunuz? Bizimle iletişime geçin:
Yapay zeka güçlendirilmiş PDF işlemesini anladığınıza göre, bir sonraki adım IronPDF'in daha geniş yeteneklerini keşfetmektir. OpenAI entegrasyon kılavuzu, özetleme, sorgulama ve ezberleme desenleri hakkında derinlemesine bilgi sağlarken, metin ve resim çıkarma eğitimi PDF'leri yapay zeka analiz öncesi nasıl ön işleyeceğinizi gösterir. Belge montaj iş akışları için toplu işleme için PDF'leri birleştirme ve ayırmayı öğrenin.
AI özelliklerinin ötesine geçmeye hazır olduğunuzda, tam PDF düzenleme eğitimi su damgası, üstbilgi, altbilgi, formlar ve not eklemeler kapsamaktadır. Alternatif yapay zeka entegrasyon yaklaşımları için, ChatGPT C# eğitimi farklı desenleri gösterir. Üretim dağıtımı, WebApps ve Fonksiyonlar için Azure dağıtım kılavuzunda ve HTML, URL'ler ve ham içerikten PDF oluşturmayı kapsayan C# PDF oluşturma eğitiminde ele alınır.
Başlamaya hazır mısınız? Ücretsiz 30 günlük denemenizi başlatın Üretimde su damgaları olmadan test etmek için esnek lisanslama ile ekibinizle ölçeklenir. Yapay zeka entegrasyonu veya herhangi bir IronPDF özelliği ile ilgili sorularınız için mühendislik destek ekibimiz size yardımcı olmaktadır.
Sıkça Sorulan Sorular
C#'ta PDF işlemede AI kullanmanın faydaları nelerdir?
C#'ta AI güdümlü PDF işleme, belge özetleme, veriyi JSON'a çıkarma ve Soru-Cevap sistemleri geliştirmeyi içeren gelişmiş beceriler sağlar. Büyük hacimli belgeleri ele alırken verimliliği ve doğruluğu artırır.
IronPDF belgeleri özetlemek için AI'yı nasıl entegre eder?
IronPDF, AI'yı GPT-5 ve Claude gibi modelleri kullanarak entegre eder, bu da belgeleri analiz edip özetleyebilmemizi sağlar, büyük metinleri hızlıca kavramamızı ve içgörüler elde etmemizi kolaylaştırır.
AI güçlendirilmiş PDF işlemeyde RAG kalıplarının rolü nedir?
RAG (Retrieve and Generate) kalıpları, bilgi almanın ve üretmenin kalitesini artırmak için AI destekli PDF işlemeyde kullanılır, daha doğru ve bağlamsal olarak alakalı belge analizine olanak tanır.
IronPDF ile PDF'lerden yapılandırılmış veri nasıl çıkarılabilir?
IronPDF, veri entegrasyonunu ve analizi farklı uygulamalar ve sistemler arasında kolaylaştırarak PDF'lerden yapılandırılmış veriyi JSON gibi formatlara çıkarma imkanı tanır.
IronPDF, AI ile geniş belge kütüphanelerini yönetebilir mi?
Evet, IronPDF, OpenAI ve Azure OpenAI entegrasyonları ile iyi ölçeklenerek özetleme ve veri çıkarma gibi görevleri otomatikleştirerek geniş belge kütüphanelerini verimli bir şekilde işleyebilir.
IronPDF tarafından PDF işlemeyde desteklenen AI modelleri nelerdir?
IronPDF, genel işleme yeteneklerini artırmak için belge özetleme ve Soru-Cevap sistemi kurma gibi görevlerde kullanılan GPT-5 ve Claude gibi gelişmiş AI modellerini destekler.
IronPDF, Soru-Cevap sistemi kurmayı nasıl kolaylaştırır?
IronPDF, dokümanı işlemleyip analiz ederek alakalı bilgileri çıkarmak suretiyle Soru-Cevap sistemi kurulmasına yardımcı olur, böylece kullanıcı sorgularına doğru yanıtlar üretebilir.
C#'ta AI destekli PDF işlemenin ana kullanım alanları nelerdir?
Ana kullanım alanları arasında belge özetleme, yapılandırılmış veri çıkarma, Soru-Cevap sistemleri geliştirme ve AI entegrasyonları ile OpenAI gibi büyük ölçekli belge işlem görevleri ele alma yer alıyor.
Belgeleri işlemek için IronPDF'i Azure OpenAI ile kullanmak mümkün mü?
Evet, IronPDF, PDF belgelerini özetleme, çıkarma ve analiz etme için Azure OpenAI ile birleştirilerek belge işleme görevlerini geliştirebilir.
IronPDF AI ile belge analizini nasıl geliştirebilir?
IronPDF, görevleri otomatikleştirip geliştiren AI modellerini kullanarak özetleme, veri çıkarma ve bilgi alma gibi görevleri geliştirir, bu da daha verimli ve doğru bir belge yönetimine yol açar.
Ahmad, C#, Python ve web teknolojilerinde sağlam bir temele sahip bir full-stack geliştiricidir. Gerçek dünyadaki uygulamalarda ölçeklenebilir yazılım çözümleri oluşturmaktan ve tasarım ile işlevselliğin nasıl buluştuğunu keşfetmekten derin bir ilgi duyar.


 NuGet ile yükleyin