# Adicionando Marcadores com ExtractTextFromPage
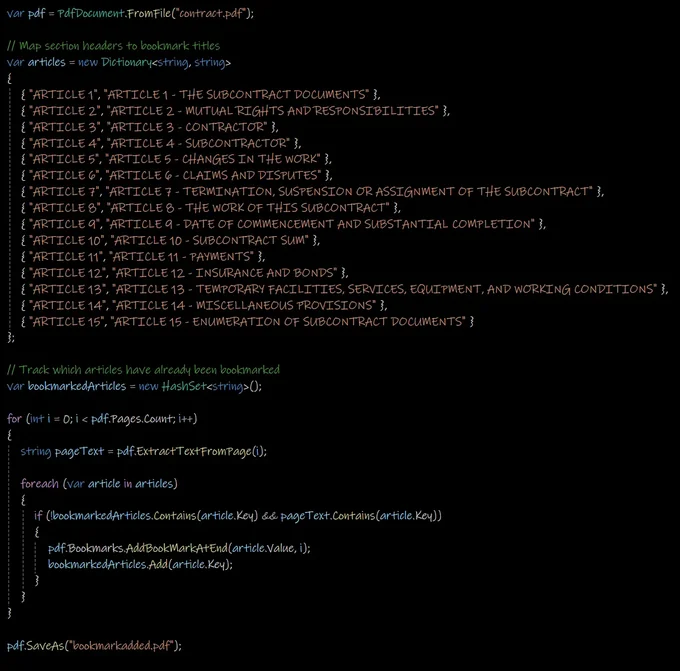
Quando você adiciona marcadores com base no conteúdo do texto, procurar com a propriedade `Pages.Lines` pode falhar porque o texto retornado volta desordenado ou fora de ordem, então uma pesquisa baseada em título nunca corresponde. Extrair o texto da página com `ExtractTextFromPage()` lê cada página na ordem lógica e lhe dá uma string confiável para busca.
[[i:(Na versão 2026.5.x e acima, use a classe `LinkAnnotation` em vez. Ela tem suporte embutido para links clicáveis que navegam para uma página e posição específicas, e é a abordagem recomendada quando disponível.)]]
`Pages.Lines` reconstrói o texto conforme aparece visualmente na página. Isso quebra quando o texto é desenhado em uma ordem não linear, quando fontes ou codificações personalizadas estão em jogo, ou quando o PDF foi gerado a partir de HTML ou uma ferramenta de terceiros com um layout complexo. O resultado é um texto incompleto ou desordenado que não pode ser pesquisado de forma confiável.
## Solução
### 1. Leia cada página com `ExtractTextFromPage()`
Extraia o texto embutido bruto de cada página em vez da reconstrução visual. `ExtractTextFromPage()` retorna o conteúdo da página na ordem lógica de leitura, o que torna a pesquisa por cabeçalhos muito mais confiável em diferentes estruturas de PDF.
### 2. Percorra cada página e marque cada cabeçalho único
Percorra todas as páginas para que nenhuma seção seja perdida, independentemente de onde ela esteja, e registre quais cabeçalhos você já viu para que cada um seja marcado apenas uma vez. Um `HashSet` é uma maneira limpa de desduplicar: dado um documento com seções intituladas `"ARTICLE 1"`, `"ARTICLE 2"` e assim por diante, garante um único marcador por artigo.
A saída é um conjunto de marcadores apontando para cada cabeçalho especificado, mesmo quando o PDF é originado de uma fonte HTML dinâmica ou possui formatação complexa.
Quando você adiciona marcadores com base no conteúdo do texto, procurar com a propriedade Pages.Lines pode falhar porque o texto retornado volta desordenado ou fora de ordem, então uma pesquisa baseada em título nunca corresponde. Extrair o texto da página com ExtractTextFromPage() lê cada página na ordem lógica e lhe dá uma string confiável para busca.
Observe: Na versão 2026.5.x e acima, use a classe LinkAnnotation em vez. Ela tem suporte embutido para links clicáveis que navegam para uma página e posição específicas, e é a abordagem recomendada quando disponível.
Pages.Lines reconstrói o texto conforme aparece visualmente na página. Isso quebra quando o texto é desenhado em uma ordem não linear, quando fontes ou codificações personalizadas estão em jogo, ou quando o PDF foi gerado a partir de HTML ou uma ferramenta de terceiros com um layout complexo. O resultado é um texto incompleto ou desordenado que não pode ser pesquisado de forma confiável.
Solução
1. Leia cada página com ExtractTextFromPage()
Extraia o texto embutido bruto de cada página em vez da reconstrução visual. ExtractTextFromPage() retorna o conteúdo da página na ordem lógica de leitura, o que torna a pesquisa por cabeçalhos muito mais confiável em diferentes estruturas de PDF.
2. Percorra cada página e marque cada cabeçalho único
Percorra todas as páginas para que nenhuma seção seja perdida, independentemente de onde ela esteja, e registre quais cabeçalhos você já viu para que cada um seja marcado apenas uma vez. Um HashSet é uma maneira limpa de desduplicar: dado um documento com seções intituladas "ARTICLE 1", "ARTICLE 2" e assim por diante, garante um único marcador por artigo.
A saída é um conjunto de marcadores apontando para cada cabeçalho especificado, mesmo quando o PDF é originado de uma fonte HTML dinâmica ou possui formatação complexa.
Curtis Chau é bacharel em Ciência da Computação (Universidade Carleton) e se especializa em desenvolvimento front-end, com experiência em Node.js, TypeScript, JavaScript e React. Apaixonado por criar interfaces de usuário intuitivas e esteticamente agradáveis, Curtis gosta de trabalhar com frameworks modernos e criar manuais bem estruturados e visualmente atraentes.






